


Link kanoniczny (rel=”canonical”) to znacznik w sekcji <head>, którym mówisz Google, który z kilku adresów z tą samą treścią jest wersją główną. Google traktuje go jako silną wskazówkę, a nie polecenie: zwykle ją respektuje, ale gdy inne sygnały – przekierowania, mapa witryny, linki wewnętrzne – wskazują co innego, wybiera stronę kanoniczną sam. Dlatego canonical działa dobrze tylko wtedy, gdy wszystkie sygnały w serwisie mówią to samo.
W tym poradniku wyjaśniamy, jak Google wybiera stronę kanoniczną, kiedy canonical ma sens, a kiedy lepsze jest przekierowanie 301 albo noindex, jakie błędy najczęściej psują kanonizację i jak to wszystko sprawdzić w Google Search Console. Pokazujemy też, jak wygląda kanonizacja na semgence.pl – na prawdziwych zrzutach z GSC, łącznie z przypadkiem, przez który powstał ten tekst: dwa nasze wpisy o canonical konkurowały ze sobą o te same frazy.
Czym jest link kanoniczny (rel=”canonical”)?
Link kanoniczny to element HTML, który dodaje się w sekcji <head> strony. Wygląda tak:
<link rel="canonical" href="https://www.twojadomena.pl/kategoria/buty-damskie/" />Znacznik mówi wyszukiwarce: treść, którą widzisz pod tym adresem, ma swoją wersję główną pod adresem z atrybutu href. To ta wersja powinna trafić do indeksu i wyświetlać się w wynikach. Strona z canonical wskazującym na inny adres nadal działa normalnie – użytkownik może na nią wejść, przeglądać ją i kupować. Canonical zmienia tylko to, który adres Google pokazuje w wynikach i na który adres zbiera sygnały, takie jak linki.
Mechanizm ogłosiły wspólnie Google, Yahoo i Microsoft w lutym 2009 roku jako odpowiedź na plagę duplikatów w sklepach i serwisach z parametrami w adresach. W grudniu tego samego roku Google rozszerzył obsługę na canonical między różnymi domenami. Od tego czasu podstawa się nie zmieniła, zmieniło się za to otoczenie: więcej sygnałów, więcej JavaScriptu i systemy AI, które korzystają z tego, co Google uzna za stronę kanoniczną.
Canonical można też przekazać w nagłówku HTTP. To jedyny sposób dla plików, które nie mają sekcji <head>, na przykład PDF-ów:
Link: <https://www.twojadomena.pl/cennik/>; rel="canonical"Według dokumentacji Google o wskazywaniu adresu kanonicznego nagłówek działa wyłącznie w wyszukiwarce internetowej. Google radzi też, żeby wybrać jedną metodę – znacznik w HTML albo nagłówek – bo łączenie obu łatwiej prowadzi do błędów.
Czym różni się wskazówka od dyrektywy?
To najważniejsza rzecz, jaką trzeba zrozumieć o canonical. Dyrektywa to polecenie, które wyszukiwarka wykonuje – tak działa na przykład noindex. Wskazówka to sugestia, którą wyszukiwarka bierze pod uwagę razem z innymi informacjami. Dokumentacja Google o kanonizacji mówi wprost, że wskazanie preferowanej strony kanonicznej to „hint, not a rule”.
W praktyce oznacza to, że canonical można przegłosować. Jeśli ustawisz canonical na adres A, ale w mapie witryny masz adres B, linki wewnętrzne prowadzą do B, a A zwraca przekierowanie, Google ma przed sobą cztery sprzeczne sygnały i wybierze ten adres, który według niego lepiej reprezentuje treść. Nie zawsze będzie to ten, na którym Ci zależy.
Jak Google wybiera stronę kanoniczną?
Kanonizacja dzieje się na etapie indeksowania. Google najpierw grupuje strony, które mają taką samą lub bardzo podobną treść, w jeden klaster. Potem z każdego klastra wybiera jeden adres jako reprezentanta – stronę kanoniczną. Ten adres jest skanowany najczęściej i to on pojawia się w wynikach. Pozostałe adresy z klastra są skanowane rzadziej i nie wyświetlają się w wyszukiwarce.
Przy wyborze Google bierze pod uwagę wiele sygnałów. Dokumentacja wymienia wprost cztery: czy strona działa przez HTTPS, przekierowania, obecność adresu w mapie witryny i znacznik rel="canonical". Siłę tych sygnałów opisuje tak: przekierowanie to silny sygnał, canonical to silny sygnał, mapa witryny to sygnał słaby. Z innych źródeł wiadomo, że lista jest dłuższa – Patrick Stox z Ahrefs przytacza wypowiedź Allana Scotta z zespołu indeksowania Google o około 40 sygnałach wyboru strony kanonicznej. Wśród nich są linki wewnętrzne i zewnętrzne, hreflang, PageRank, krótsze adresy zamiast dłuższych i to, gdzie treść pojawiła się po raz pierwszy.
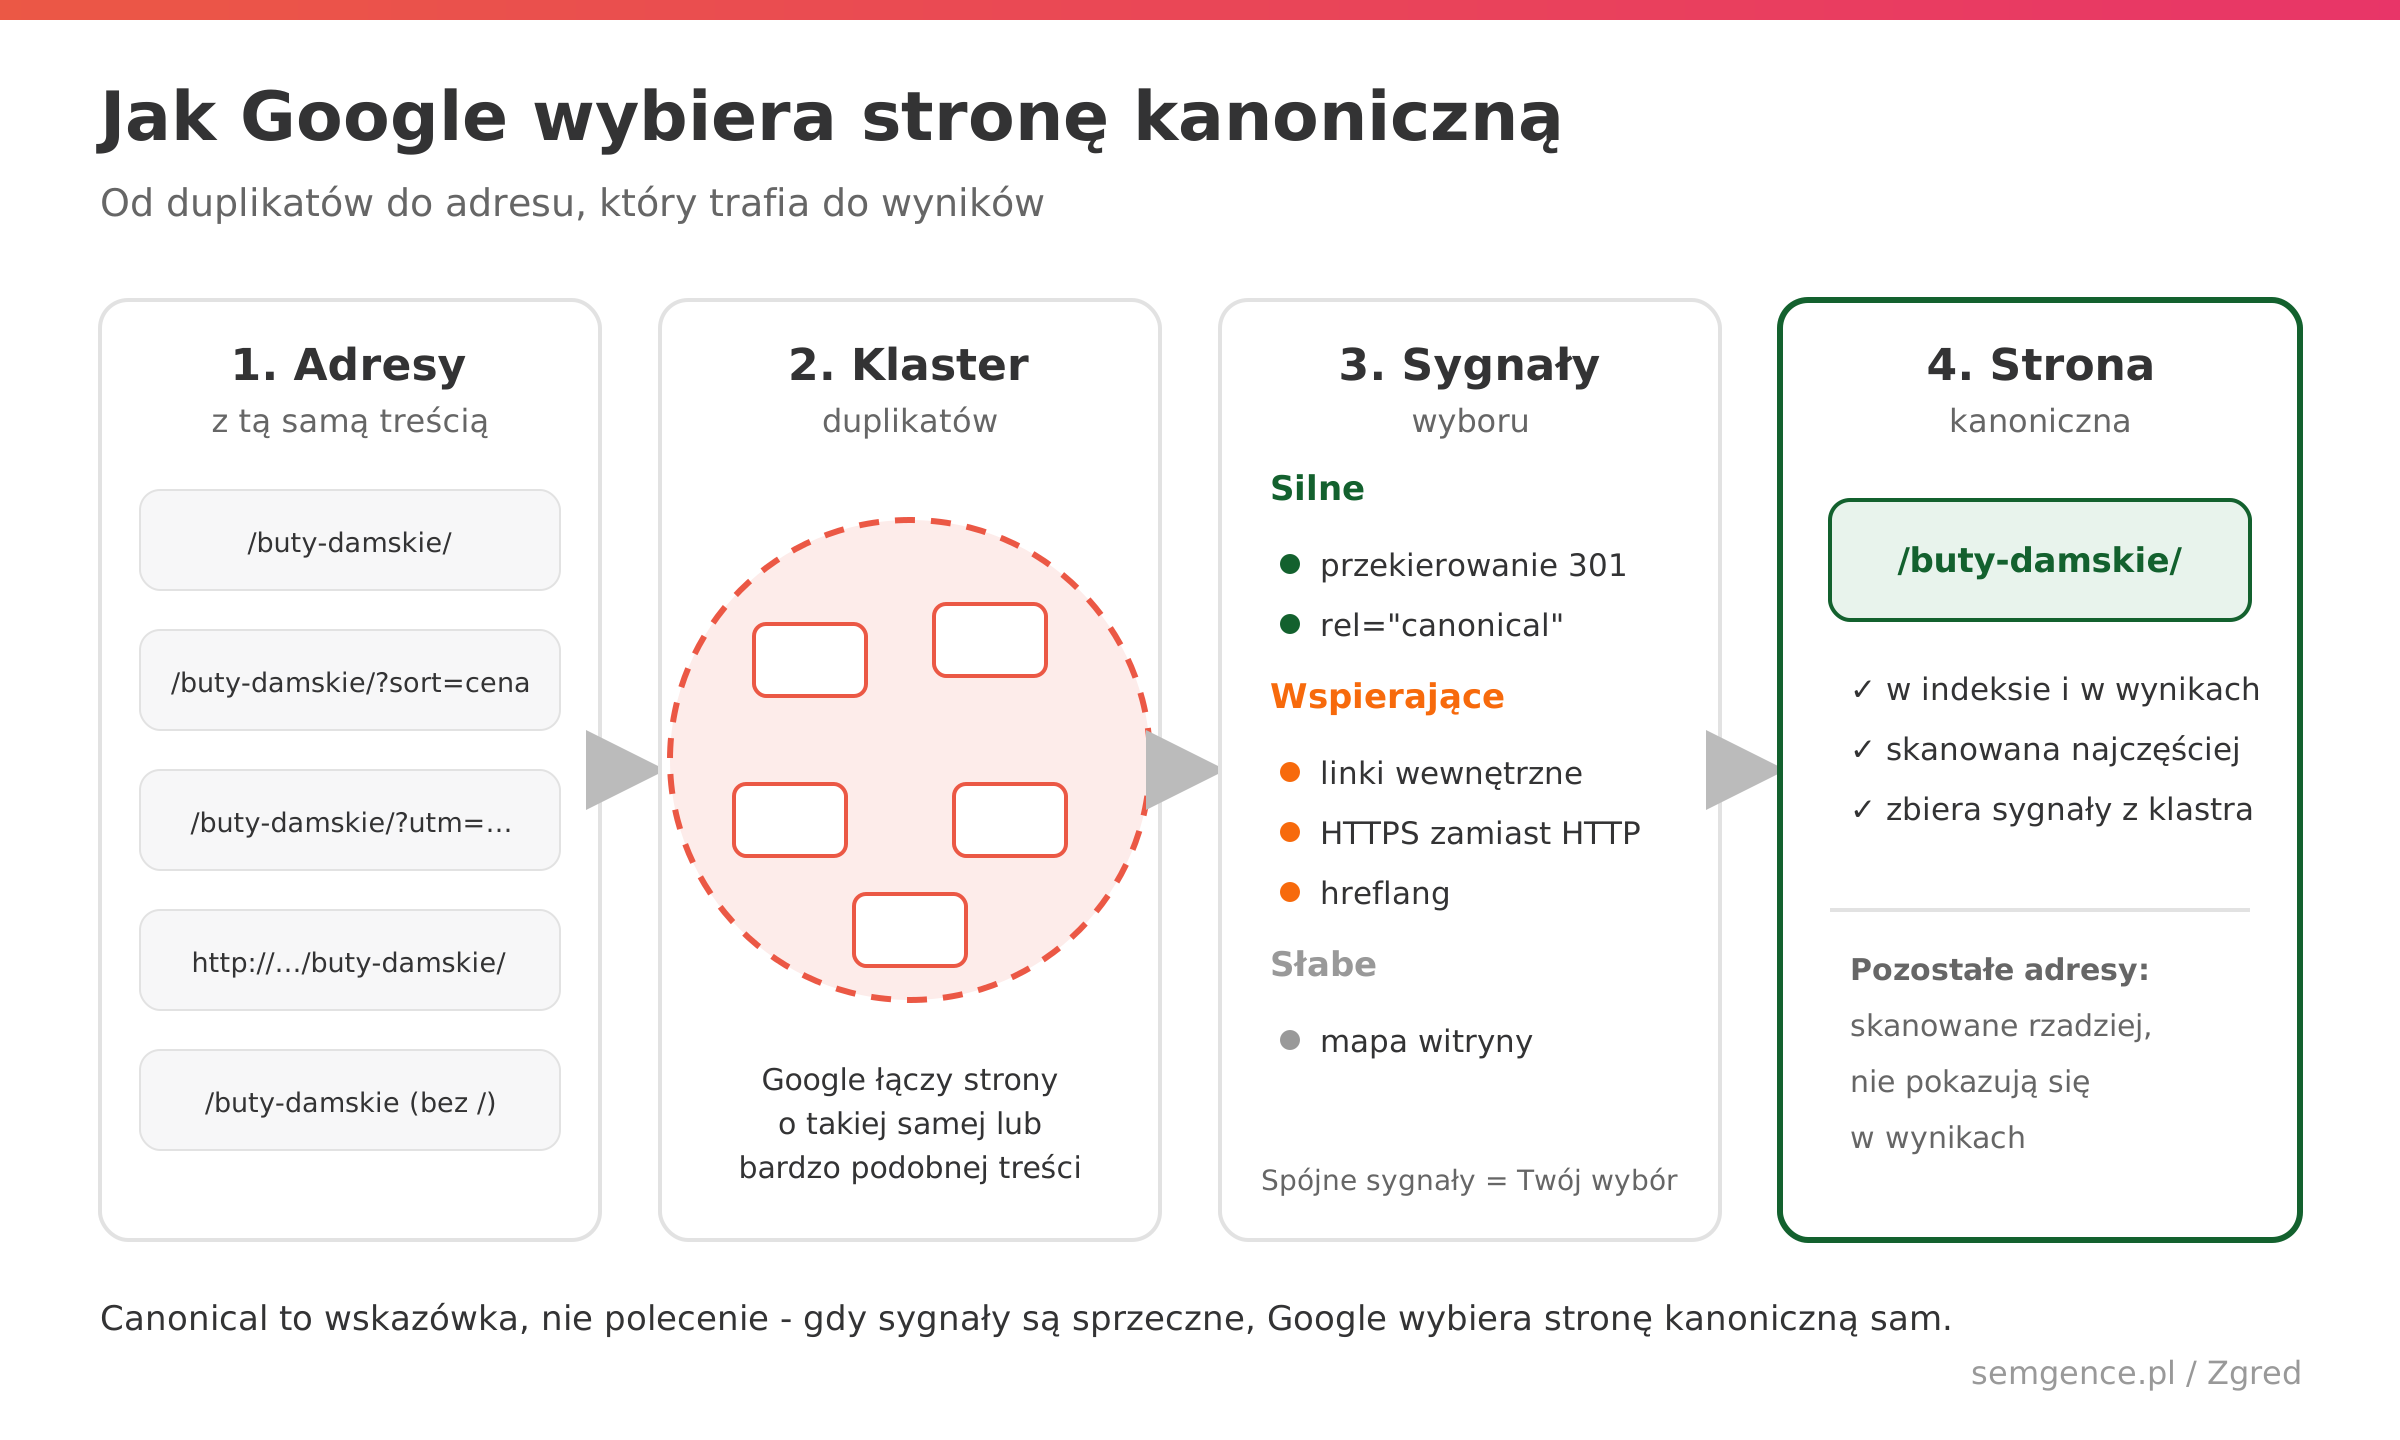
Ciekawego materiału dostarczył w kwietniu 2026 roku John Mueller. Odpowiadając na pytanie na Reddicie, opisał sytuacje, w których Google uznaje różne strony za duplikaty i łączy je w jeden klaster. Search Engine Journal zebrał je w dziewięć scenariuszy. Oprócz oczywistych przypadków – identycznych stron i dużego wspólnego fragmentu treści – są wśród nich takie, które łatwo przeoczyć:
- strony z małą ilością unikalnej treści w porównaniu z powtarzalnymi elementami szablonu, czyli menu, stopką i bocznymi blokami;
- wzorce parametrów w adresach, które Google uogólnia – jeśli wiele adresów z danym parametrem okazało się duplikatami, kolejne mogą zostać potraktowane tak samo;
- porównywanie wersji mobilnej, a nie desktopowej;
- strona, którą dostaje Googlebot, a nie użytkownik – na przykład ekran weryfikacji przeglądarki albo ogólny komunikat błędu;
- JavaScript, który się nie wyrenderował, przez co różne strony wyglądają dla Google jak ta sama pusta skorupa HTML.
Dwa ostatnie punkty mają bardzo praktyczne konsekwencje. We wrześniu 2026 roku Mueller komentował przypadek, w którym strony wypadły z wyszukiwarki, a jako ich stronę kanoniczną Google pokazywał zupełnie obcą domenę. Jego wyjaśnienie: Googlebot mógł na kilku niezwiązanych serwisach dostać ten sam ogólny błąd JavaScriptu i uznać te strony za duplikaty. Poradził regularnie sprawdzać kluczowe strony w narzędziu do sprawdzania adresów URL, w wersji na żywo – tak opisał to serwis TechWyse. Wniosek dla każdego, kto ma ochronę przed botami na serwerze: jeśli Googlebot zamiast treści dostaje stronę z weryfikacją, kanonizacja może się rozjechać, zanim ktokolwiek to zauważy.
Kiedy stosować canonical?
Canonical stosujesz wtedy, gdy ta sama lub prawie ta sama treść musi być dostępna pod kilkoma adresami, a Ty chcesz, żeby w wynikach był tylko jeden z nich. Jeśli drugi adres nie musi istnieć, lepsze jest przekierowanie – o tym w kolejnej sekcji. Oto sytuacje, w których canonical jest właściwym narzędziem.
Parametry w adresach. Sortowanie, filtrowanie, wyszukiwanie wewnętrzne, identyfikatory sesji i parametry kampanii, takie jak utm_source, gclid czy fbclid, tworzą nowe adresy z tą samą treścią. Adresu z parametrem kampanii nie przekierujesz, bo stracisz dane do analityki. Wystarczy, że strona docelowa ma canonical wskazujący na czysty adres. Na semgence.pl mamy dokładnie taki przypadek – opisujemy go niżej.
Warianty produktów. Ten sam produkt w kilku kolorach albo rozmiarach często ma osobne adresy, a opisy różnią się jednym słowem. Jeśli warianty nie mają osobnego popytu w wyszukiwarce, canonical na wersję główną porządkuje indeks. Jeśli ludzie szukają konkretnego wariantu, na przykład „sukienka zielona rozmiar 40”, warto zostawić mu własny canonical i dopracować jego treść, żeby się czymś realnie różnił.
Self-referencing canonical, czyli canonical wskazujący na samą stronę. Każda strona, która ma się indeksować, powinna mieć canonical na samą siebie. Zabezpiecza to przed duplikatami, których nie planowałeś: adresami z parametrami dopisanymi przez kogoś z zewnątrz, wersjami z dużymi literami czy ukośnikiem na końcu. Google wprost zaleca dodawanie takiego znacznika na stronie kanonicznej. WordPress z Rank Math albo Yoast SEO robi to automatycznie.
Syndykacja treści. Jeśli Twój artykuł jest przedrukowany na innej stronie, przedruk może mieć canonical wskazujący na oryginał w Twojej domenie. To tak zwany cross-domain canonical. Działa jednak tylko wtedy, gdy wydawca przedruku się na to zgodzi i faktycznie ustawi znacznik. Treść na obu stronach musi być taka sama lub bardzo podobna.
Wersje językowe – tu canonical nie jest odpowiedzią. Polska i angielska wersja strony to nie duplikaty, tylko tłumaczenia. Łączy się je atrybutem hreflang, a każda wersja ma canonical na samą siebie. Google przypomina, że canonical z atrybutami hreflang, lang, media czy type jest przy kanonizacji ignorowany. Gdy masz wersje w tym samym języku dla różnych krajów, na przykład dla Polski i Niemiec po polsku, Google może je potraktować jako duplikaty. Glenn Gabe opisał przypadek dużego serwisu, w którym Google zrobił to z milionami adresów. Wyniki dla użytkowników w danym kraju nadal były właściwe dzięki hreflang, ale Search Console przypisał ruch do adresów kanonicznych i wyglądało to jak spadek w jednym z krajów.
Paginacja – też nie. Częsty błąd to canonical z drugiej, trzeciej i kolejnych stron listingu na stronę pierwszą. Google mówi wprost, że pierwszej strony serii nie należy używać jako strony kanonicznej – każda strona paginacji powinna mieć własny canonical (dokumentacja o paginacji). Inaczej produkty widoczne dopiero na dalszych stronach mają mniejszą szansę na odkrycie. Atrybutów rel="next" i rel="prev" Google już nie używa.
Canonical, przekierowanie 301 czy noindex – co wybrać?
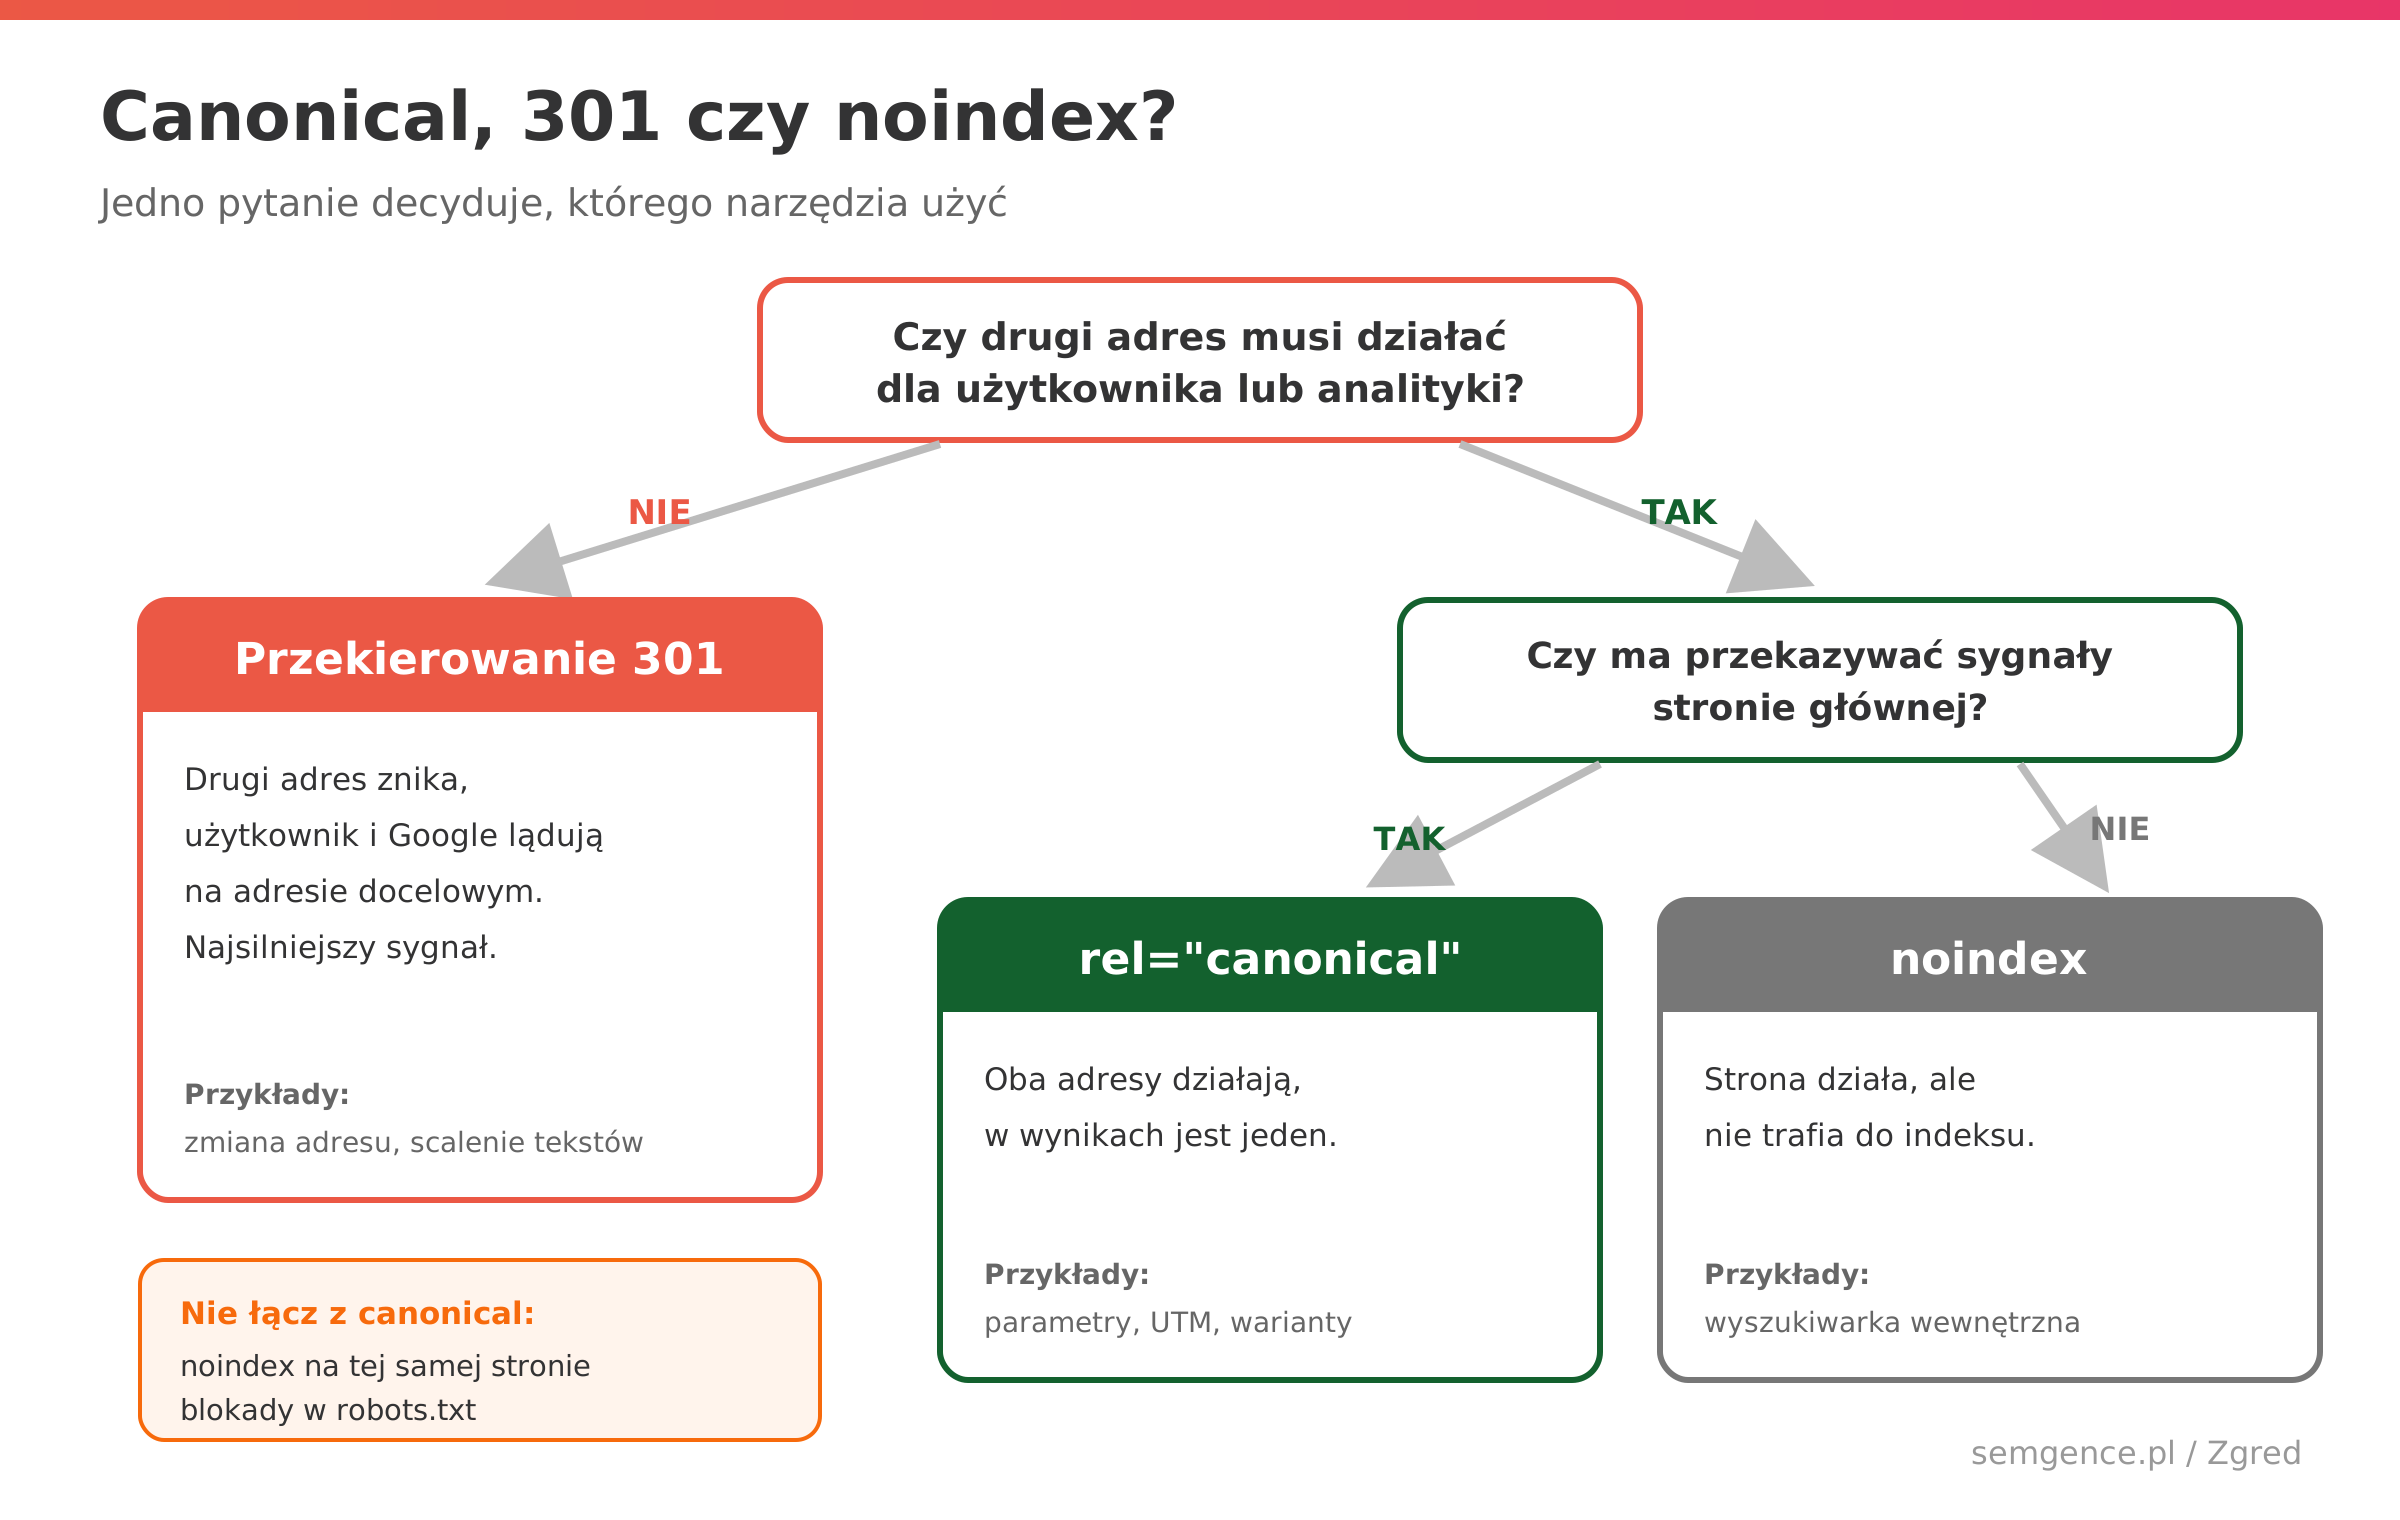
Wszystkie trzy narzędzia ograniczają duplikaty w wynikach, ale robią to w inny sposób. Wybór zależy od dwóch pytań: czy użytkownik powinien móc otworzyć drugi adres i czy ten adres ma przekazywać sygnały stronie głównej.
| Canonical | Przekierowanie 301 | Noindex | |
|---|---|---|---|
| Drugi adres działa dla użytkownika | Tak | Nie – przenosi na adres docelowy | Tak |
| Drugi adres w wynikach | Nie | Nie | Nie |
| Sygnały przechodzą na stronę główną | Tak (wskazówka) | Tak | Nie |
| Jak traktuje to Google | Silna wskazówka | Silny sygnał | Polecenie wykluczenia z indeksu |
| Typowe zastosowanie | Parametry, UTM, warianty, syndykacja | Zmiana adresu, HTTPS, scalenie tekstów | Wyszukiwarka wewnętrzna, strony techniczne |
Przekierowanie 301 stosujesz, gdy drugi adres nie musi istnieć: przy zmianie adresu, przenosinach na HTTPS lub inną domenę albo przy scalaniu dwóch tekstów o tym samym. To najsilniejszy sygnał kanonizacji – użytkownik i Google lądują od razu na adresie docelowym. Szczegóły wdrożenia opisujemy w poradniku o przekierowaniu 301.
Canonical stosujesz, gdy oba adresy muszą działać – z powodów technicznych, analitycznych albo dla wygody użytkownika – ale w wynikach ma być jeden.
Noindex stosujesz, gdy strona ma w ogóle nie trafić do indeksu i nie musi przekazywać sygnałów innemu adresowi. Przykładem są wyniki wyszukiwania wewnętrznego czy strony techniczne. Google wprost odradza używanie noindex do wybierania strony kanonicznej w obrębie jednego serwisu, bo noindex całkowicie blokuje stronę w wyszukiwarce.
Dwóch rzeczy nie łączy się z canonical. Pierwsza to blokada w robots.txt: jeśli Googlebot nie może pobrać strony, nie zobaczy też jej znacznika canonical, a adres i tak może trafić do indeksu – bez treści. Druga to noindex na tej samej stronie: canonical mówi „ta strona to kopia innej, przekaż jej sygnały”, a noindex mówi „usuń tę stronę z indeksu”. To sprzeczne komunikaty i nie wiesz, który z nich Google uzna za ważniejszy.
Jakie błędy z canonical popełnia się najczęściej?
W 2013 roku Allan Scott z zespołu indeksowania Google opisał na oficjalnym blogu pięć najczęstszych błędów z rel=canonical. Ponad dziesięć lat później wciąż widzimy je w audytach, więc warto zacząć od nich:
- Canonical z dalszych stron paginacji na stronę pierwszą. Treść z dalszych stron wypada z indeksu.
- Adres bezwzględny zapisany jak względny. Canonical bez protokołu, na przykład
www.domena.pl/strona, Google może odczytać jako ścieżkę w obrębie bieżącej strony i zignorować. Używaj zawsze pełnych adresów zhttps://. - Kilka znaczników canonical na jednej stronie. Zdarza się, gdy canonical dodaje jednocześnie motyw i wtyczka SEO albo gdy szablon kopiuje znacznik z innej strony. Przy kilku sprzecznych canonicalach Google może zignorować wszystkie.
- Canonical z kategorii na wyróżniony artykuł lub produkt. Kategoria przestaje się wtedy pokazywać w wynikach, bo Google traktuje ją jako kopię tego artykułu.
- Canonical w sekcji
<body>. Znacznik jest brany pod uwagę tylko w<head>. Trafia do<body>, gdy jakiś skrypt albo niedomknięty element HTML przenosi go poza nagłówek.
Do tej listy dopisalibyśmy kilka błędów, które dziś spotykamy równie często:
- Canonical na adres, który przekierowuje albo zwraca błąd. Strona kanoniczna powinna odpowiadać kodem 200. Canonical na adres z przekierowaniem 301 albo na stronę 404 to sprzeczny sygnał – Google zwykle wybiera wtedy stronę kanoniczną sam.
- Inny adres w canonical, inny w mapie witryny. Google wymienia to wśród rzeczy, których nie należy robić: nie wskazuj różnych stron kanonicznych różnymi metodami.
- Linki wewnętrzne do adresów niekanonicznych. Jeśli całe menu i linki w treści prowadzą do wersji z parametrem albo bez ukośnika na końcu, Google dostaje setki sygnałów przeciwko Twojemu canonical.
- Canonical z serwera testowego przeniesiony na produkcję. Po wdrożeniu nowej wersji wszystkie strony wskazują na
staging.domena.pl. W skrajnym przypadku serwis zaczyna znikać z indeksu, a w wynikach pojawiają się adresy z serwera testowego, jeśli jest dostępny dla robotów. - Canonical wstawiany przez JavaScript inny niż w HTML. Google czyta canonical zarówno ze źródła strony, jak i z wersji wyrenderowanej. Jeśli te dwie wartości się różnią, tworzysz sprzeczność, której łatwo nie zauważyć bez porównania obu wersji.
- Canonical na stronę z inną treścią. Na przykład wszystkie podstrony usług z canonical na stronę główną. Google widzi, że treść się nie zgadza, i ignoruje wskazówkę – a jeśli jej nie zignoruje, podstrony usług wypadają z wyników.
Jak sprawdzić canonical w Google Search Console?
Search Console to jedyne narzędzie, które pokazuje nie tylko to, co deklarujesz, ale też to, co wybrał Google. Sprawdzasz to w dwóch miejscach.
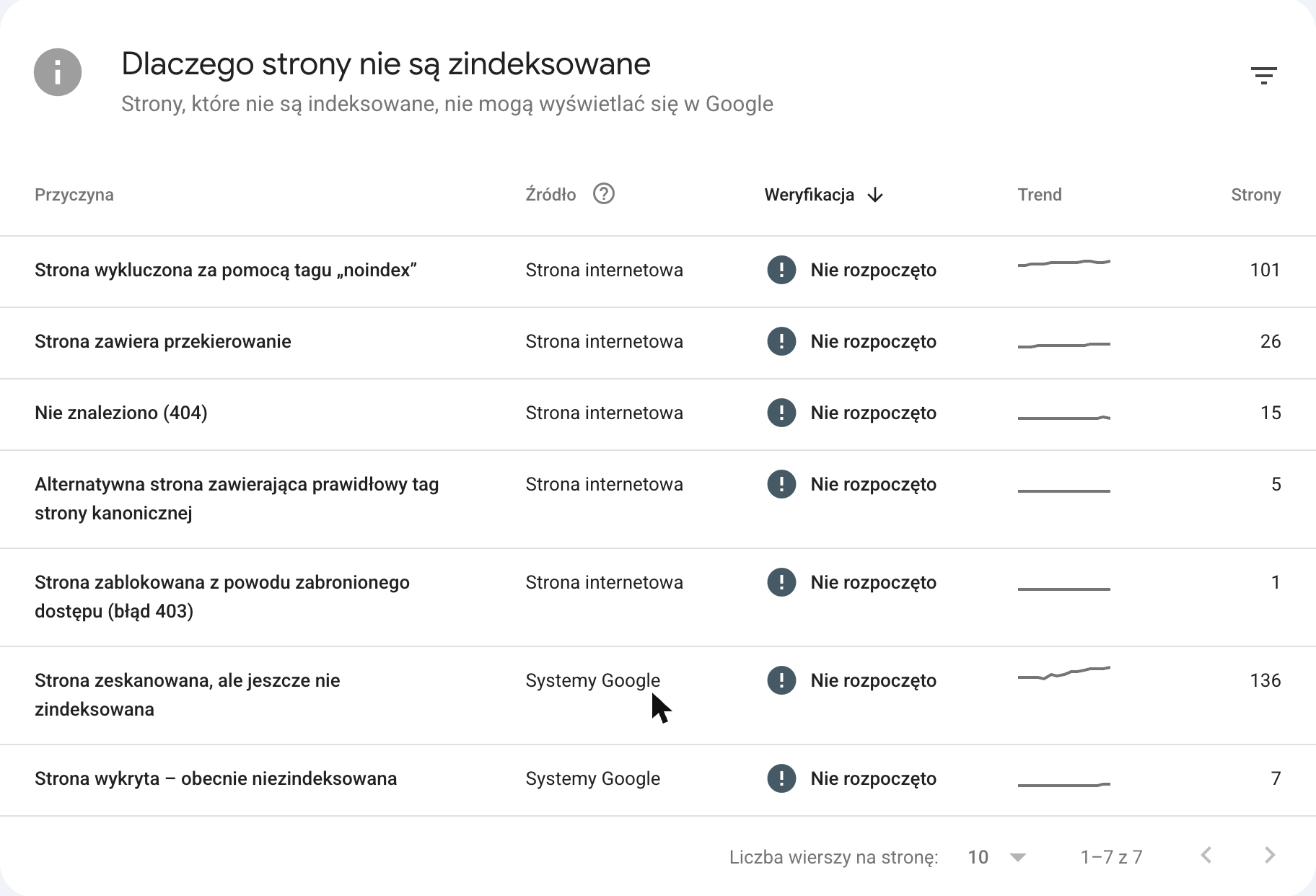
Raport Indeksowanie stron (w menu: Indeksowanie → Strony) grupuje adresy, które nie są w indeksie, według przyczyny. Z kanonizacją związane są trzy statusy – w polskiej wersji GSC brzmią tak:
- „Alternatywna strona zawierająca prawidłowy tag strony kanonicznej” – wszystko działa: strona wskazuje inny adres jako kanoniczny, a Google ten wybór przyjął. Nic nie trzeba robić.
- „Duplikat, użytkownik nie oznaczył strony kanonicznej” – strona jest duplikatem, nie ma canonical, więc Google sam wybrał wersję główną. Jeśli wybrał źle, dodaj canonical.
- „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik” – masz canonical, ale Google go nie posłuchał. To status, który zawsze wymaga sprawdzenia.
Nie każdy wpis w tym ostatnim statusie oznacza problem. Czasem Google łączy strony, które rzeczywiście są niemal identyczne, i wybiera tę, która ma więcej linków. Zawsze jednak warto zrozumieć, dlaczego Google zdecydował inaczej: czy strony są zbyt podobne, czy sygnały w serwisie są sprzeczne, czy Googlebot nie dostaje innej treści niż użytkownik.
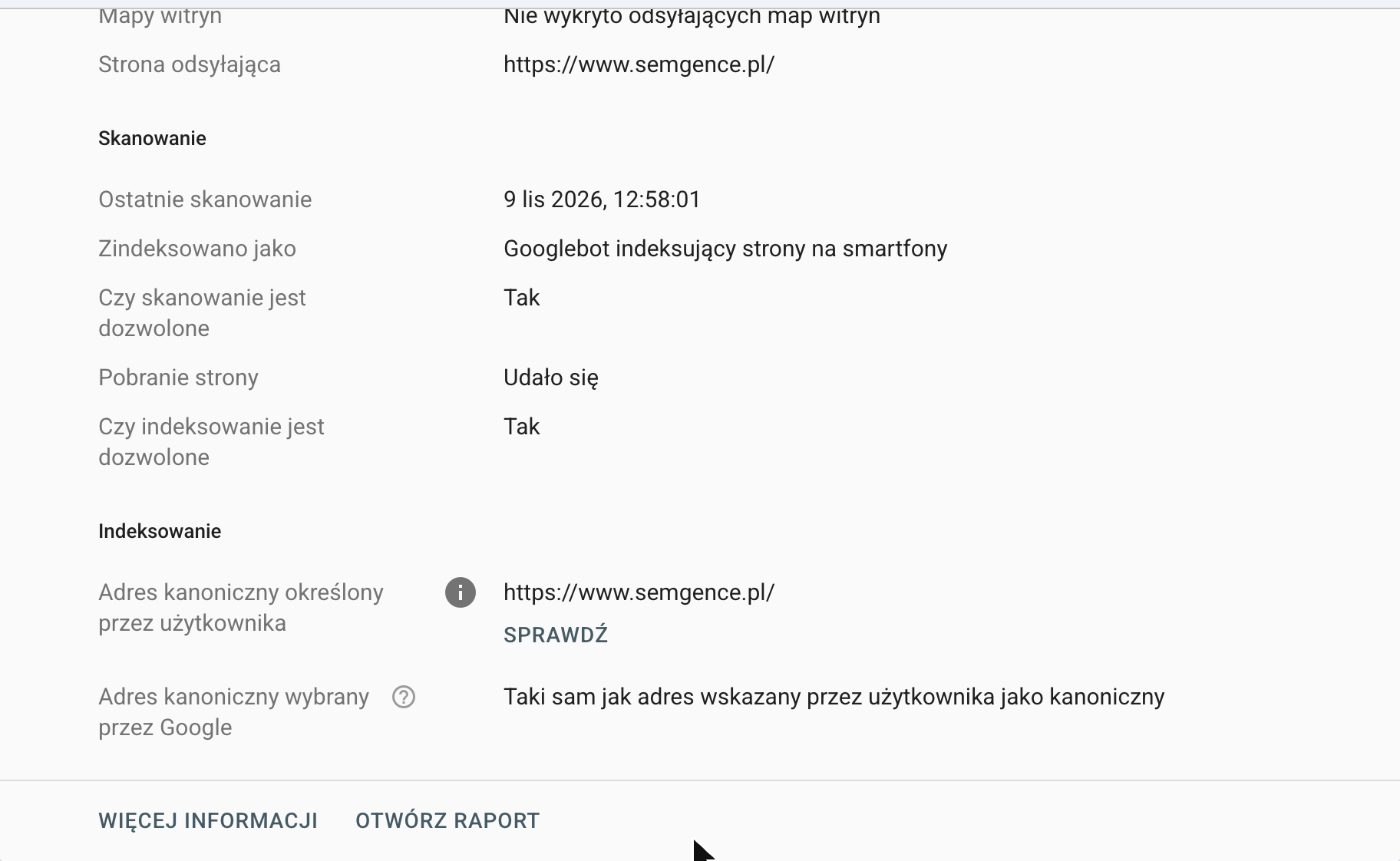
Narzędzie do sprawdzania adresów URL (pasek wyszukiwania na górze GSC) pokazuje dla pojedynczego adresu dwa pola: „Adres kanoniczny określony przez użytkownika” i „Adres kanoniczny wybrany przez Google”. Jeśli są takie same, Google przyjął Twoją wskazówkę. Jeśli się różnią – masz konkretny adres do diagnozy. Przycisk „Sprawdź URL wersji opublikowanej” pokazuje, co Googlebot dostaje w tej chwili, w tym wyrenderowany HTML i znacznik canonical po wykonaniu JavaScriptu.
Pamiętaj też, że raport Skuteczność przypisuje dane głównie do adresów kanonicznych. Jeśli Google połączy dwie strony w jeden klaster, kliknięcia i wyświetlenia drugiej mogą „przejść” na pierwszą – i wyglądać jak spadek ruchu jednej z nich, choć w wynikach nic się nie zmieniło. Więcej o diagnozowaniu indeksacji piszemy w tekście o tym, jak sprawdzić, czy strona jest zaindeksowana.
Co zrobić, gdy Google wybrał inną stronę kanoniczną?
Gdy w raporcie pojawi się status „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik”, nie zmieniaj od razu canonical na siłę. Przejdź po kolei przez kilka pytań – zwykle odpowiedź pojawia się w jednym z pierwszych kroków.
- Czy to w ogóle problem? Otwórz adres wybrany przez Google i porównaj go ze swoim. Jeśli to ta sama treść, a Google wybrał na przykład wersję bez parametru, której i tak chciałeś – wystarczy poprawić canonical, żeby wskazywał tę wersję.
- Czy strona kanoniczna odpowiada kodem 200? Sprawdź, czy adres z canonical nie przekierowuje, nie zwraca błędu i nie ma noindex. Każda z tych rzeczy osłabia Twoją wskazówkę.
- Czy wszystkie sygnały wskazują ten sam adres? Porównaj canonical z adresem w mapie witryny, z linkami w menu i w treści oraz z przekierowaniami. Jeśli linki wewnętrzne prowadzą do innej wersji, Google ma powód, żeby wybrać właśnie ją.
- Czy Googlebot widzi tę samą treść co użytkownik? Użyj testu na żywo w narzędziu do sprawdzania adresów URL i obejrzyj wyrenderowany HTML oraz zrzut ekranu. Jeśli Googlebot dostaje ekran weryfikacji, komunikat błędu albo pustą stronę bez wyrenderowanego JavaScriptu, różne adresy mogą wyglądać dla Google tak samo.
- Czy strony naprawdę się różnią? Jeśli dwie strony mają ten sam szablon i różnią się jednym zdaniem, Google ma prawo uznać je za duplikaty. Rozwiązaniem nie jest canonical, tylko treść, która odpowiada na inną potrzebę – albo scalenie stron.
- Czy wybór Google wynika z większej liczby linków? Jeśli do wersji wybranej przez Google prowadzi więcej linków zewnętrznych i wewnętrznych, rozważ przekierowanie 301 zamiast canonical albo zmianę wersji głównej na tę, którą Google już woli.
Po poprawkach poproś o ponowne zindeksowanie kluczowego adresu i obserwuj status w raporcie. Na dużych serwisach zmiana może być widoczna dopiero po kilku tygodniach, bo Google musi ponownie przeskanować wszystkie adresy z klastra.
Jak sprawdzić canonical w Screaming Frog i w kodzie strony?
GSC pokazuje stan z perspektywy Google, ale tylko dla adresów, które Google zna. Żeby sprawdzić cały serwis, potrzebny jest crawler.
W Screaming Frog SEO Spider zakładka Canonicals pokazuje między innymi strony bez canonical, z canonical na samą siebie, z canonical na inny adres, z kilkoma znacznikami canonical oraz z canonical wskazującym na stronę, która nie nadaje się do indeksu – przekierowanie, błąd albo noindex. Warto podłączyć Search Console przez API (Configuration → API Access) – wtedy obok deklarowanego canonical widzisz dane z GSC i szybciej wychwytujesz rozbieżności na dużych serwisach. Pełną listę rzeczy do sprawdzenia przy takim crawlu zebraliśmy w checkliście technicznego SEO.
Pojedynczą stronę sprawdzisz w przeglądarce: podgląd źródła (Ctrl+U, na Macu Cmd+Option+U) i wyszukanie słowa „canonical”. To pokazuje HTML przed wykonaniem JavaScriptu. Wersję po wyrenderowaniu zobaczysz w narzędziach deweloperskich (zakładka Elements) albo w GSC w „Sprawdź URL wersji opublikowanej”. Canonical przekazywany w nagłówku HTTP sprawdzisz poleceniem:
curl -I https://www.twojadomena.pl/plik.pdfi odszukasz w odpowiedzi linię zaczynającą się od Link:.
Jak wygląda kanonizacja na semgence.pl? Case study
Pokażemy, jak wygląda to w praktyce na naszym własnym serwisie. Dane pochodzą z Google Search Console dla semgence.pl – raport Indeksowanie stron według stanu na 6 listopada 2026 roku, a raport Skuteczność za trzy miesiące od 10 sierpnia do 8 listopada 2026 roku.
Pięć adresów, przy których canonical działa
W raporcie Indeksowanie stron semgence.pl ma 544 zindeksowane adresy i 291 niezindeksowanych. Wśród przyczyn braku indeksacji nie ma statusu „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik”. Jest za to pięć adresów ze statusem „Alternatywna strona zawierająca prawidłowy tag strony kanonicznej” – czyli takich, gdzie Google przyjął nasz wybór.
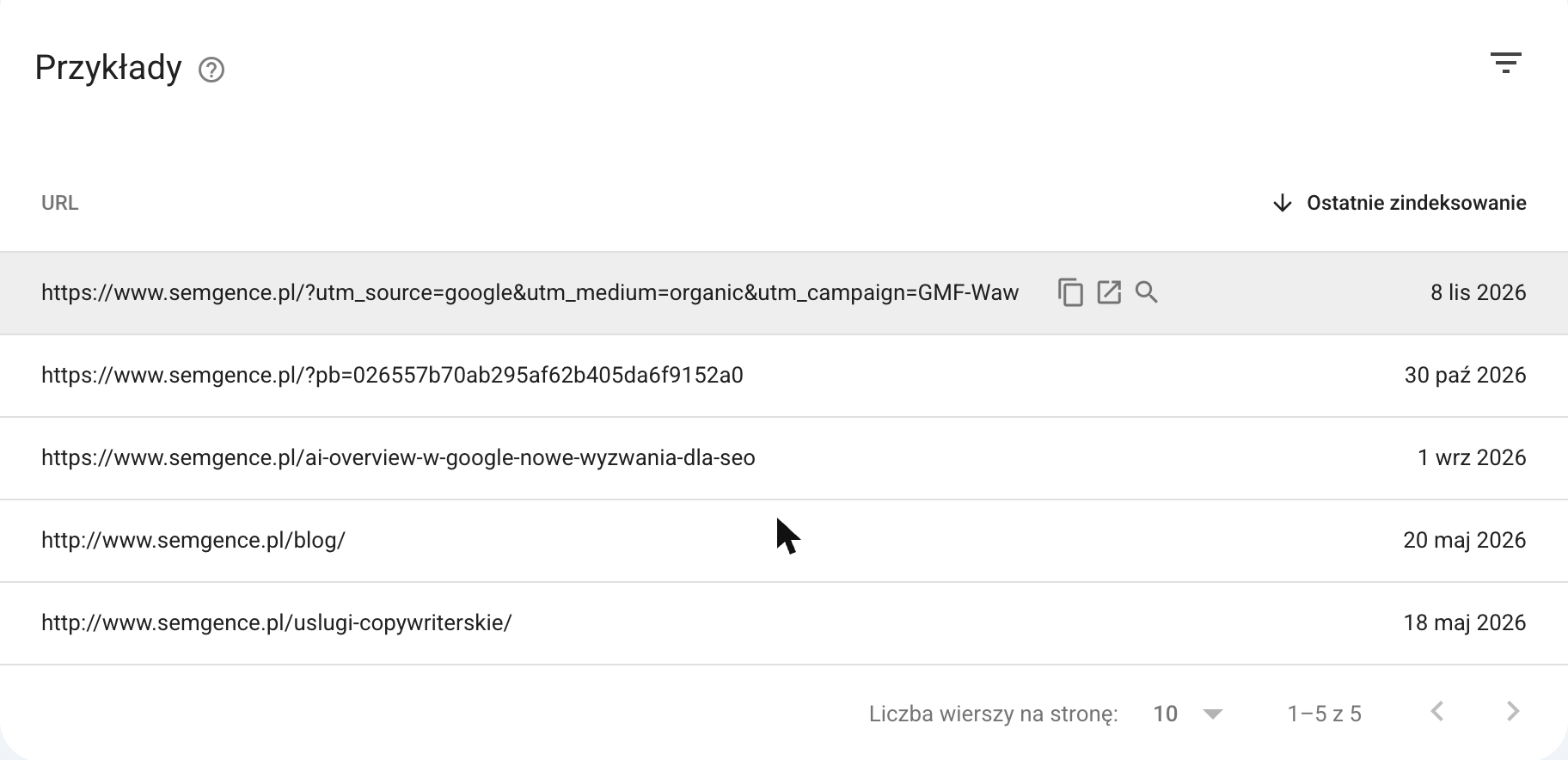
Każdy z tych pięciu adresów to inny typ duplikatu:
- adres strony głównej z parametrami UTM z Profilu Firmy w Google;
- adres strony głównej z parametrem
?pb=i losowym identyfikatorem; - adres wpisu bez ukośnika na końcu;
- dwa adresy w wersji
http://.
Adres z UTM z Profilu Firmy w Google
Link do strony w naszym Profilu Firmy w Google ma parametry kampanii: ?utm_source=google&utm_medium=organic&utm_campaign=GMF-Waw. Dzięki nim w Google Analytics odróżniamy ruch z profilu od ruchu z wyników organicznych. W raporcie Skuteczność ten adres ma w badanym okresie 4 655 wyświetleń i 24 kliknięcia – to ruch z wizytówki, która linkuje dokładnie pod ten adres.
Strona pod tym adresem zwraca kod 200 i ma canonical na https://www.semgence.pl/. Narzędzie do sprawdzania adresów URL potwierdza: adres kanoniczny określony przez użytkownika to strona główna, a adres kanoniczny wybrany przez Google jest „taki sam jak adres wskazany przez użytkownika jako kanoniczny”. Parametry UTM nie tworzą więc problemu z duplikacją, a my nie tracimy danych do analityki. Gdybyśmy zamiast tego ustawili przekierowanie z adresu z UTM na stronę główną, parametry zniknęłyby przed zapisaniem wizyty.
Adres z parametrem ?pb=
Drugi przypadek to adres https://www.semgence.pl/?pb=026557b70ab295af62b405da6f9152a0. Nie generujemy go w nawigacji serwisu – trafił do Google z zewnątrz. W raporcie Skuteczność ma 443 wyświetlenia i zero kliknięć. Ten adres też ma canonical na stronę główną i Google ten wybór przyjął.
Rozważaliśmy przekierowanie 301 dla wszystkich adresów z parametrem pb, ale zostaliśmy przy canonical. Przekierowanie wymagałoby reguły na serwerze dla parametru, którego pochodzenia nie kontrolujemy, i dawałoby ryzyko, że reguła złapie kiedyś adres, który powinien działać. Canonical rozwiązuje problem bez tego ryzyka, a GSC potwierdza, że Google go respektuje. To dobry przykład zasady: canonical sprawdza się przy duplikatach, które powstają poza Twoją kontrolą i których nie musisz usuwać.
Ten sam parametr Google znalazł też w adresie /page/22/?pb=..., czyli na dalszej stronie listy wpisów. Kolejne strony list mają u nas noindex, follow, więc taki adres trafia do statusu „wykluczona za pomocą tagu noindex”, a nie do duplikatów. To świadoma decyzja: zadaniem tych stron jest prowadzić robota do wpisów, a nie pojawiać się w wynikach.
Wersje http:// i adres bez ukośnika
Pozostałe trzy adresy to wersje, które od dawna przekierowują: https://www.semgence.pl/blog/ i https://www.semgence.pl/uslugi-copywriterskie/ odpowiadają przekierowaniem 301 na wersję https://, a adres wpisu bez ukośnika na końcu przekierowuje na wersję z ukośnikiem. W raporcie figurują jako „Alternatywna strona…”, bo tak je Google zapisał podczas ostatniego skanowania w maju i wrześniu 2026 roku. To przypomnienie, że raport Indeksowanie stron pokazuje stan z ostatniej wizyty robota na danym adresie, a nie bieżącą konfigurację serwera. Stan aktualny zawsze potwierdzisz testem na żywo w narzędziu do sprawdzania adresów URL.
Dwa wpisy o canonical, które konkurowały ze sobą
Ostatni przypadek jest najbardziej pouczający, bo nie dotyczy kodu, tylko treści. Do listopada 2026 roku na blogu Semgence były dwa wpisy o tym samym temacie: „Parametr canonical – czym jest oraz do czego służy” z 2022 roku i „Czym są linki kanoniczne i kiedy je stosować” z 2023 roku. Oba miały canonical na siebie, oba były zindeksowane i oba odpowiadały na te same zapytania.
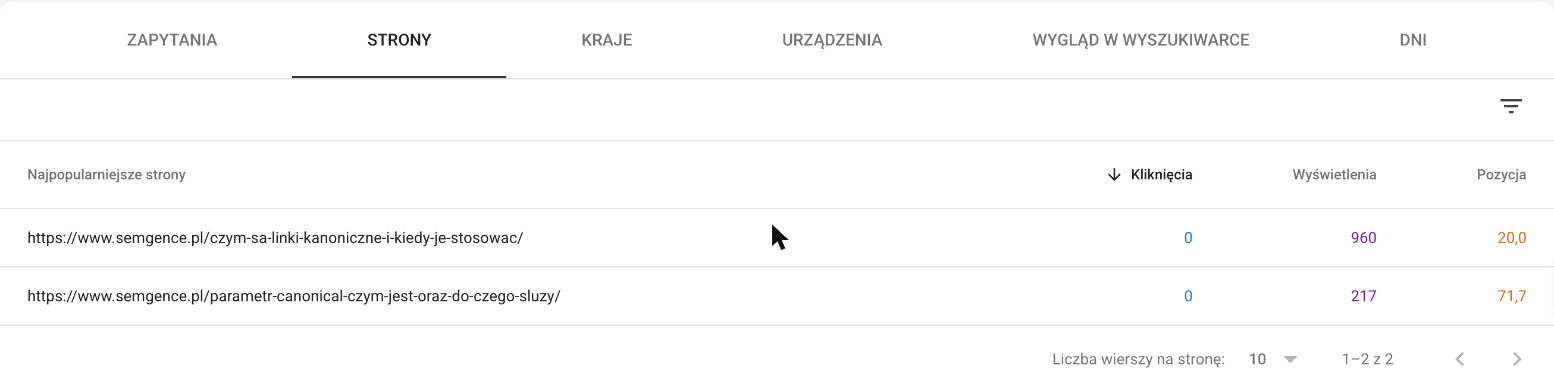
Dla zapytań zawierających słowo „kanoniczn” w trzech miesiącach od sierpnia do listopada 2026 roku krótszy wpis miał 960 wyświetleń i średnią pozycję 20,0, a dłuższy 217 wyświetleń i średnią pozycję 71,7. Żaden nie dostał kliknięcia. Google rozdzielał sygnały między dwa adresy i żaden nie był wystarczająco silny, żeby wejść na pierwszą stronę wyników.
Tu canonical nie był właściwym narzędziem. Canonical stosuje się wtedy, gdy oba adresy muszą istnieć – a dwa artykuły o tym samym nie muszą. Dlatego scaliliśmy je w jeden tekst, który właśnie czytasz, pod adresem, który Google już lepiej oceniał, a stary adres przekierowaliśmy na nowy kodem 301. Linki wewnętrzne, które prowadziły do starego wpisu, przepięliśmy bezpośrednio na nowy adres, żeby nie przechodziły przez przekierowanie. Efekty opiszemy, gdy Google przeskanuje oba adresy i zbierze się wystarczająco dużo danych.
To typowy scenariusz kanibalizacji na blogach z kilkuletnią historią. Jeśli chcesz sprawdzić, gdzie w Twoim serwisie powstają podobne duplikaty, zacznij od tekstu o tym, gdzie szukać duplikacji treści, a szerzej o samym zjawisku piszemy w artykule o duplicate content.
Jak ustawić canonical w sklepie internetowym?
Sklepy to miejsce, gdzie kanonizacja ma największe znaczenie, bo filtry, sortowanie i warianty potrafią wygenerować wielokrotnie więcej adresów niż jest produktów i kategorii. Każdy taki adres to czas robota, który nie zostanie poświęcony na nowe produkty – więcej o tym w tekście o nawigacji fasetowej i budżecie indeksowania.
Kilka zasad, które stosujemy w audytach sklepów:
- Kategoria i jej filtry. Filtrowanie, sortowanie i zmiana liczby produktów na stronie dostają canonical na czysty adres kategorii. Wyjątek to filtry, które odpowiadają realnemu popytowi, na przykład marka w kategorii („buty Nike męskie”). Takie strony warto zostawić z canonical na siebie, dać im własny nagłówek i opis oraz linkować do nich w nawigacji.
- Paginacja. Każda strona listingu ma canonical na samą siebie, a nie na stronę pierwszą.
- Warianty produktu. Jeśli wariant nie ma osobnego popytu, canonical na produkt główny. Jeśli ma – osobny canonical i treść, która ten wariant odróżnia.
- Ten sam produkt w kilku kategoriach. Adres produktu nie powinien zależeć od ścieżki kategorii. Jeśli sklep tworzy adresy w rodzaju
/kategoria-a/produkt/i/kategoria-b/produkt/, canonical musi wskazywać jeden z nich, a linki wewnętrzne powinny prowadzić do tego samego. - Produkty niemal identyczne. Canonical nie naprawi produktów, które różnią się parametrem, a mają kopiowany opis. Google może je połączyć w jeden klaster bez Twojej zgody. O tym, jak Google rozpoznaje takie strony, piszemy w tekście o duplikacji produktów w e-commerce.
Sprawdzenie kanonizacji to stały element naszego audytu SEO – w sklepach to zwykle jeden z pierwszych obszarów, w których szukamy przyczyn słabej indeksacji.
Jak wdrożyć canonical w WordPressie i innych systemach?
WordPress z Rank Math lub Yoast SEO. Obie wtyczki automatycznie dodają canonical na samą stronę dla wpisów, stron, kategorii i produktów WooCommerce. Żeby wskazać inny adres, w Rank Math otwórz ustawienia wpisu, zakładkę Zaawansowane, i wpisz adres w polu Canonical URL. W Yoast SEO to pole jest w zakładce Zaawansowane w panelu wtyczki. Pilnuj, żeby canonical nie dodawały jednocześnie dwie wtyczki albo motyw i wtyczka.
Shopify dodaje canonical na samą stronę automatycznie. Problemem bywają adresy produktów w kolekcjach (/collections/nazwa/products/produkt) – canonical wskazuje wtedy wersję /products/produkt, ale jeśli motyw linkuje do wersji z kolekcją, sygnały się rozjeżdżają. Warto sprawdzić, do jakich adresów prowadzą linki w listingu.
Własny system lub inny CMS. Canonical to jedna linia w <head>. Generuj ją po stronie serwera, z pełnym adresem i zawsze w tej samej wersji: z https://, z www albo bez, z ukośnikiem na końcu albo bez – tak samo jak w mapie witryny i linkach wewnętrznych.
Pliki PDF. Jeśli ten sam dokument ma też wersję HTML, możesz wskazać ją jako kanoniczną w nagłówku HTTP. Na serwerze Apache robi się to w .htaccess:
<Files "cennik.pdf">
Header add Link '<https://www.twojadomena.pl/cennik/>; rel="canonical"'
</Files>
Po każdej zmianie sprawdź w GSC kilka adresów testem na żywo: czy canonical jest widoczny w wyrenderowanej stronie i czy Google wybiera ten sam adres.
Czy canonical wpływa na widoczność w odpowiedziach AI?
Pośrednio tak, bo część systemów AI korzysta z wyników wyszukiwarek, a te pokazują adresy kanoniczne. W lutym 2026 roku Glenn Gabe opisał przypadki, w których ChatGPT podawał adres, który Google wybrał jako kanoniczny, mimo że właściciel serwisu wskazywał inny – czyli ten sam adres, który pokazywały wyniki Google. Gabe zastrzega, że to jego wniosek z obserwacji, a nie potwierdzony mechanizm, ale wzorzec powtarzał się w kilku testowanych serwisach.
Praktyczny wniosek jest prosty: jeśli Google wybiera nie ten adres, którego chcesz, problem nie kończy się na wynikach wyszukiwania. Spójne sygnały kanonizacji – canonical, mapa witryny, linki wewnętrzne i przekierowania wskazujące ten sam adres – to dziś także element dbania o to, który adres cytują systemy AI.
Co zapamiętać o canonical?
- Canonical to wskazówka, nie polecenie. Działa, gdy wszystkie sygnały w serwisie wskazują ten sam adres.
- Każda strona do indeksowania powinna mieć canonical na samą siebie, z pełnym adresem, w
<head>, tylko jeden. - Canonical stosuj, gdy oba adresy muszą działać. Gdy drugi nie musi – użyj 301. Gdy strona ma wypaść z indeksu – noindex. Nie łącz canonical z noindex ani z blokadą w robots.txt.
- Strony paginacji mają canonical na siebie, a nie na stronę pierwszą.
- Sprawdzaj w GSC raport Indeksowanie stron i porównuj adres kanoniczny określony przez użytkownika z wybranym przez Google.
- Dwa artykuły o tym samym temacie to nie problem dla canonical, tylko dla redakcji – scal je i przekieruj.
Co to jest link kanoniczny?
Link kanoniczny (rel=”canonical”) to znacznik w sekcji head strony, który wskazuje wyszukiwarce, który z kilku adresów z tą samą lub bardzo podobną treścią jest wersją główną. Ta wersja trafia do indeksu i zbiera sygnały, takie jak linki. Pozostałe adresy nadal działają dla użytkowników, ale nie pokazują się w wynikach.
Czy canonical to to samo co przekierowanie 301?
Nie. Przekierowanie 301 przenosi użytkownika i robota na nowy adres – stary przestaje być dostępny. Canonical zostawia oba adresy działające, a Google pokazuje w wynikach tylko wskazany. 301 stosuj, gdy drugi adres nie musi istnieć, na przykład przy zmianie adresu albo scaleniu tekstów. Canonical stosuj, gdy oba adresy muszą działać, na przykład przy parametrach UTM czy wariantach produktów.
Czy Google zawsze respektuje canonical?
Nie. Google traktuje canonical jako silną wskazówkę, a nie polecenie. Jeśli inne sygnały wskazują inny adres – przekierowania, mapa witryny, linki wewnętrzne – albo strona kanoniczna zwraca błąd lub ma inną treść, Google wybiera stronę kanoniczną sam. Sprawdzisz to w Google Search Console w narzędziu do sprawdzania adresów URL.
Czy każda strona powinna mieć canonical?
Każda strona, która ma się indeksować, powinna mieć canonical wskazujący na samą siebie, z pełnym adresem i tylko jeden. Zabezpiecza to przed duplikatami, których nie planujesz, na przykład adresami z parametrami dopisanymi z zewnątrz. WordPress z Rank Math albo Yoast SEO dodaje taki canonical automatycznie.
Co oznacza status „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik”?
Ten status w raporcie Indeksowanie stron oznacza, że strona ma canonical, ale Google uznał za lepszy inny adres i zindeksował jego. Porównaj w narzędziu do sprawdzania adresów URL adres określony przez użytkownika z wybranym przez Google, a potem sprawdź, czy strony nie są zbyt podobne, czy sygnały w serwisie nie są sprzeczne i czy Googlebot dostaje tę samą treść co użytkownik.
Czy strony paginacji powinny mieć canonical na pierwszą stronę?
Nie. Google zaleca, żeby każda strona paginacji miała własny canonical, a pierwsza strona serii nie była stroną kanoniczną dla kolejnych. Canonical z dalszych stron na pierwszą utrudnia indeksowanie produktów i wpisów, które widać dopiero na kolejnych stronach. Atrybutów rel=”next” i rel=”prev” Google już nie używa.




A jak poradzić sobie z ilością kilkuset artykułów, które przez kilka lat były publikowane i kanibalizują się między sobą? Zostawić tylko kaloryczne, generujące ruch i nimi się zająć?
Są różne podejścia Pawle:
1. Zweryfikować, które artykuły dają ruch
2. Sprawdzić, czemu inne ruchu nie dają i podjąć decyzję czy scalać je, czy kasować czy też rozwinąć.
Nasze podejście jest takie, że zawsze staramy się wyciągnąć maksimum ze wszystkich artykułów ponieważ dają one możliwość skorzystania z linkowania wewnętrznego. Może się jednak zdarzyć, że lepiej jest artykuł scalić jeśli właśnie kanibalizują lub deoptymalizować jeden kosztem drugiego (np. usuwając słowa lub robiąc linkowanie wewnętrzne lub z tego ważniejszego zbudować pilar page).
Nie jesteśmy zwolennikami kasowania artykułów.