Analiza logów serwera ma sens wtedy, gdy Google Search Console i GA4 przestają odpowiadać na pytanie, co boty naprawdę robią w serwisie. Logi pokazują każde żądanie: który bot, który URL, jaki kod odpowiedzi i o której godzinie. Żeby jednak z prawie miliona linii access.log zrobić decyzje o crawl budgecie, trzeba odfiltrować ludzi i obce domeny, zweryfikować boty, rozdzielić dane na warstwy i połączyć je z GSC oraz GA4. Opisujemy, jak zbudowaliśmy własny analizator logów w panelu AI Monitor, co pokazał na danych semgence.pl i które decyzje projektowe okazały się błędne. Część z nich wyszła dopiero przy pisaniu tego tekstu.
Wszystkie liczby pochodzą z jednego serwisu (semgence.pl) i jednego okresu (10-21 listopada 2026). Pokazują skalę zjawisk i to, jak działa pipeline – nie są benchmarkiem dla innych stron. Większość liczb w tekście pochodzi z pierwszego raportu, sprzed poprawek, które wdrożyliśmy po tej analizie – bo właśnie na nich widać, ile trzeba było rozłożyć na części, zanim dało się wyciągnąć wnioski. Wyniki po poprawkach zestawiamy w osobnej sekcji na końcu.
Jaki problem chcieliśmy rozwiązać?
Przy audytach dużych serwisów i sklepów wracało to samo pytanie: dlaczego ważne podstrony długo czekają na odświeżenie w Google, skoro serwer notuje tysiące żądań botów dziennie? Odpowiedź zawsze była w logach, ale ręczna analiza była żmudna. Pliki ważą dziesiątki megabajtów, hosting rotuje je i kompresuje, na współdzielonym serwerze w jednym logu siedzi kilka domen, a w polu user-agent co chwilę pojawia się „Googlebot”, który z Google nie ma nic wspólnego.
Do tego doszły boty AI. OAI-SearchBot, ChatGPT-User, ClaudeBot czy meta-webindexer pojawiają się w logach w skali, której nie da się już pomijać, a klienci pytają, czy te boty w ogóle docierają do treści, które mają być cytowane w odpowiedziach AI.
Chcieliśmy narzędzia, które przyjmie logi ręcznie albo z serwera, odsieje ruch ludzi i obce domeny, zweryfikuje boty, pokaże, na co wydają żądania, odtworzy historię pojedynczego URL-a, połączy logi z GSC i GA4, wykryje incydenty i udostępni to wszystko agentowi AI przez MCP. Punktem odniesienia były Screaming Frog Log File Analyser, narzędzia obserwowalności w stylu Datadog i analityka crawlerów znana z LogHero. Do jednorazowej analizy gotowe narzędzie w zupełności wystarczy – Log File Analyser ma automatyczną weryfikację botów wyszukiwarek, a jego darmowa wersja obsługuje do 1000 linii logu. Własny system zaczyna mieć sens, gdy logi trzeba codziennie łączyć z GSC, GA4 i crawlem oraz udostępniać agentom AI. Nie chodziło o kopię żadnego z nich, tylko o moduł osadzony w projekcie: z tymi samymi domenami, danymi GSC, GA4 i crawla, z których korzystamy w pozostałych częściach panelu. Analiza logów to dla nas punkt wyjścia w technicznym audycie SEO większych serwisów – bez niej trudno ocenić, czy problem z indeksacją wynika z treści, architektury, czy z tego, że boty w ogóle nie trafiają w ważne podstrony.
Czego nie pokażą GSC i GA4, a pokaże analiza logów serwera?
Raport statystyk indeksowania w Search Console dotyczy tylko robotów Google, a pokazywane w nim przykładowe adresy według samego Google „nie wyczerpują wszystkich możliwości” – to reprezentatywna próbka, a nie pełna lista. Nie zobaczysz w nim pełnej listy URL-i pobranych danego dnia, nie porównasz Googlebota z Bingbotem ani z botami AI i nie sprawdzisz, czy ruch z user-agentem Googlebota pochodzi od Google. GA4 mierzy użytkowników, którzy wykonali JavaScript, więc boty wyszukiwarek i większość botów AI w ogóle się w nim nie pojawia.
| Kryterium | Google Search Console | GA4 | Logi serwera |
|---|---|---|---|
| Kogo widzi | Roboty Google (statystyki indeksowania), użytkowników z wyszukiwarki | Użytkowników z JS i zgodą na pomiar | Każde żądanie HTTP, które dotarło do serwera |
| Bing i boty AI | Nie | Praktycznie nie | Tak |
| Poziom szczegółu | Agregaty i przykładowe URL-e | Sesje i zdarzenia | Pojedyncze żądanie: czas, URL, kod, user-agent, IP |
| Weryfikacja bota | Nie dotyczy | Nie dotyczy | Możliwa (DNS, zakresy IP) |
| Historia jednego URL-a | Data ostatniego pobrania w inspekcji URL | Nie | Każde pobranie w okresie retencji |
| Co mówi o indeksacji | Stan indeksu, wyświetlenia, kliknięcia | Nic | Nic – tylko o pobraniu |
Ostatni wiersz jest najważniejszy: crawl nie oznacza indeksacji. Google pisze wprost w opisie działania wyszukiwarki, że „indeksowanie nie jest gwarantowane” i nie każda przetworzona strona trafia do indeksu. Logi mówią, że bot pobrał stronę. O tym, czy ją pokazuje, mówi dopiero GSC.
Jak wygląda pojedynczy wpis access.log?
Typowy wpis w formacie Combined Log Format:
66.249.66.1 - - [14/Nov/2026:03:12:45 +0100] "GET /kategoria/buty-trekkingowe/?sort=price&page=3 HTTP/1.1" 200 48211 "-" "Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"| Pole | Wartość | Znaczenie dla SEO |
|---|---|---|
| IP klienta | 66.249.66.1 | Podstawa weryfikacji bota |
| Znacznik czasu | [14/Nov/2026:03:12:45 +0100] | Ze strefą czasową, którą trzeba ujednolicić |
| Metoda i ścieżka | GET /kategoria/...?sort=price&page=3 | URL z parametrami – kandydat do crawl waste |
| Kod odpowiedzi | 200 | Status, który zobaczył bot |
| Rozmiar odpowiedzi | 48211 | Bajty przesłane do bota |
| Referer | "-" | U botów zwykle pusty |
| User-agent | ... Googlebot/2.1 ... | Deklaracja, nie dowód tożsamości |
Na współdzielonym hostingu, na którym stoi semgence.pl, log zawiera dodatkowo nazwę hosta, bo w jednym pliku są żądania kilku domen. Bez tego pola nie dałoby się odfiltrować obcego ruchu, a jak zobaczysz niżej, to była prawie połowa pliku.
Jaką architekturę ma system?
Najważniejsza decyzja: surowe logi nie trafiają do jednej wielkiej tabeli. Dane przechodzą przez kilka warstw, z których każda ma inny cel, inny czas życia i inne zasady dostępu.
[Źródła]  upload ręczny (.log/.txt/.gz)      FTP / FTPS / SFTP (raz na dobę)
              └────────────────┬────────────────┘
                               ▼
[1. Surowe pliki]  system plików, rejestr importów (hash pliku)
                               ▼
[Parser + normalizacja + kontrola jakości]
   ├─ obce domeny ────────► tylko licznik
   ├─ ruch niebotowy ─────► tylko licznik
   ├─ nieznane boty ──────► osobny agregat
   ├─ linie odrzucone ────► licznik + przykłady z powodem
   └─ rozpoznane boty
                               ▼
[Weryfikacja botów]  user-agent + oficjalne listy CIDR
                               ▼
[2. Zdarzenia znormalizowane]  snapshot projektu, retencja 90 dni
                               ▼
[3. Agregaty dzienne i alerty]  baza danych
                               ▼
[4. Cache]  pamięć procesu, 30 minut
        ┌──────────────┬───────────┼────────────┬──────────────┐
        ▼              ▼           ▼            ▼              ▼
     Panel       Crawl budget  Historia URL  Incydenty    Serwer MCP
                               ▲
[GSC] [GA4 organic] [Topical] [Content] - łączone po URL-u| Warstwa | Gdzie | Retencja | Do czego służy |
|---|---|---|---|
| Surowe pliki | System plików | Usuwane, gdy cały plik wypadnie poza 90 dni, plus 14 dni kwarantanny | Ponowne przeliczenie po zmianie parsera |
| Zdarzenia znormalizowane | Snapshot JSON projektu (ok. 3,8 MB) | 90 dni | Historia URL-a, explorer, crawl budget |
| Agregaty dzienne | PostgreSQL | 90 dni | Trendy, Intelligence, porównania okresów |
| Alerty | PostgreSQL | Bez limitu | Incydenty i ich wyjaśnienia |
| Cache | Pamięć procesu | 30 minut | Szybkie odpowiedzi panelu i MCP |
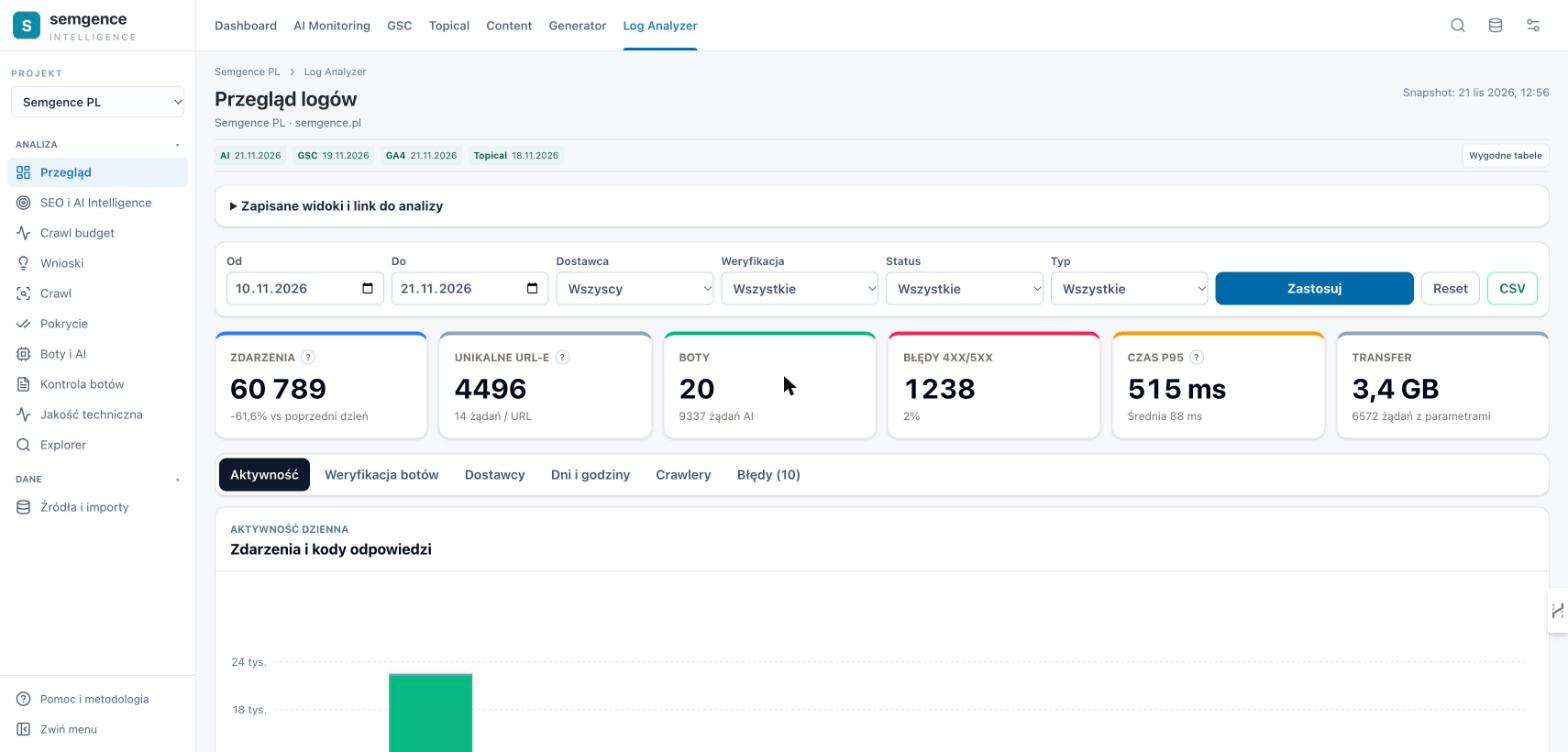
Całość to aplikacja w Node.js (Next.js, React, TypeScript) z PostgreSQL i osobną usługą MCP. Panel ma 11 widoków, filtry zapisują się w adresie URL, więc analizę można wysłać linkiem, a eksport CSV działa tylko dla bezpiecznych zestawień – dla surowych zdarzeń, user-agentów i refererów jest wyłączony.
Jedna rzecz jest mniej oczywista, niż wygląda: plik, który zawiera stare i nowe linie, zostaje w całości dłużej niż 90 dni, a w surowych plikach są pełne IP i query stringi. Retencja na poziomie pliku nie jest retencją na poziomie danych, dlatego dostęp do warstwy surowej trzeba pilnować bardziej niż do snapshotu.
Jak działa import ręczny i automatyczny przez FTP/SFTP?
Import ręczny przyjmuje pliki .log, .txt i .gz – do 20 plików, 64 MB na plik i 128 MB łącznie. Wystarcza do jednorazowej analizy przed migracją albo po spadku widoczności.
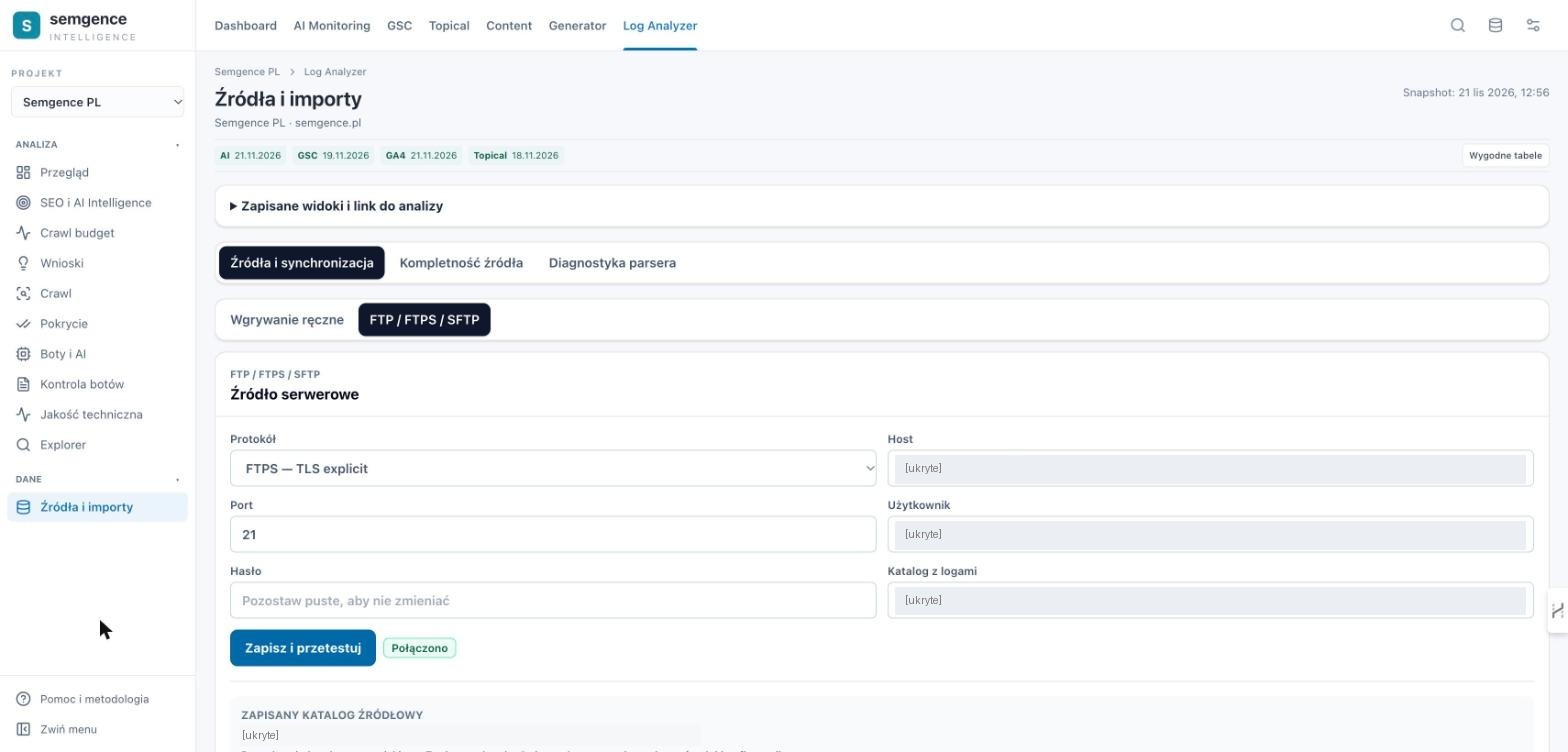
Przy stałym monitoringu import ręczny szybko się psuje: ktoś zapomina, hosting rotuje logi i część dni przepada. Dlatego panel łączy się z serwerem po FTP, FTPS albo SFTP i pobiera nowe pliki z katalogu logów. Dla semgence.pl używamy FTPS z jawnym TLS, bo na współdzielonym hostingu nie mamy dostępu SSH.
Zasady, których się trzymamy:
- Hasło jest szyfrowane i nie wraca z serwera. Poświadczenia są zapisywane z szyfrowaniem AES-256-GCM (losowy wektor inicjujący, tag uwierzytelniający), w pliku dostępnym tylko dla procesu aplikacji. Pole hasła w formularzu jest zawsze puste („Pozostaw puste, aby nie zmieniać”), a narzędzie MCP do sprawdzania statusu ma w opisie wprost: dane dostępowe nigdy nie są zwracane.
- Konto po stronie serwera tylko do odczytu i tylko do katalogu z logami. Katalog wybiera się w przeglądarce folderów w panelu, a konfiguracja odrzuca adresy w sieciach prywatnych i lokalnych, żeby formularz źródła nie dał się użyć do odpytywania wewnętrznej infrastruktury.
- Raz na dobę wystarczy. Synchronizacja startuje w nocy z losowym opóźnieniem do 15 minut i ma do trzech prób z przerwą. Decyzje o crawl budgecie podejmuje się na danych z dni i tygodni. Częstsza synchronizacja ma sens tylko wtedy, gdy logi służą też do wykrywania awarii – a to już inne narzędzie.
- Duplikaty plików są pomijane. Ostatnia synchronizacja znalazła na serwerze 16 plików, pobrała 2 nowe i pominęła 14, które już były w systemie. Jak się okazało, to za mało – piszemy o tym w sekcji o błędach.
Parser, normalizacja i kontrola jakości danych
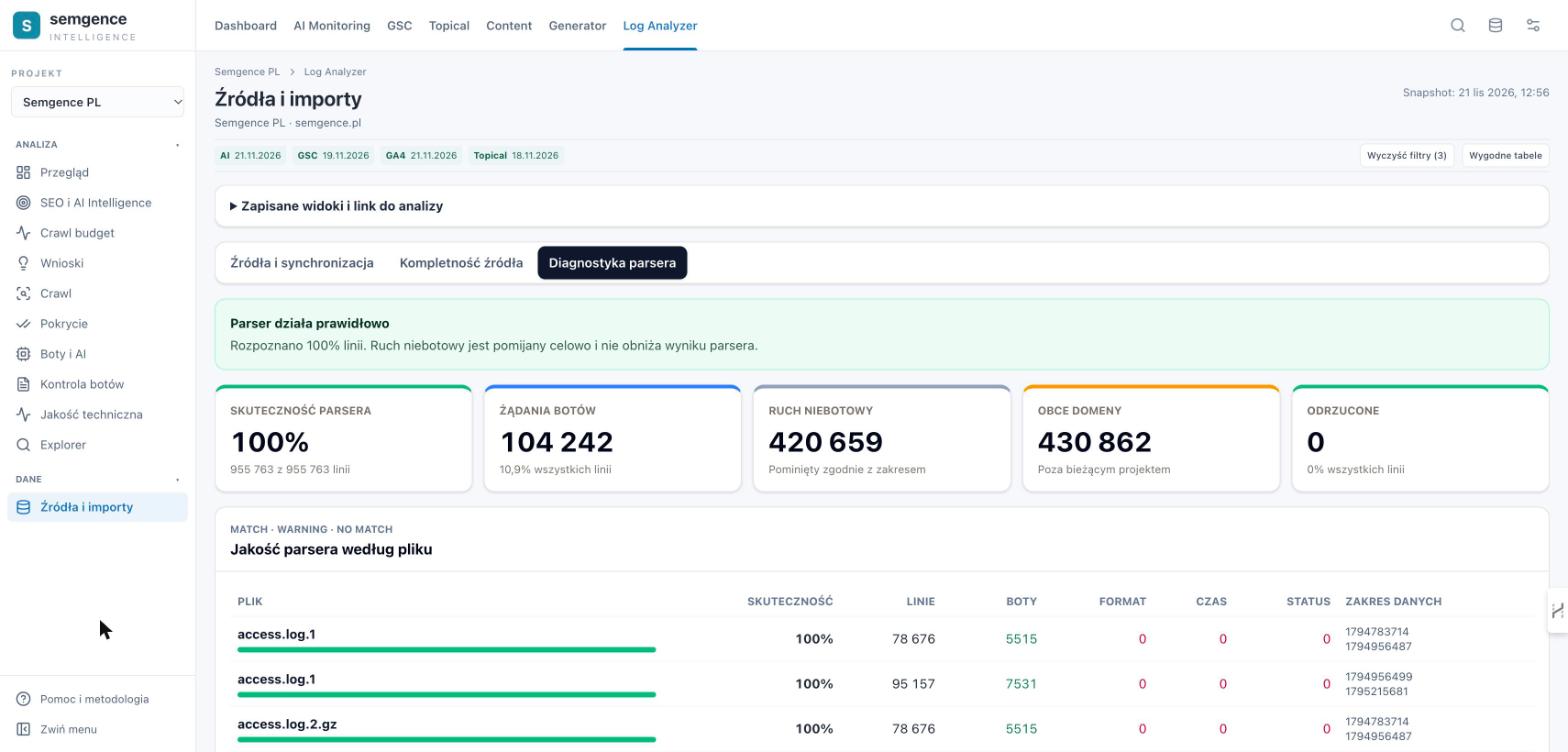
Parser rozbija linię na pola, odrzuca to, co nie służy analizie SEO, i ujednolica resztę. Na danych semgence.pl z 22 plików wyszło tak:
| Kategoria | Liczba linii |
|---|---|
| Wszystkie wiersze źródłowe | 957 807 |
| Ruch niebotowy (ludzie) | 420 659 |
| Żądania dotyczące obcych domen | 432 099 |
| Linie odrzucone jako niepoprawne | 807 |
| Zaakceptowane żądania rozpoznanych botów | 104 242 |
Z prawie miliona linii do analizy SEO trafiło 10,9%. Na współdzielonym serwerze log zawierał ruch kilku innych serwisów – bez filtra po hoście „crawl budget” semgence.pl byłby sumą kilku stron. Dwa zastrzeżenia: 104 242 to liczba przed deduplikacją (unikalnych żądań jest najwyżej około 70,7 tys.), a wszystkie 807 odrzuconych linii pochodzi z plików error.log, które w ogóle nie powinny trafić do importu. Wracamy do obu spraw w sekcji o błędach.
Normalizacja obejmuje czas, host, ścieżkę, typ zasobu (HTML, obraz, CSS, JS, API, XML, dokument, font) i prywatność. W snapshocie adresy IPv4 są maskowane do /24, IPv6 do /64, wartości parametrów są usuwane (zostają tylko nazwy), nazwy sugerujące dane wrażliwe są anonimizowane, a referer traci query string.
Wartości parametrów zapytań należy usuwać albo anonimizować. Do SEO wystarczy wiedzieć, że URL miał parametry sort i page. Same wartości bywają e-mailem, tokenem sesji albo numerem zamówienia. Pamiętaj tylko, że surowe pliki nadal zawierają wszystko – anonimizacja snapshotu nie zwalnia z pilnowania warstwy surowej.
Przykładowy schemat zdarzenia znormalizowanego:
{
  "ts": "2026-11-21T11:42:06Z",
  "domain": "semgence.pl",
  "method": "GET",
  "path": "/wp-content/uploads/2024/06/wielkosc-grupy-docelowej.png",
  "query_keys": [],
  "resource_type": "image",
  "status": 304,
  "bytes": 0,
  "response_ms": 4,
  "bot": "Googlebot Image",
  "vendor": "google",
  "role": "Wyszukiwarka",
  "verdict": "confirmed",
  "verification_method": "official_cidr",
  "subnet": "66.249.68.x",
  "country": "US"
}
Jak rozpoznawać i weryfikować boty?
To dwa osobne kroki. Rozpoznanie odbywa się po user-agencie: przypisujemy bota, dostawcę i rolę (wyszukiwarka, reklamy, AI Search, trening AI, pobranie na żądanie użytkownika). Weryfikacja sprawdza, czy bot jest tym, za kogo się podaje, bo user-agent może zostać podszyty. Google opisuje weryfikację jako sposób na sytuację, gdy podejrzewasz „spamerów lub innych oszustów podających się za Googlebota”: odwrotne zapytanie DNS, sprawdzenie, czy domena to googlebot.com, google.com lub googleusercontent.com, i zapytanie w przód, które musi zwrócić to samo IP. Przy dużej skali Google zaleca porównanie IP z publikowanymi listami zakresów.
Nasz analizator porównuje IP z lokalnymi kopiami oficjalnych list CIDR: Google, Bing, OpenAI (osobno dla OAI-SearchBot, GPTBot i ChatGPT-User), Anthropic, Apple i Common Crawl. Microsoft opisuje dla Bingbota procedurę z odwrotnym DNS na domenie search.msn.com w poradniku Bing Webmaster, a OpenAI na stronie o swoich crawlerach publikuje listy IP dla każdego bota i zaznacza przy ChatGPT-User, że przy akcjach wywołanych przez użytkownika reguły robots.txt mogą nie mieć zastosowania. Ograniczenie, które trzeba znać: listy IP się zmieniają, a nasze kopie nie mają jeszcze automatycznego odświeżania ani drugiej metody w postaci reverse DNS.
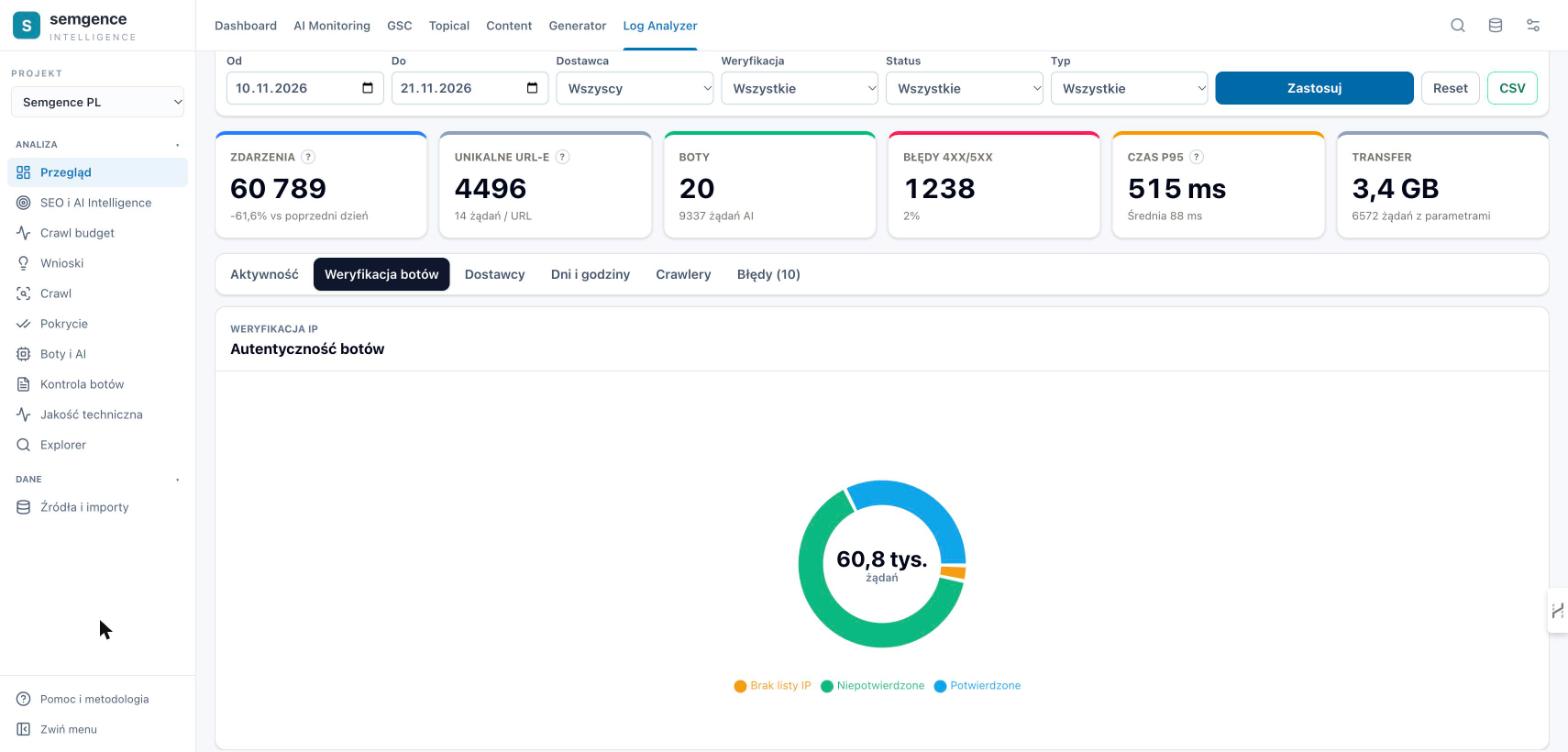
Każde żądanie dostaje status: potwierdzone, niepotwierdzone (IP nie pasuje do listy) albo „brak listy” (dostawca nie publikuje zakresów, np. Meta). Na semgence.pl, przed deduplikacją:
| Status weryfikacji | Żądania |
|---|---|
| Potwierdzone | 19 817 |
| Niepotwierdzone | 39 468 |
| Brak listy IP | 1504 |
Dwie trzecie ruchu podpisanego nazwą znanego bota nie przeszło weryfikacji. Największy kawałek to jeden dzień – o nim w sekcji o incydentach.
Widok „Kontrola botów” łączy katalog botów z audytem robots.txt na adresach, które boty faktycznie odwiedzały. Z czterema zastrzeżeniami: robots.txt nie jest zabezpieczeniem, nie każdy bot go respektuje, obecny plik mógł się różnić od wcześniejszego, a samo żądanie nie dowodzi, że bot wykorzystał treść.
Przechowywanie: agregaty, cache i retencja 90 dni
Zdarzenia w snapshocie i dzienne agregaty trzymamy 90 dni. To wystarcza, żeby porównać dwa pełne miesiące, zobaczyć efekt zmian w robots.txt czy linkowaniu i odtworzyć historię URL-a w typowym horyzoncie analizy.
Retencja nie jest jednak jedną liczbą dla całego systemu. Alerty i ich historia zostają bez limitu, bo służą do porównań przyczyn incydentów w dłuższym czasie. Cache żyje 30 minut. Surowe pliki znikają dopiero wtedy, gdy cały plik wypadnie poza okres retencji, z dodatkowym 14-dniowym okresem kwarantanny. Zasada ogólna: cache przyspiesza odczyt, ale żadna decyzja nie opiera się na danych, których nie da się odtworzyć z warstwy niżej – i każda warstwa ma własne, świadomie ustawione zasady usuwania.
Jak analizować crawl budget?
Według Google budżet wynika z limitu wydajności indeksowania i zapotrzebowania na indeksowanie, a przewodnik Google jest pisany z myślą o dużych witrynach, w tym tych z ponad milionem unikalnych stron. Semgence.pl do nich nie należy, więc te dane traktujemy jako test narzędzia, a nie diagnozę problemu. Praktyczne kroki optymalizacji opisujemy w poradniku crawl budget w 9 krokach.
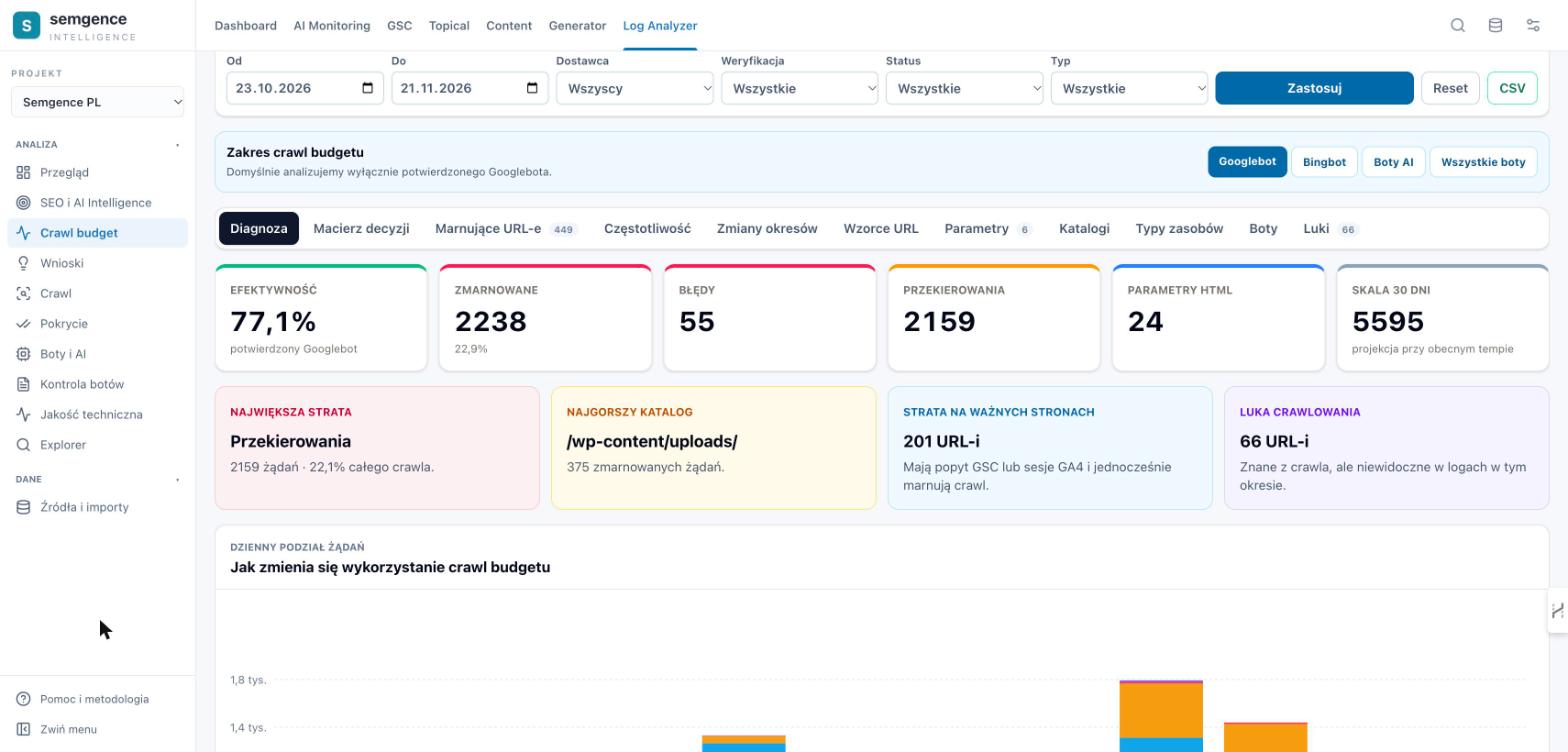
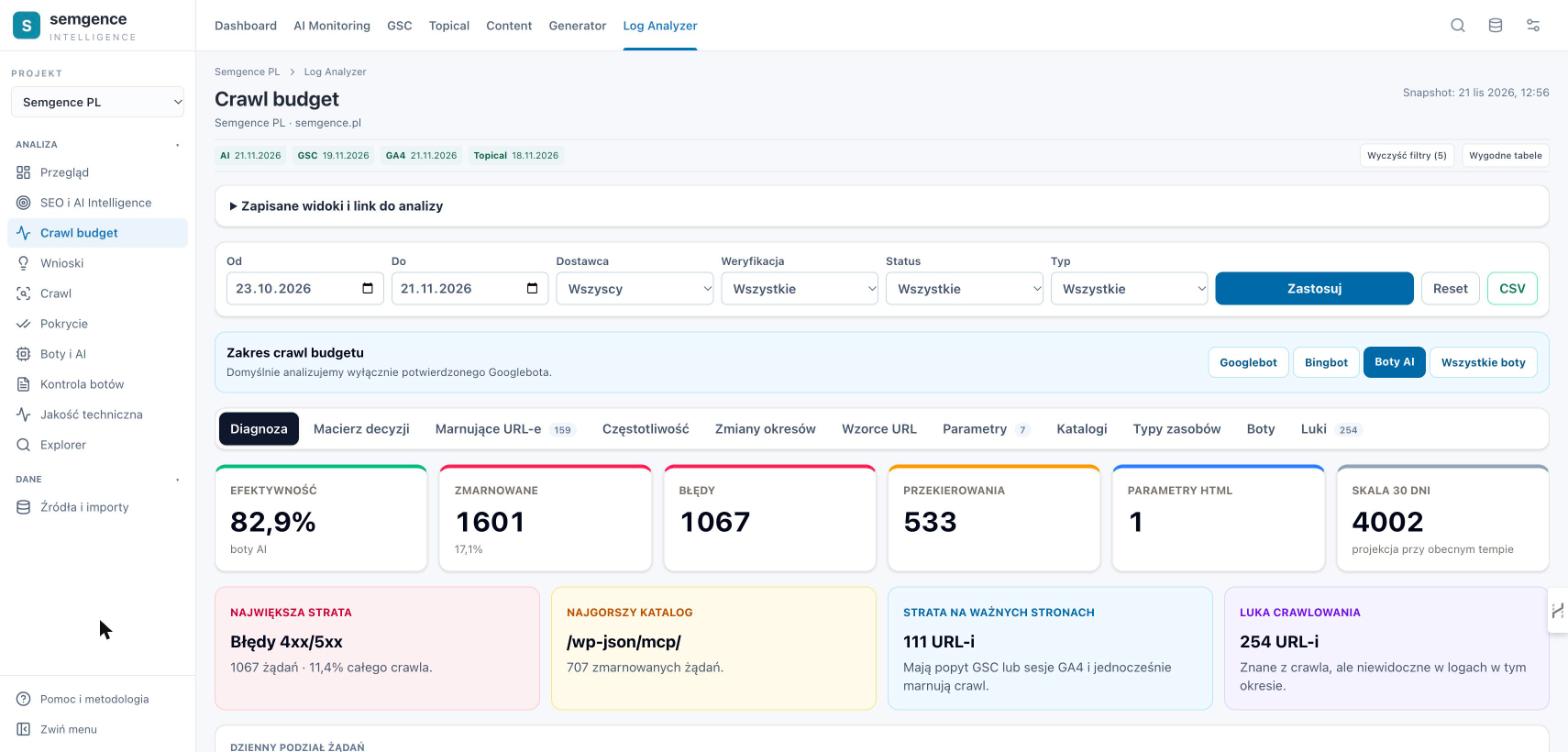
Logi nie pokazują budżetu wprost, tylko to, na co boty go wydają. W chwili analizy panel liczył potencjalny crawl waste jako sumę błędów 4xx/5xx, wszystkich przekierowań 3xx i udanych żądań HTML z parametrami. Wyniki przed deduplikacją:
| Grupa botów | Waste | Błędy | Przekierowania 3xx | HTML z parametrami |
|---|---|---|---|---|
| Wszystkie rozpoznane boty | 7,5% | 1238 | 3230 | 61 |
| Googlebot (potwierdzony) | 22,9% | 55 | 2159 | 24 |
| Bingbot (potwierdzony) | 9,4% | 48 | 415 | 7 |
| Boty AI | 17,1% | 1067 | 533 | 1 |
Każda z tych liczb wymagała korekty:
- Googlebot: 304 to nie strata. Z 2159 „przekierowań” 1875 to
304 Not Modified, czyli poprawna walidacja cache – strona się nie zmieniła i bot nie musiał jej pobierać ponownie. Google opisuje ten mechanizm w przewodniku o budżecie jako sposób na oszczędzanie zasobów. Bez 304 waste Googlebota spada z 22,9% do około 3,7%. - Wszystkie boty: średnią zaniżył fałszywy ruch. Ten widok nie filtrował weryfikacji, więc wliczał 20 tysięcy żądań fałszywego Googlebota z 11 listopada – prawie wyłącznie udanych pobrań obrazków.
- Boty AI: największą „stratę” zrobiliśmy sami. Główny katalog strat to endpoint MCP na naszym WordPressie, przez który własny agent AI (Claude-User) pracuje nad stroną. To nie crawl, tylko ruch narzędzia – ale nie da się go wyciąć filtrem po user-agencie, bo Claude-User to także prawdziwe wizyty z zewnątrz.
Docelowa definicja: przekierowania to tylko 300-303 i 305-308, 304 trafia do osobnej kategorii „walidacja cache”, parametry liczymy tylko dla HTML, a ruch własnych agentów idzie do raportu operacyjnego, poza SEO.
Procent waste’u to dopiero początek. Po połączeniu logów z GSC i GA4 każdy URL trafia do jednej z czterech kategorii macierzy decyzyjnej:
| Kategoria | Co oznacza | Typowa decyzja |
|---|---|---|
| Undercrawl | Ważny URL (popyt w GSC, ruch w GA4) odwiedzany zbyt rzadko | Mocniejsze linkowanie wewnętrzne, sitemap |
| Overcrawl | Dużo wizyt bota w stosunku do wartości adresu | Sprawdzenie, skąd bot trafia na adres |
| Waste | Żądania zużywane na błędy, warianty i adresy techniczne | Przekierowania, canonical, porządek w parametrach |
| Healthy | Częstotliwość crawlu adekwatna do roli strony | Bez zmian |
Panel pokazał też rzeczy do naprawy od razu: potwierdzony Googlebot wielokrotnie dostawał 404 na starym adresie wpisu, a boty OpenAI dostawały 301 na stronie głównej, bo trafiały w niekanoniczny wariant adresu. O źródłach waste’u w sklepach piszemy w tekstach o filtrach w sklepie i crawl budgecie oraz o tagach i kategoriach, które zjadają indeksowanie.
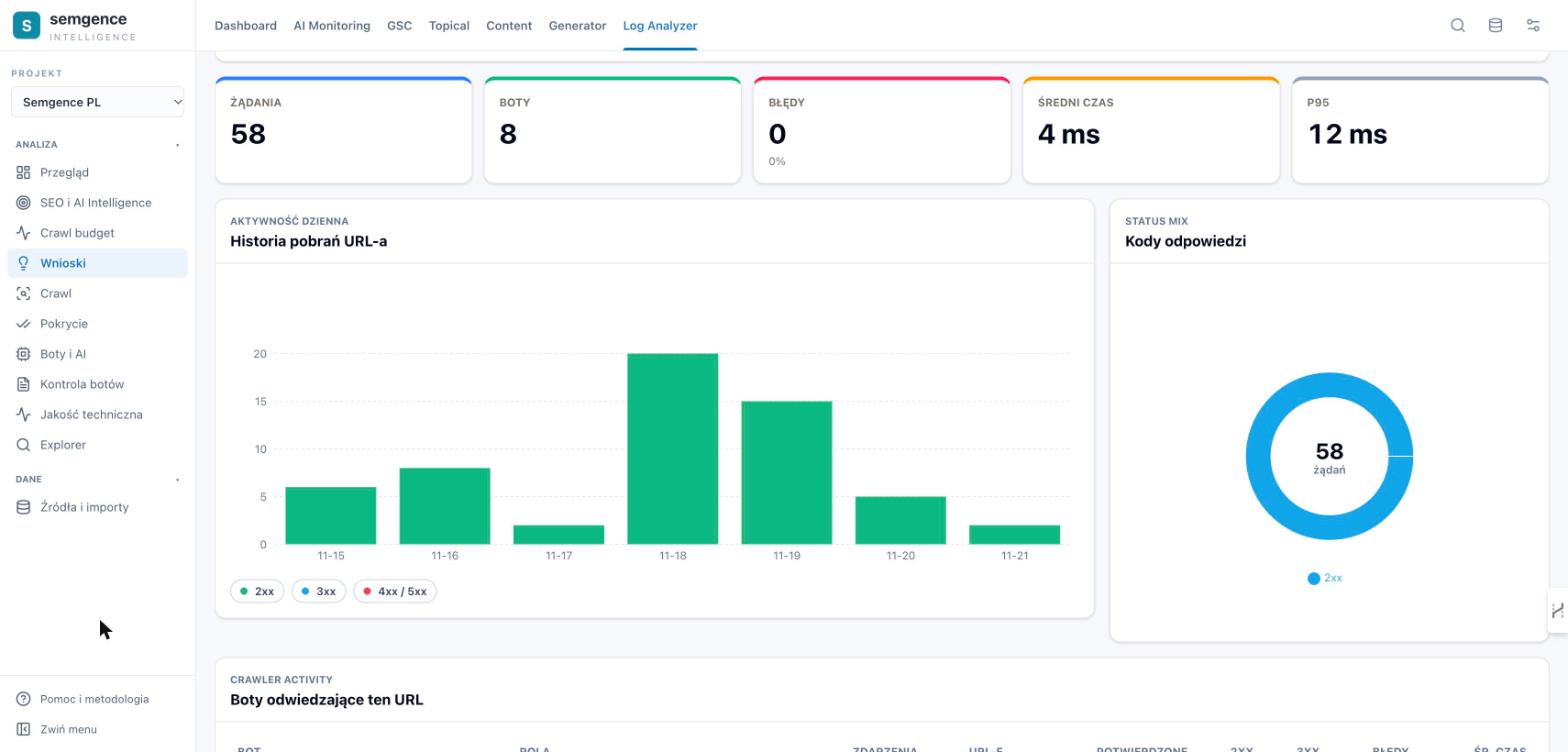
Historia pobierania pojedynczego URL-a
To widok, z którego korzystamy najczęściej. Wpisujesz adres i dostajesz liczbę żądań, listę botów, kody odpowiedzi, czasy i dzienną historię pobrań. Przykład: /audyt-seo/ w ostatnim tygodniu (15-21.11) miał 58 żądań od 8 botów, zero błędów i średni czas odpowiedzi 4 ms.
Typowe pytania, na które odpowiada:
- Kiedy Googlebot pobrał stronę po aktualizacji treści?
- Czy po wdrożeniu przekierowania bot nadal chodzi na stary adres?
- Czy strona zwracała błędy w dniach, w których spadły wyświetlenia?
- Czy boty AI w ogóle docierają do strony, którą chcemy mieć cytowaną?
Jak połączyć logi z GSC, GA4 i danymi o treści?
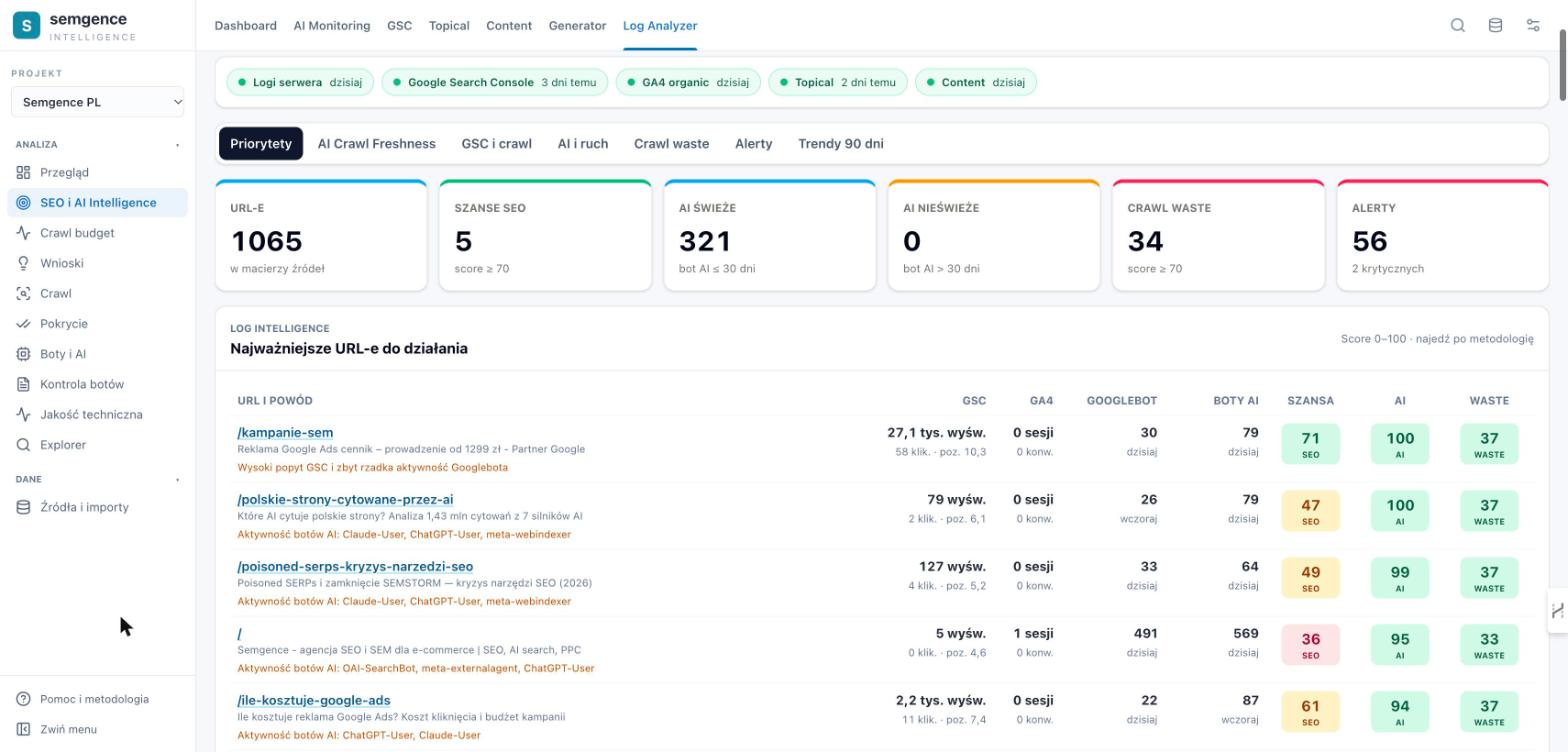
Logi mówią, co boty pobrały, GSC – co Google pokazuje, GA4 – co robią ludzie, a crawl i CMS – czym jest strona. Widok „SEO i AI Intelligence” łączy te źródła i przy każdym pokazuje, jak świeże są dane. Dla semgence.pl macierz objęła 1065 URL-i, a każdy dostał trzy oceny: szansę SEO, zainteresowanie AI i crawl waste.
Najtrudniejsza część to łączenie po URL-u, bo każde źródło zapisuje adres inaczej: GSC z protokołem i hostem, GA4 często samą ścieżką, logi z query stringiem, crawler po przekierowaniach. Bez wspólnej normalizacji złączenie po cichu gubi dane – u nas jedna strona usługowa pokazywała 0 sesji GA4 zamiast około 35 (szczegóły w sekcji o błędach). Osobną pułapką jest złe przypisanie usług GA4 do domen, które opisaliśmy we wpisie o tym, jak wykryć błędne połączenie danych GSC i GA4.
Kombinacje, które dają najwięcej decyzji:
- często pobierane, bez wyświetleń w GSC – do sprawdzenia indeksowalności, kanibalizacji lub linkowania,
- ważne dla biznesu, rzadko pobierane – do mocniejszego linkowania wewnętrznego,
- zaktualizowane w CMS, niepobrane od aktualizacji – do sprawdzenia sygnałów świeżości, w tym tego, czy lastmod w sitemapie mówi prawdę,
- pobierane przez boty AI, ale z błędem lub przekierowaniem – strony, których AI nie zobaczy w aktualnej wersji.
Widok „Pokrycie” odpowiada na pytanie odwrotne: które adresy znane z crawla serwisu boty w ogóle odwiedziły, a które nie.
Jak monitorować boty AI?
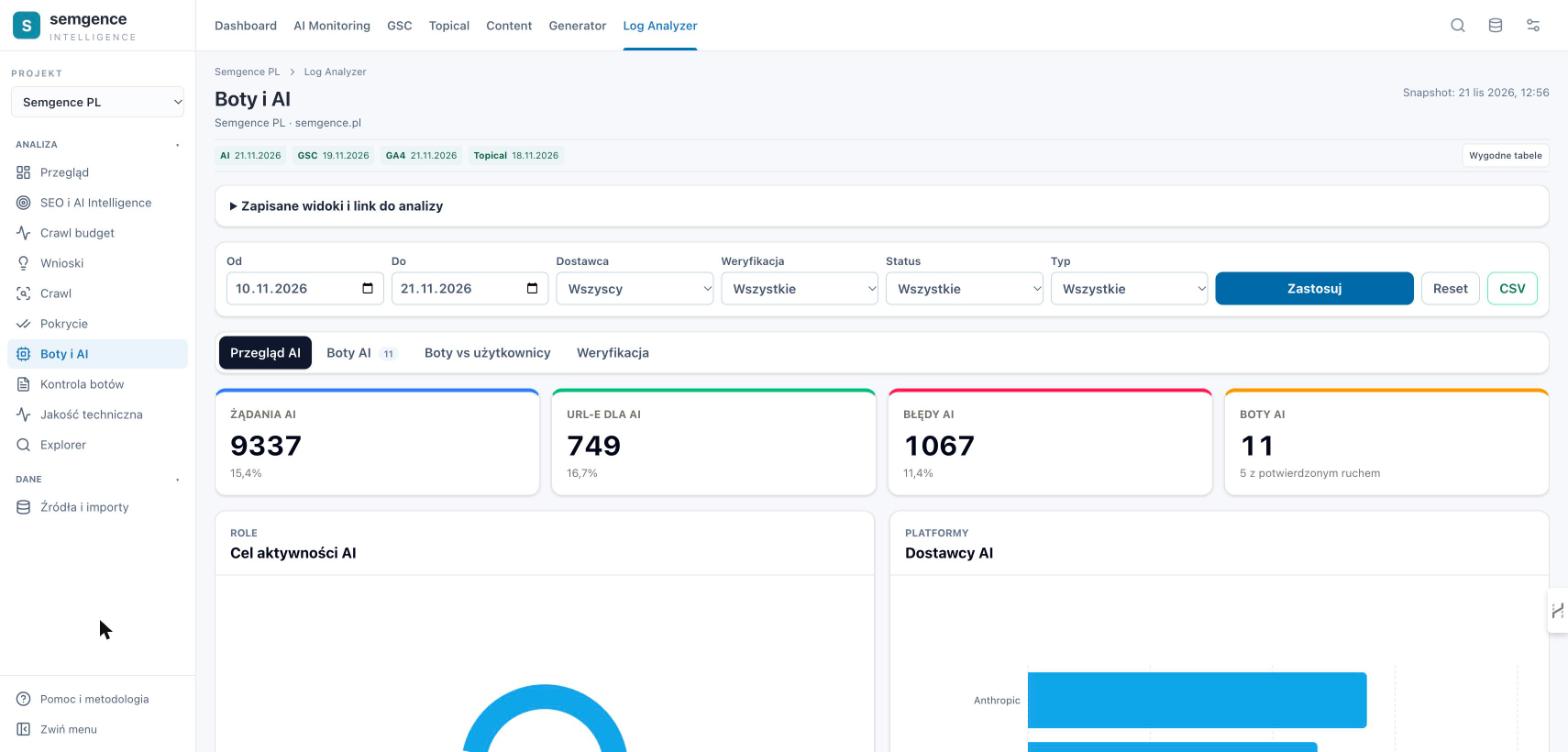
Ile ruchu botów generują boty AI? Na semgence.pl w badanym okresie, po deduplikacji i odfiltrowaniu ruchu naszego własnego agenta, boty AI wysłały 4565 żądań, czyli około 10% ruchu rozpoznanych botów. Pierwszy raport pokazywał 9337 żądań i 15% – różnica to duplikaty z rotowanych logów i nasz agent. Ta liczba sama w sobie mówi jednak niewiele, bo boty AI mają różne cele. OpenAI rozdziela OAI-SearchBot (wyszukiwanie w ChatGPT), GPTBot (dane do trenowania modeli) i ChatGPT-User (wizyty wywołane przez użytkownika). Wrzucenie ich do jednego worka zaciera najważniejszą informację: czy treść trafia do indeksu wyszukiwarki AI, do treningu, czy na prośbę konkretnej osoby.
- OAI-SearchBot – 3090 żądań do 322 URL-i, 0,1% błędów. Bot, który decyduje o obecności w wyszukiwarce ChatGPT, ma do strony pełny dostęp.
- ChatGPT-User – 459 żądań, czyli wizyty, gdy ktoś w ChatGPT poprosił o otwarcie naszej strony.
- CCBot, Bytespider, meta-externalagent, Amazonbot – wszystkie żądania zakończone błędem po około 1 ms. Tak wygląda blokada po stronie serwera, a nie problem z treścią.
- Claude-User – 3826 żądań, w większości nasz własny agent łączący się z WordPressem.
Dla treściowych URL-i panel pokazuje „AI Crawl Freshness”: datę ostatniej wizyty każdego bota AI i adresy, których dany bot nie odwiedził ani razu. Na semgence.pl 321 adresów zostało pobranych przez boty AI w ostatnich 30 dniach. Trzeba tu jednak rozróżnić dwie rzeczy. Wiemy, kiedy bot pobrał URL, bo widzimy żądanie w logu. Nie wiemy, którą wersję treści dostał – do tego trzeba logować nagłówki ETag i Last-Modified albo zestawiać czas żądania z hashem treści zapisanym przy publikacji.
Logi pokazują dostęp, a nie widoczność. To, że OAI-SearchBot pobrał stronę, nie znaczy, że ChatGPT ją cytuje – do tego potrzebny jest monitoring odpowiedzi AI. Podstawy kontroli dostępu opisujemy w tekście o crawlability AI.
Alerty, incydenty i porównywanie okresów
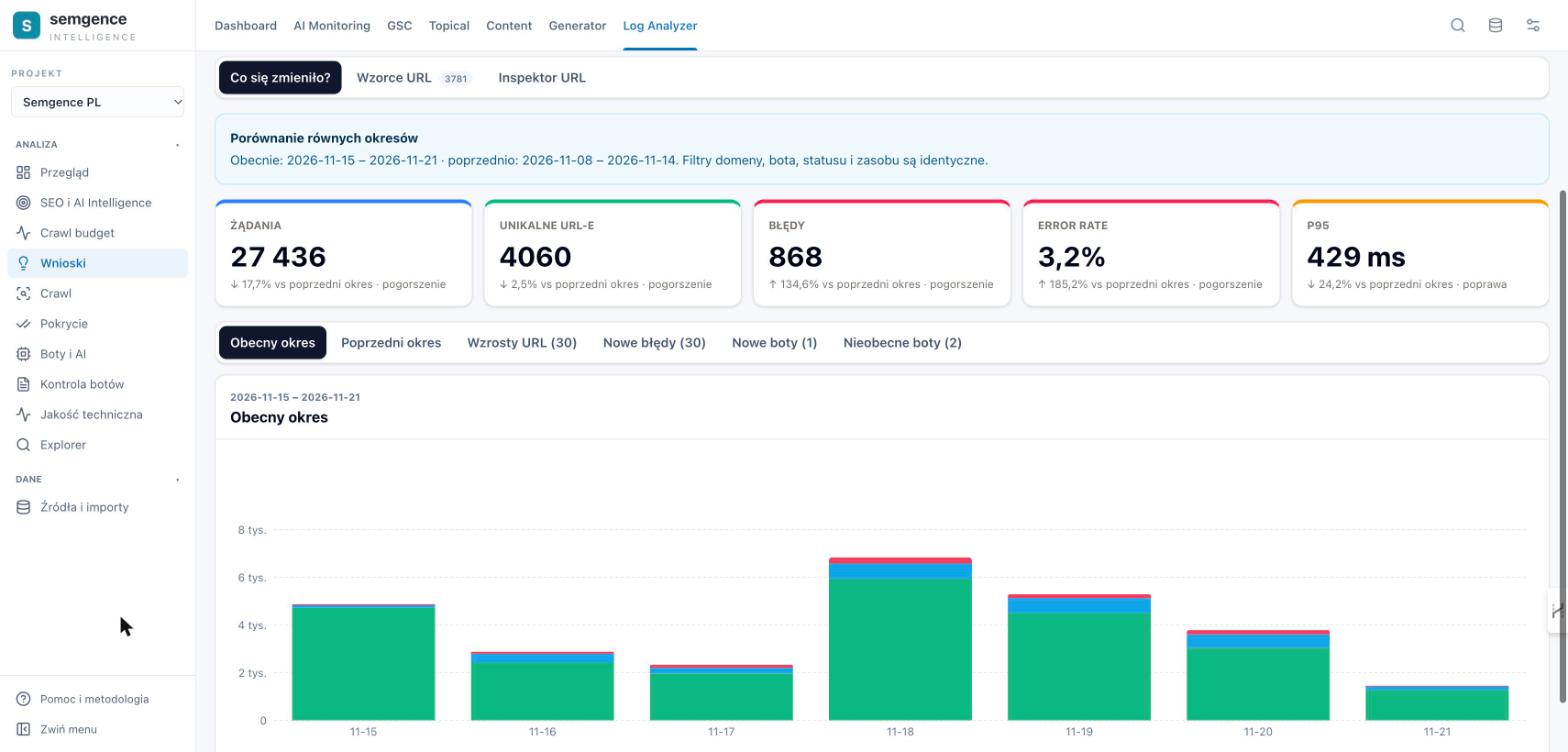
Incydenty system wykrywa sam, porównując dzień z wartością bazową. W badanym okresie znalazł trzy:
| Dzień | Typ | Wartość | Baza | Ważność |
|---|---|---|---|---|
| 11.11 | Nietypowa aktywność crawlerów | 22 483 żądania | ok. 5066 | krytyczny |
| 13.11 | Skok błędów HTTP | 9,3% | 3,2% | ostrzeżenie |
| 17.11 | Skok błędów HTTP | 5,2% | 3,2% | ostrzeżenie |
Incydent z 11 listopada okazał się najciekawszym znaleziskiem całej analizy. Tego dnia przyszło ponad 22 tysiące żądań, z czego 20 837 z user-agentem „Googlebot Desktop”, ale z IP spoza zakresów Google. Jedna podsieć wysłała 17 523 żądania w kilkanaście godzin, głównie do obrazków. Bez weryfikacji ten dzień wyglądałby jak nagły wzrost zainteresowania Google.
Metoda wykrywania jest dziś prosta: baza to średnia dzienna z zakresu, a progi to jej wielokrotności. Taka średnia obejmuje sam dzień incydentu, więc jeden duży skok zawyża bazę dla całego okresu. Lepiej sprawdzi się mediana z poprzednich 28 dni bez dnia analizowanego, z sezonowością tygodniową i osobnymi bazami dla Google, botów AI i pozostałych.
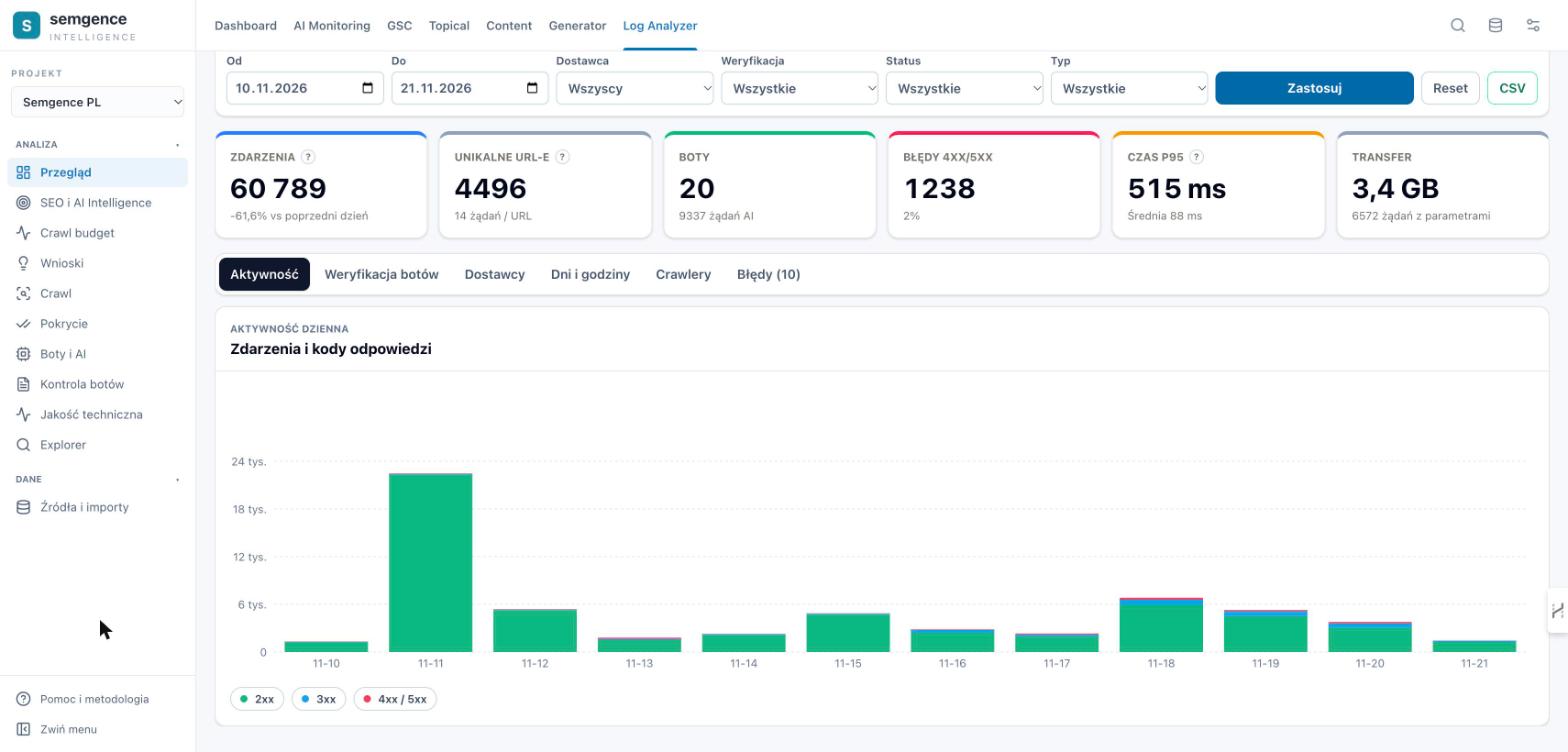
Porównanie okresów zestawia dwa tygodnie przy identycznych filtrach. Dla 15-21.11 względem 8-14.11 liczba żądań spadła o 17,7%, błędy wzrosły o 134,6% (do 868), a czas P95 poprawił się o 24,2%, do 429 ms. Zakładka „Nowe błędy” daje gotową listę adresów do sprawdzenia przekierowań.
Jak udostępniliśmy analitykę przez MCP?
Analizator jest dostępny w serwerze MCP AI Monitora jako 22 narzędzia tylko do odczytu. Agent AI (u nas Claude) wywołuje je w rozmowie i łączy z narzędziami do GSC, GA4, crawla i WordPressa. Narzędzia pokrywają stan danych i jakość parsera, zapytania z grupowaniem po dowolnym wymiarze, katalog botów i świeżość pobrań przez boty AI, efektywność crawlu, wzorce URL-i i pokrycie, historię pojedynczego adresu z danymi GSC i GA4, audyt robots.txt oraz incydenty z wyjaśnieniem i porównania okresów.
Dlaczego z poziomu MCP analizuje się łatwiej? Bo agent zadaje kolejne pytania, zanim człowiek zdąży przeklikać filtry. Przy pisaniu tego tekstu wyglądało to tak:
log_analyzer_list_incidentszwróciło krytyczny incydent z 11 listopada.log_analyzer_explain_incidentpokazało, że 20 837 z 20 960 żądań „Googlebot Desktop” tego dnia jest niepotwierdzonych.log_analyzer_queryz grupowaniem po podsieci wskazało jedną podsieć z 17 523 żądaniami.log_analyzer_queryz grupowaniem po kodzie dla potwierdzonego Googlebota pokazało 1875 odpowiedzi 304 – i wyjaśniło, skąd 22,9% waste’u.
Cztery wywołania, kilkadziesiąt sekund. W panelu to samo wymaga kilku widoków i ręcznego liczenia. Ograniczenia ustawiliśmy celowo: narzędzia tylko czytają, żadne nie zwraca poświadczeń ani surowych IP, każda odpowiedź zawiera zakres dat, a wyniki są przycięte do najważniejszych pozycji.
// wywołanie
{ "tool": "log_analyzer_query",
  "arguments": { "project_id": 1, "group_by": "status",
                 "vendor": "google", "verdict": "confirmed" } }

// odpowiedź (fragment)
{ "range": { "from": "2026-11-10", "to": "2026-11-21" },
  "rows": [
    { "key": "200", "requests": 7563, "urls": 1057 },
    { "key": "304", "requests": 1875, "urls": 411, "average_ms": 3.21 },
    { "key": "301", "requests": 278,  "urls": 24 },
    { "key": "404", "requests": 54,   "urls": 13 } ] }
Jakie błędy popełniliśmy podczas projektowania?
Rozłożenie liczb na części ujawniło kilka błędów. Ta lista jest jednocześnie naszą listą poprawek.
Deduplikacja tylko na poziomie plików. System pomijał identyczne pliki, ale nie deduplikował zdarzeń między plikami. Hosting rotuje logi (access.log → access.log.1 → access.log.2.gz), plik skompresowany ma inny hash niż ten sam plik przed kompresją, a kolejne kopie rosnącego access.log dodają stare linie jeszcze raz. Audyt znalazł 101 219 zapisanych zdarzeń i tylko 67 645 unikalnych – około 33% powtórzeń. Poprawka: deduplikacja po hashu nieskompresowanej linii i zapamiętywanie pozycji w rosnącym pliku.
304 liczone jako strata. Wszystkie kody 3xx trafiały do przekierowań, co podniosło waste Googlebota z około 3,7% do 22,9%.
Dwie definicje tego samego wskaźnika. Panel liczył parametry tylko dla HTML (61 żądań), MCP dla wszystkich zasobów (6313). Te same dane dawały 7,5% w panelu i 17,7% w MCP. Wskaźnik musi mieć jedną, wersjonowaną definicję, z której czytają panel i MCP.
Etykieta, która mówi więcej, niż wie. Katalog botów pokazywał przy Googlebot Desktop „Potwierdzony ruch”, bo wystarczyło jedno potwierdzone żądanie. Zamiast etykiety potrzebny jest udział (np. „98 potwierdzonych z 20 935 – ruch mieszany”).
Własny ruch jako ruch botów. Nasz agent łączący się z WordPressem był liczony jak zewnętrzny bot AI. Ruch własnych narzędzi trzeba klasyfikować osobno, ale nie przez wycięcie całego user-agenta.
error.log w imporcie. Synchronizacja pobierała wszystkie pliki .log, także logi błędów. Docelowo przyjmujemy tylko logi dostępu.
Łączenie z GA4 po złym kluczu. Strona usługowa z 58 kliknięciami w GSC miała w macierzy 0 sesji GA4. Względna ścieżka z GA4 (np. /kampanie-sem/) była traktowana jak nazwa domeny, a warianty tego samego adresu nadpisywały się zamiast sumować. Faktycznie strona miała około 35 sesji.
Pokusa wnioskowania o indeksacji z crawlu. To, że Googlebot regularnie pobiera URL, nie znaczy, że wszystko jest w porządku. Każdy wniosek o stronie wymaga zestawienia z GSC.
Kolejność poprawek ustaliliśmy tak, żeby najpierw naprawić to, co zmienia liczby: deduplikacja, wyłączenie 304, jedna definicja metryk i łączenie GA4 z GSC. Dopiero potem przeliczenie agregatów i cache.
Checklista budowy własnego analizatora logów
Dane wejściowe
- Format logu z hostem (przy serwerze współdzielonym) i plan na zmiany formatu
- Import ręczny i synchronizacja FTP/FTPS/SFTP raz na dobę, konto tylko do odczytu
- Poświadczenia szyfrowane, nigdy nie zwracane przez API ani MCP
- Tylko logi dostępu, bez
error.log - Deduplikacja zdarzeń, nie tylko plików
Parser i dane
- Filtr obcych domen i ruchu ludzi, licznik odrzuconych linii z powodem
- Wspólna normalizacja URL-i dla logów, GSC, GA4 i crawla
- Usuwanie wartości parametrów i maskowanie IP
- Surowe pliki oddzielnie, z ograniczonym dostępem i osobną retencją
Boty
- Rozpoznanie po user-agencie z dostawcą i rolą
- Weryfikacja przez oficjalne listy IP z odświeżaniem, docelowo także reverse DNS
- Statusy z udziałem: potwierdzony, mieszany, niepotwierdzony, brak listy
- Osobna klasa dla własnych agentów i wewnętrznych API
Analiza i operacje
- Crawl waste osobno dla każdej grupy botów, na zweryfikowanym ruchu, bez 304
- Jedna definicja wskaźników dla panelu i MCP
- Macierz undercrawl / overcrawl / waste / healthy na danych z GSC i GA4
- Historia URL-a i świeżość pobrań przez boty AI
- Baza alertów z mediany poprzednich dni, bez dnia analizowanego
- MCP tylko do odczytu, z zakresem dat w każdej odpowiedzi
Co się zmieniło po poprawkach?
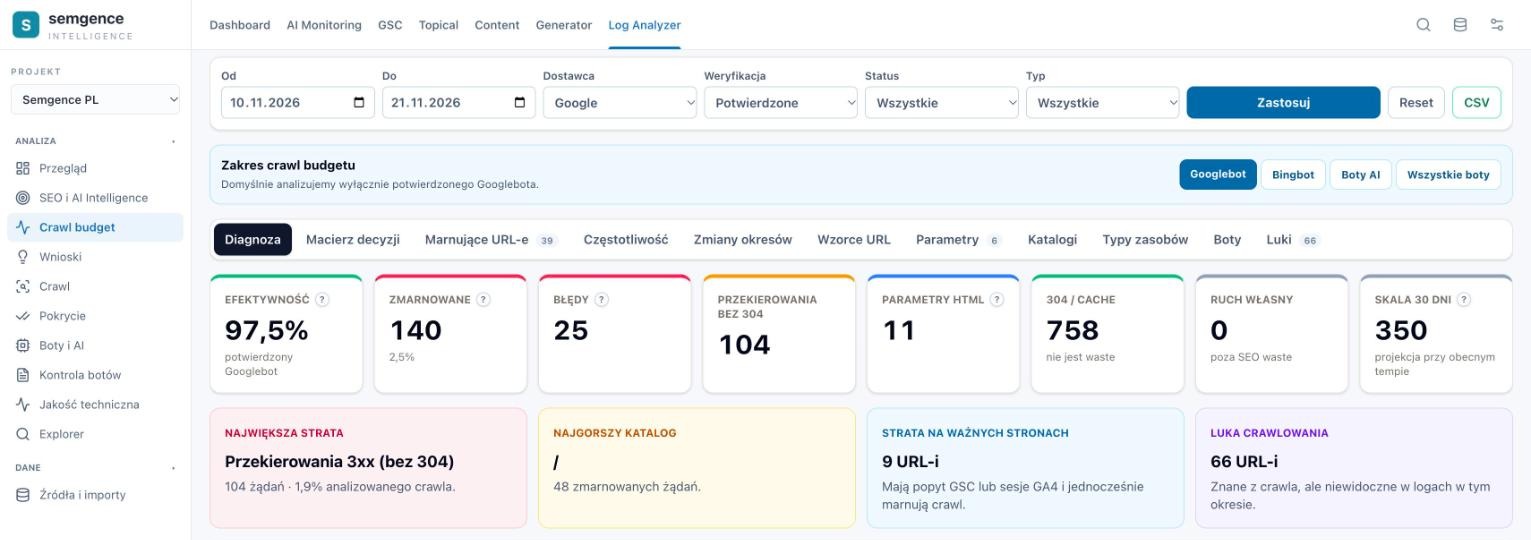
Poprawki z poprzedniej sekcji wdrożyliśmy kilka godzin po pierwszej analizie: deduplikację zdarzeń po hashu linii, osobną kategorię dla 304, odfiltrowanie ruchu własnego agenta z SEO waste i pomijanie error.log. Ten sam okres (10-21 listopada) po przeliczeniu:
| Wskaźnik | Pierwszy raport | Po poprawkach |
|---|---|---|
| Żądania rozpoznanych botów po parserze | 104 242 | 71 026 |
| Usunięte duplikaty linii | – | 226 927 |
| Linie odrzucone | 807 | 0 |
| Zdarzenia w analizie | 60 789 | 45 204 |
| Udział niepotwierdzonych | 65% | 74% |
| Żądania botów AI | 9337 (ok. 15%) | 4565 (ok. 10%) |
| Waste: Googlebot (potwierdzony) | 22,9% | 2,5% |
| Waste: Bingbot (potwierdzony) | 9,4% | 2,4% |
| Waste: boty AI | 17,1% | 15,7% |
| Waste: wszystkie rozpoznane boty | 7,5% | 2,0% |
Trzy rzeczy z tej tabeli warto zapamiętać. Po pierwsze, crawl waste Googlebota spadł z prawie 23% do 2,5% bez żadnej zmiany na stronie – zmieniła się tylko definicja i jakość danych. 758 odpowiedzi 304 jest teraz liczonych jako walidacja cache, a nie strata. Po drugie, udział niepotwierdzonych „botów” wzrósł do 74%, bo deduplikacja usunęła powtórzenia prawdziwego ruchu, a 20 837 żądań fałszywego Googlebota z 11 listopada było unikalnych i zostało. Po trzecie, waste botów AI prawie się nie zmienił: po odjęciu 1193 żądań naszego agenta zostają realne błędy i przekierowania, głównie na stronie głównej – i to jest rzecz do poprawienia na stronie, a nie w narzędziu.
Podsumowanie
Analizator logów to przede wszystkim pipeline, a dopiero potem dashboard. Pierwszy raport z logów semgence.pl pokazał 104 242 żądania botów i 22,9% crawl waste u Googlebota. Po deduplikacji i poprawie definicji zostało 71 026 żądań i 2,5% waste’u – a trzy czwarte ruchu podpisanego nazwą znanego bota nadal nie przechodzi weryfikacji. Największe „problemy” z pierwszego raportu okazały się duplikatami, odpowiedziami 304 i naszym własnym agentem.
Wniosek: każdą liczbę z logów trzeba rozłożyć na składniki, zanim zamieni się ją w rekomendację. Rozdziel warstwy danych, deduplikuj zdarzenia, weryfikuj boty, licz waste osobno dla każdej grupy i bez 304, trzymaj jedną definicję wskaźników i zawsze zestawiaj crawl z GSC, bo crawl nie oznacza indeksacji.
Jeśli w Twoim serwisie ważne podstrony długo czekają na odświeżenie w Google albo nie wiesz, czy boty AI docierają do treści, które mają być cytowane, analizę aktywności botów i crawl budgetu robimy na logach serwera w ramach audytu technicznego – napisz do nas.
Dane: semgence.pl, logi z 10-21 listopada 2026. Liczby w tekście pochodzą z pierwszego raportu (przed poprawkami), a sekcja „Co się zmieniło po poprawkach?” pokazuje ten sam okres po przeliczeniu z 21 listopada 2026. Wskaźniki opisują jeden serwis i jeden okres – nie są benchmarkiem.
FAQ
Czy analiza logów jest potrzebna małym stronom?
Jako stały monitoring zwykle nie – przewodnik Google o budżecie indeksowania dotyczy głównie dużych i często aktualizowanych serwisów. Jednorazowa analiza przydaje się jednak każdej stronie przy migracji, spadku widoczności albo podejrzeniu, że boty dostają błędy.
Czy jeśli Googlebot pobrał stronę, to znaczy, że jest zindeksowana?
Nie. Pobranie to pierwszy etap, a indeksowanie nie jest gwarantowane. Stan indeksu sprawdzasz w Google Search Console.
Jak sprawdzić, czy Googlebot w logach jest prawdziwy?
Odwrotne zapytanie DNS dla IP, sprawdzenie, czy domena to googlebot.com, google.com lub googleusercontent.com, i zapytanie DNS w przód, które musi zwrócić to samo IP. Przy dużej skali – porównanie IP z listami zakresów publikowanymi przez Google.
Czy odpowiedź 304 to strata crawl budgetu?
Nie. 304 oznacza, że strona się nie zmieniła i bot nie musiał jej pobierać ponownie. Jeśli Twoje narzędzie liczy 304 jako przekierowanie, waste będzie zawyżony.
Jak często synchronizować logi?
Dla analizy SEO zwykle wystarcza raz na dobę.
Czy można przechowywać pełne adresy URL z parametrami?
Lepiej nie. Wartości parametrów mogą zawierać dane osobowe, tokeny i numery zamówień. Do analizy SEO wystarczą nazwy parametrów.
Czy z logów dowiem się, czy ChatGPT cytuje moją stronę?
Nie. Logi pokazują, czy boty AI pobierają strony i jakie odpowiedzi dostają. Obecność w odpowiedziach AI sprawdza się monitoringiem tych odpowiedzi.
Dlaczego MCP, a nie tylko dashboard?
Bo agent może zadawać kolejne pytania do danych i łączyć je z innymi źródłami w jednej rozmowie. Wyjaśnienie incydentu, które w panelu wymaga kilku widoków, przez MCP zajmuje kilka wywołań.