W październiku Google nie wypuścił core update, ale zmienił sporo w dokumentacji jakości. Napisał, że ręczne sprawdzanie faktów w treściach z AI jest bardzo ważne, łącznie z tytułami, opisami meta i tekstem alternatywnym obrazków. Opisał też, czym jest treść główna strony i jak oceniają ją raterzy, a fałszywe profile autorów nazwał wprost oszustwem. 8 października skończył się wrześniowy spam update, jedyna potwierdzona aktualizacja miesiąca. 30 października Google, Microsoft, OpenAI i Anthropic zapowiedzieli obsługę wspólnego sygnału w robots.txt do blokowania trenowania AI, który Google i Bing chcą obsługiwać od 2027 roku. Do tego Gary Illyes pokazał, ile zwykle trwa odkrywanie, indeksowanie i odbicie po aktualizacji, a część narzędzi do śledzenia pozycji zbierała fałszywe wyniki.
To kolejny odcinek naszego miesięcznego przeglądu. Poprzedni opisuje, co się działo w SEO we wrześniu. Wiadomości z ChatGPT, Gemini i innych asystentów zebraliśmy osobno w przeglądzie AI Search w październiku. Każdą informację poniżej sprawdziliśmy w źródle: w dokumentacji Google, na Status Dashboard albo w relacjach branżowych, głównie Search Engine Roundtable, jeśli Google nie opublikował niczego sam.
Co zmieniło się w wytycznych Google o jakości treści?
Google w październiku zmienił trzy rzeczy: zalecił ręczne sprawdzanie treści z AI, zdefiniował treść główną i cztery cechy jej jakości, a fałszywe profile autorów nazwał oszustwem. Dotyczy to każdego, kto publikuje treści pisane z pomocą AI, i wszystkie trzy zmiany są w oficjalnej dokumentacji Search Central, a nie tylko w wypowiedziach pracowników.
Treści z AI trzeba sprawdzać ręcznie. 1 października Google zaktualizował wytyczne o korzystaniu z generatywnej AI. Napisał, że przed publikacją bardzo ważne jest ręczne sprawdzenie faktów i wiarygodności wszystkiego, co wygenerowała AI (Google Search Central: using generative AI content). Dotyczy to nie tylko tekstu strony, ale też tytułów, opisów meta i tekstu alternatywnego obrazków, bo mogą pojawić się w wynikach wyszukiwania. Dane strukturalne generowane przez AI muszą spełniać wytyczne i być zwalidowane. Google uzasadnia to tym, że modele przewidują kolejne słowa, a nie pobierają faktów.
Google zdefiniował treść główną i cztery cechy jej jakości. Od 1 października dokument o pomocnych treściach opisuje, co Google uważa za treść główną strony: tekst i media, narzędzia interaktywne, treści użytkowników, jeśli realizują cel strony, zawartość zakładek i rozwijanych sekcji oraz widoczne tytuły i nagłówki (Google Search Central: creating helpful content). Raterzy, czyli osoby oceniające wyniki dla Google według wytycznych Search Quality Rater Guidelines, oceniają jakość tej treści według czterech cech: wysiłku, oryginalności, talentu lub umiejętności i dokładności. Google zaznacza, że dane od raterów nie trafiają wprost do algorytmów i służą do sprawdzania, czy systemy działają dobrze. Sama lektura wytycznych ma jednak pomóc zrozumieć, jakie sygnały biorą pod uwagę automatyczne systemy. Ważne jest jedno zdanie o wysiłku. Automatyczne generowanie stron z feedów albo dużych ilości tekstu AI bez nadzoru to według Google treść, w którą włożono niewiele wysiłku lub nie włożono go wcale, a podanie źródeł nie zastępuje własnej pracy.
Fałszywi autorzy to oszustwo. W tym samym dokumencie Google dopisał, że wymyślanie profili autorów, czyli zdjęcia generowane przez AI, zmyślone nazwiska i nieprawdziwe kwalifikacje, jest formą oszustwa, przez które strona traci wiarygodność w oczach ludzi i automatycznych systemów oceny jakości, i jest sygnałem strony niskiej jakości. Z naszych obserwacji wynika, że w Polsce to wcale nie rzadka praktyka, bo „ekspert” z wygenerowanym zdjęciem miał budować E-E-A-T. Teraz Google nazywa to wprost.
Te zmiany są spójne z tym, co pracownicy Google mówili na przełomie września i października na Search Central Live Deep Dive w Barcelonie. Według relacji Johna Campbella Gary Illyes stwierdził tam, że skalowane treści stają się większym problemem niż spam linkowy (relacja We Are Roast). Jeśli publikujesz treści z AI, opisaliśmy szerzej, jak Google traktuje treści produktowe generowane przez AI. Naszym zdaniem październikowe zmiany to dobry moment na przegląd treści pod kątem tych czterech cech, zanim zrobi to kolejna aktualizacja.
Czy w październiku była aktualizacja algorytmu Google?
Nie było core update. Jedyną potwierdzoną aktualizacją był September 2026 spam update, który zaczął się 24 września, a skończył 8 października (Google Search Status Dashboard). Trwał 13 dni i 16 godzin, czyli dużo dłużej niż sierpniowy, który zamknął się w niecałe trzy dni. Google podał, że obejmuje wszystkie kraje i języki, więc dotyczy też polskich stron. W Barcelonie pracownicy Google tłumaczyli, że spam update’ów jest więcej, bo w sieci przybywa dużo nowych treści, a do wyłapywania spamu zespół używa teraz także AI (Search Engine Roundtable). Jeśli w GSC widzisz spadek w okolicach 24 września – 8 października, to on jest pierwszym podejrzanym.
Druga połowa miesiąca była niespokojna mimo braku ogłoszeń. Barry Schwartz opisywał skoki zmienności w okolicach 16, 20-21, 24 i 26-27 października, a w komentarzach pojawiały się też skargi na słaby ruch z Discover (Search Engine Roundtable). Google ich nie potwierdził. Marie Haynes napisała, że dostaje dużo więcej próśb o pomoc przy ręcznych działaniach: wcześniej prawie żadnych, teraz kilka tygodniowo, choć według niej to wciąż dużo mniej niż przed erą Pingwina. Chodzi o thin content, czysty spam i skalowane treści, a większość tych stron to według niej legalne firmy działające od lat (Search Engine Roundtable). To obserwacja jednej specjalistki, nie dane Google, ale pasuje do kierunku z dokumentacji.
John Mueller w wywiadzie opublikowanym pod koniec miesiąca skomentował modę na masowe publikowanie list rankingowych pod AI. Same listicle nie są spamem, ale tysiące takich tekstów jako cała strategia to ryzyko, bo według niego „at some point the systems catch” (Search Engine Roundtable).
Ile trwa crawlowanie i indeksowanie według Google?
Według danych, które Gary Illyes pokazał w Barcelonie, odkrycie nowego adresu URL zajmuje zwykle około 20 godzin, a indeksowanie od pobrania do wyników około 1,5 godziny. Odbicie po core update trwa zwykle 3-6 miesięcy. Illyes zestawił typowy czas z najwolniejszym dla 23 sytuacji, a relacje z wydarzenia opublikowano na początku października. Poniżej wybraliśmy 11 z nich (Search Engine Roundtable).
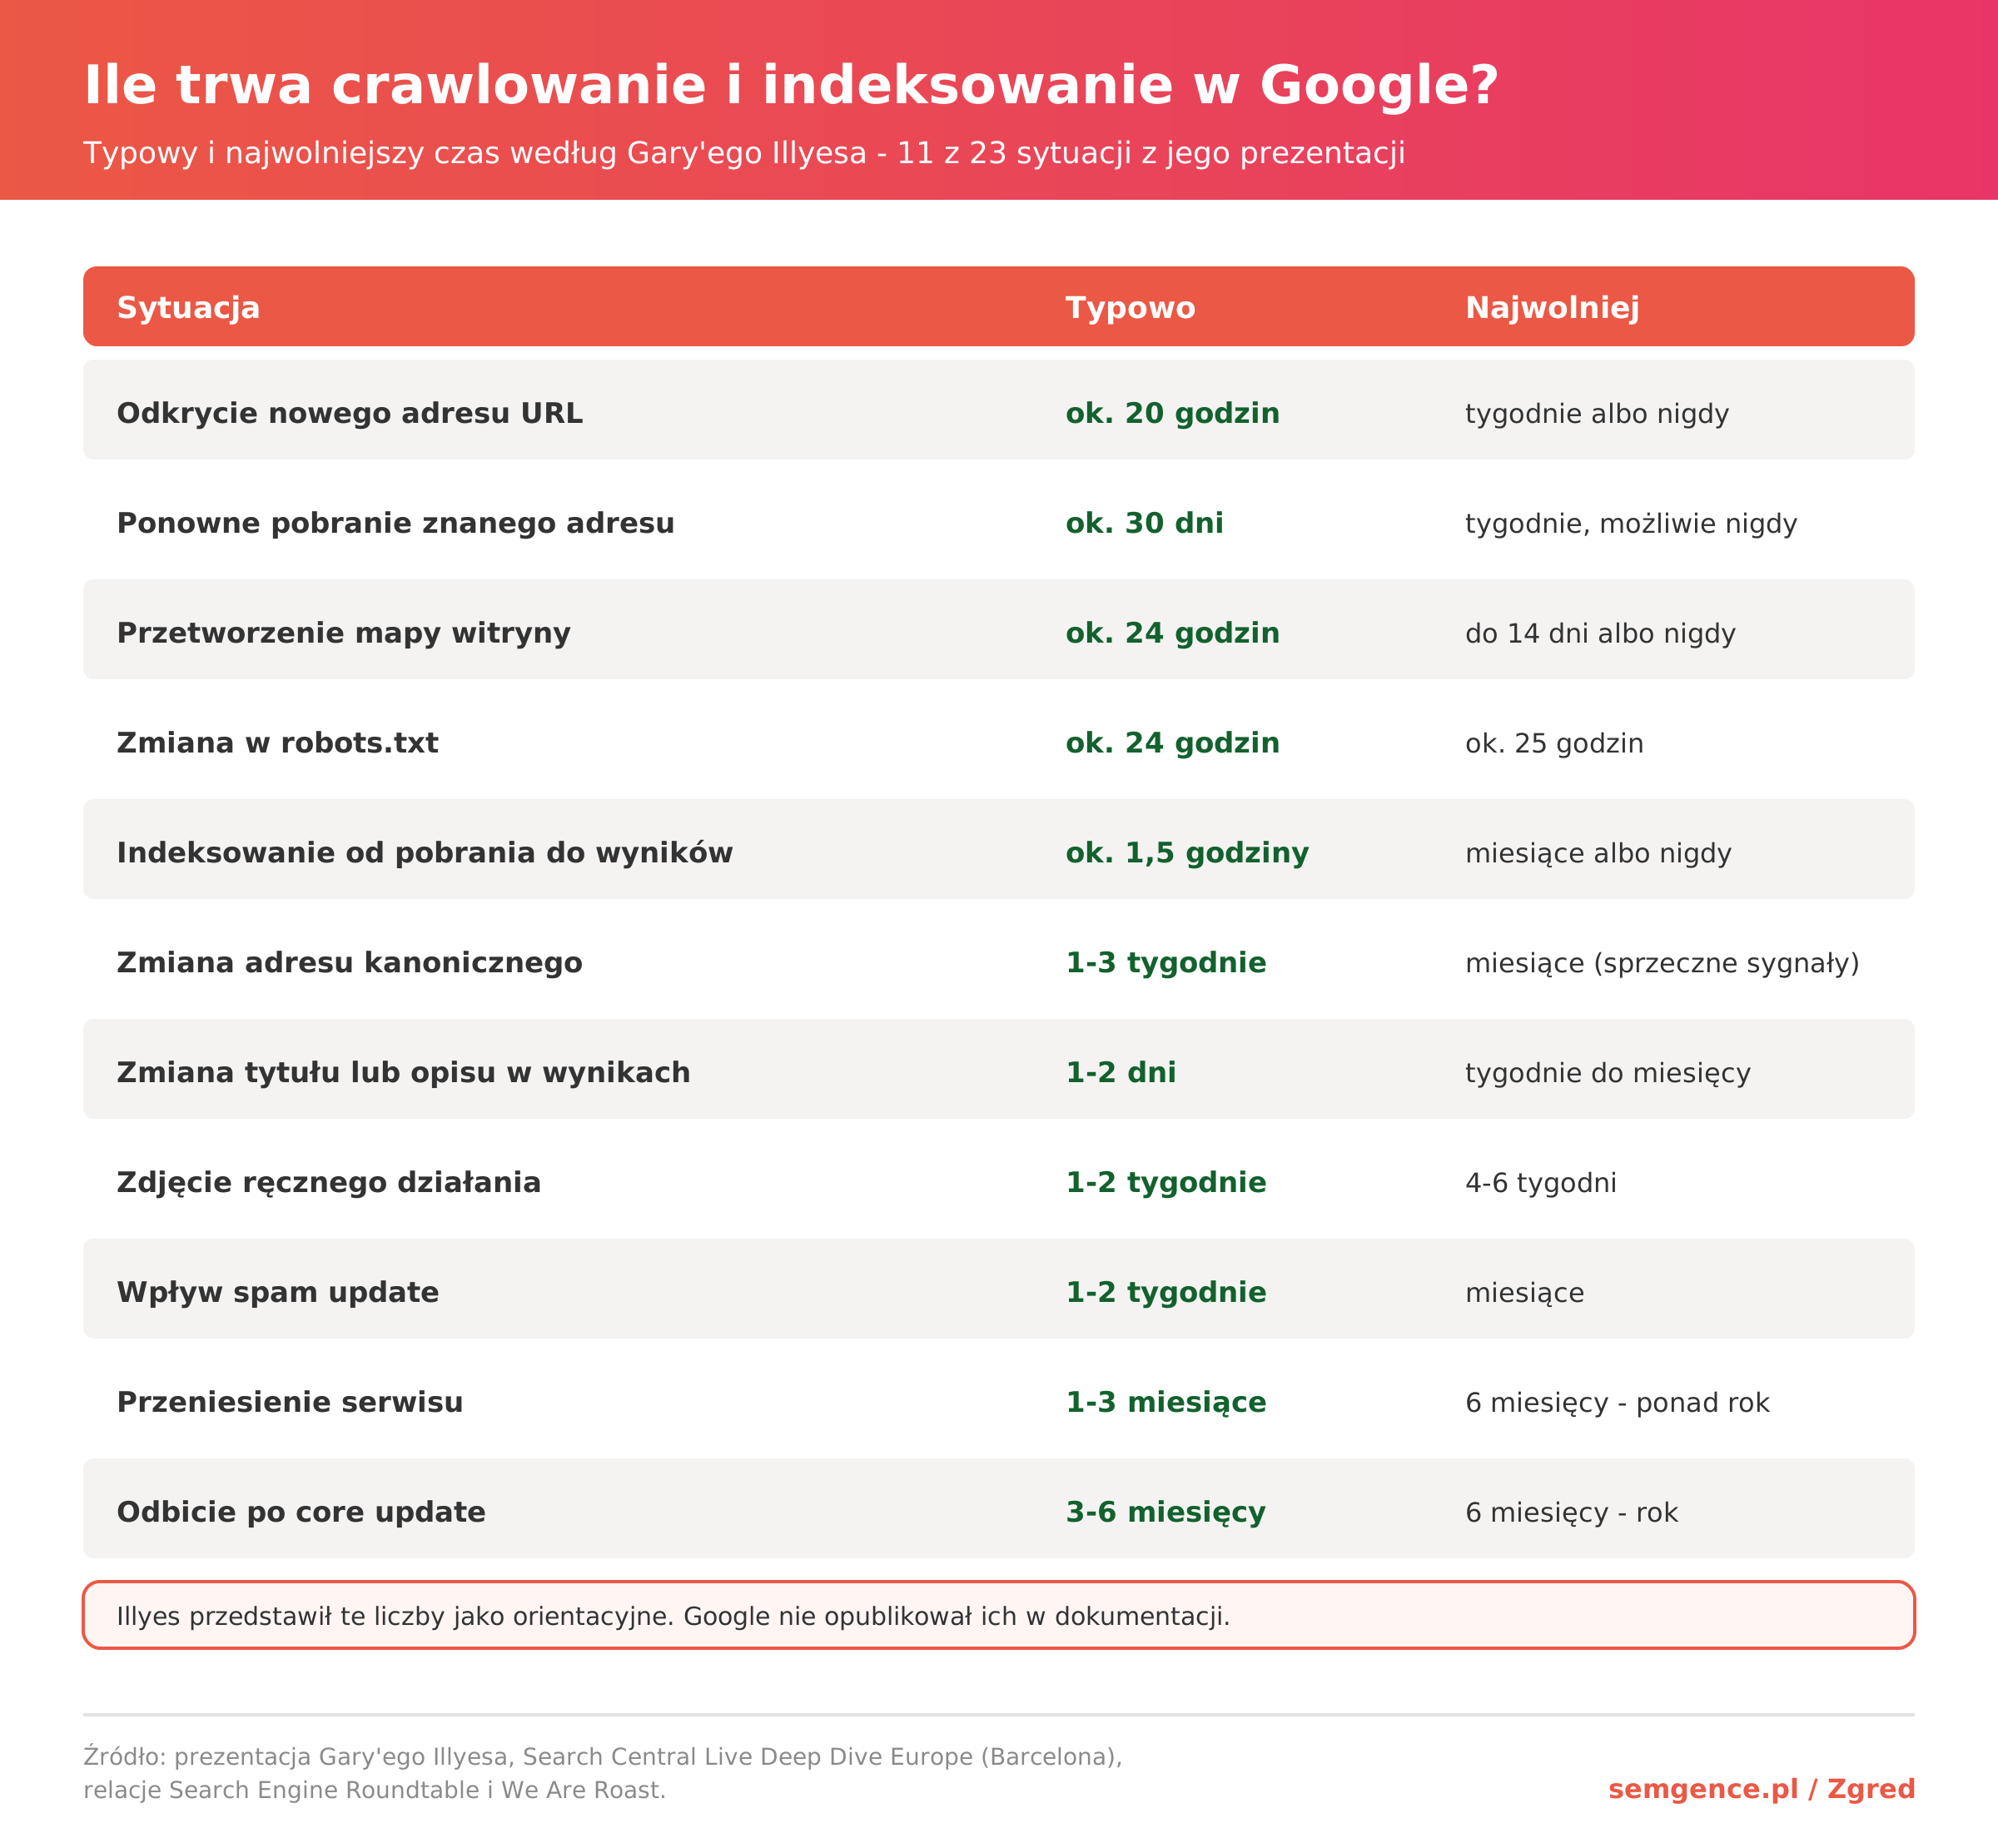
| Sytuacja | Typowo | Najwolniej |
|---|---|---|
| Odkrycie nowego adresu URL | ok. 20 godzin | tygodnie albo nigdy |
| Ponowne pobranie znanego adresu | ok. 30 dni | tygodnie albo nigdy |
| Przetworzenie mapy witryny | ok. 24 godzin | do 14 dni albo nigdy |
| Uwzględnienie zmiany w robots.txt | ok. 24 godzin | ok. 25 godzin |
| Indeksowanie od pobrania do wyników | ok. 1,5 godziny | miesiące albo nigdy |
| Zmiana adresu kanonicznego | 1-3 tygodnie | miesiące przy sprzecznych sygnałach |
| Przeniesienie serwisu | 1-3 miesiące | od 6 miesięcy do ponad roku |
| Zmiana tytułu lub opisu w wynikach | 1-2 dni | od kilku tygodni do miesięcy |
| Zdjęcie ręcznego działania | 1-2 tygodnie | 4-6 tygodni, w nieaktywnych serwisach znacznie dłużej |
| Odbicie po core update | 3-6 miesięcy | 6 miesięcy – rok (do kolejnego core update) |
| Wpływ spam update | 1-2 tygodnie | miesiące |
Te liczby trzeba czytać ostrożnie. Illyes napisał potem Barry’emu Schwartzowi, że było to ćwiczenie, które miało sprawdzić, czy słuchacze odnajdą się w liczbach wyciągniętych z wewnętrznych danych, a Google nie opublikował ich w dokumentacji. Przydają się jednak w rozmowie z klientem: przy migracji sklepu 1-3 miesiące na przeniesienie sygnałów to punkt wyjścia, a nie czarny scenariusz.
Dwie zmiany w dokumentacji crawlowania są z tego samego obszaru. 6 października Google opisał dokładniej nagłówek Retry-After przy odpowiedziach 503 i 429 i podkreślił, że obsługuje go od dawna (Google: reduce crawl rate). 16 października zmienił stronę z limitami Indexing API: usunął wzmiankę o limicie do testów, instrukcję proszenia o zatwierdzenie i dawny formularz. Nie napisał, czy sam wymóg zatwierdzenia zniknął, a domyślny limit to nadal 200 zapytań publikacji dziennie na projekt (Google: Indexing API quota). Indexing API nadal służy tylko do ofert pracy i transmisji na żywo, więc zgłaszanie nim zwykłych podstron dalej jest niezgodne z przeznaczeniem.
Co Google zapowiedział w sprawie robots.txt i trenowania AI?
30 października Google, Microsoft, OpenAI i Anthropic, każda firma osobno, zapowiedzieli obsługę wspólnego sygnału w robots.txt, którym strona może zablokować wykorzystanie treści do trenowania AI (Search Engine Roundtable). Sygnał wywodzi się z prac grupy AIPREF w IETF. Google planuje go obsługiwać od 2027 roku (Google Search Central Blog), a w dokumentacji crawlerów podaje termin „early 2027” i składnię user-agent: __usage_ai-training (Google: common crawlers). Jeśli strona zablokuje tym tokenem trenowanie, a nie wskaże wprost Google-Extended, Google zamierza traktować to jak blokadę Google-Extended. Google powołuje się przy tym na unijny kodeks praktyk dla modeli AI ogólnego przeznaczenia, przygotowany w ramach AI Act.
Microsoft podał dokładniejszy harmonogram dla Binga (Bing Webmaster Blog):
- 15 grudnia 2026: tymczasowe ustawienie groundingu w Bing Webmaster Tools dla stron, które używają NoArchive lub NoCache.
- 1 lutego 2027: Bing zaczyna respektować nowe preferencje.
- 1 marca 2027: termin przejścia ze starych dyrektyw NoArchive i NoCache.
Bing rozdziela przy tym trenowanie i grounding, czyli wykorzystanie treści do generowania odpowiedzi. Nowa preferencja DisallowExtended pozwala zostawić grounding w produktach Microsoftu, czyli w Bingu, Copilocie i Microsoft 365, a wyłączyć go w usługach dla firm trzecich. Preferencje nie wpływają na to, czy strona może pojawiać się w zwykłych wynikach Binga.
Na razie większość stron nie musi niczego zmieniać, bo sygnał ma działać dopiero w 2027 roku. Wyjątek to strony, które przez NoArchive lub NoCache ograniczają wykorzystanie treści w Copilocie i do trenowania modeli Microsoftu: mają czas do 1 marca 2027 na przejście na nowe preferencje. Trzeba też pilnować jednego rozróżnienia: token dotyczy trenowania, a nie widoczności w wyszukiwarce Google ani w AI Overviews. Działa jednak jak blokada Google-Extended, więc może ograniczyć cytowanie strony w aplikacji Gemini. Do wyłączenia strony z AI Overviews i AI Mode służy osobna kontrolka w Search Console, o której piszemy niżej.
W tym samym miesiącu Google uruchomił serię wideo „The Non-Canonical Cabinet”. W odcinku o adresach URL Gary Illyes nazwał słowa kluczowe w adresie „incredibly small signal” (Search Engine Roundtable). W odcinku z 21 października Google przypomniał zasady robots.txt, zgodne ze standardem RFC 9309, i dopisał do specyfikacji zalecenie, by znaki spoza ASCII w ścieżkach reguł zapisywać w kodowaniu procentowym (Google: crawling changelog). Google traktuje polskie znaki i ich zakodowaną postać tak samo, a kodowanie procentowe ma ułatwić przetwarzanie pliku narzędziom i usługom innych firm. Dla adresu /łóżka/ reguła w kodowaniu procentowym ma postać /%C5%82%C3%B3%C5%BCka/. 23 października Google doprecyzował też w dokumentacji struktury adresów URL, że myślniki wyraźnie oddzielają słowa, a podkreślniki nie (Google: URL structure).
Czy wyłączenie AI Overviews w Search Console się opłaca?
Jedyny publicznie opisany test, jaki znamy, sugeruje, że nie. Kontrolka „Search generative AI” w ustawieniach Search Console wyklucza stronę z AI Overviews, AI Mode i generatywnych funkcji w Discover. Google zebrał tę i inne opcje kontroli na jednej stronie dokumentacji (Google: control what you share). Google udostępnił ją wszystkim witrynom 31 sierpnia, a w październiku dopisał do pomocy, że właściciel domeny zobaczy powiadomienie, gdy właściwość podrzędna zmieni ustawienie (pomoc Search Console).
Pod koniec października Cyrus Shepard opisał na LinkedIn, co stało się po wyłączeniu AI Overviews i AI Mode na jego stronie. Szacuje, że CTR z wyświetleń w AI wynosił około 0,9%. Po wyłączeniu spadły jednak także kliknięcia ze zwykłych wyników organicznych (Search Engine Roundtable). To jedna witryna, więc nie traktujemy tego jako reguły. W naszej ocenie wystarczy to jednak, by nie wyłączać AI Overviews tylko dlatego, że raport pokazuje mało kliknięć. Ile ruchu realnie dają asystenci AI, sprawdzaliśmy w GA4 firm z naszego portfolio w tekście o tym, na które podstrony AI wysyła ruch.
15 października Google opisał też zmiany w samych AI Overviews i AI Mode: więcej linków w treści odpowiedzi i wyżej, test sekcji z jednym lub dwoma oficjalnymi linkami na górze odpowiedzi oraz karuzele artykułów w kolejnych językach (blog Google). Google podał, że liczba użytkowników funkcji preferowanych źródeł (Preferred Sources) wzrosła od początku roku ponad siedmiokrotnie. Nie podał, czy zmiany obejmują język polski.
Dlaczego narzędzia do śledzenia pozycji pokazywały dziwne dane?
Według Nozzle dlatego, że Google podsuwał części zapytań z narzędzi fałszywe strony wyników. Nozzle opisał 12 października, że od września Google szerzej blokuje adresy IP, częściej pokazuje captche i serwuje strony wyników, które wyglądają normalnie, ale mają podmienione wyniki. W ich danych dotyczyło to 8% stron wyników (Search Engine Roundtable). Śledzone domeny wypadały wtedy z top 10, a na ich miejscu pojawiały się fora i serwisy społecznościowe. Problemy zgłaszało kilka narzędzi, a pod koniec miesiąca potwierdził je Semrush, określając wpływ jako ograniczony. 16 października SE Ranking podał, że sprawdzanie pozycji działa już normalnie dla zdecydowanej większości fraz, a problem dotyczy jeszcze około 2% wyników. Google nie skomentował sprawy.
Mogło to dotyczyć każdego narzędzia, które pobiera wyniki Google. Jeśli w październiku widziałeś nagłe skoki pozycji, których nie potwierdza Search Console, to możliwe, że był to szum w danych, a nie zmiana w rankingu. Na takie okresy raporty dla klientów lepiej opierać na Search Console, pamiętając, że w październiku raport skuteczności miał chwilami ponad 64 godziny opóźnienia (Search Engine Roundtable).
Search Console dostał w październiku jedną praktyczną nowość: w raporcie skuteczności można zaznaczyć kilka krajów naraz i zobaczyć ich łączny ruch. Google ogłosił to 6 października w poście na LinkedIn. Przyda się sklepom, które sprzedają na przykład do Polski, Czech i Słowacji. Część właścicieli stron dostała też maile z liczbą użytkowników, którzy wybrali ich serwis jako preferowane źródło.
Co Google zmienił w zasadach dotyczących treści użytkowników?
Google w październiku zrobił dwa ruchy wokół treści użytkowników. 26 października rozszerzył dokument o zapobieganiu spamowi w treściach użytkowników o narzędzia, w których użytkownicy publikują udostępniane strony, wygenerowane treści albo aplikacje webowe (Google: prevent user-generated spam). Strony do współdzielenia linkiem powinny domyślnie mieć noindex albo być zablokowane w robots.txt. Lily Ray przypuszcza, że chodzi między innymi o publiczne strony generowane w narzędziach AI. Dotyczy to polskich SaaS-ów, kreatorów stron i platform, na których użytkownik może opublikować coś pod domeną firmy.
8 października Google opisał UGC Fresh Data Program. Zatwierdzone duże platformy z treściami użytkowników, na przykład fora i serwisy społecznościowe, mogą przekazywać świeże treści i dane o zaangażowaniu osobnym kanałem, poza zwykłym crawlowaniem (Google: UGC Fresh Data Program). Wymagania są wysokie: duża skala, stabilne adresy, publiczny dostęp bez logowania, ściśle zwalidowane dane strukturalne, a najlepiej przesyłanie treści w ciągu minut. Google odpowiada na wniosek w ciągu 6-8 tygodni. Google zastrzega, że udział w programie nie gwarantuje obecności w wynikach.
Co jeszcze warto wiedzieć z października?
Kilka krótszych informacji, które mogą mieć znaczenie dla polskich stron:
- Łatanie PHP. Po wykryciu krytycznych luk w PHP część stron zdjęto na czas łatania. Mueller przypomniał, że w takiej sytuacji serwer powinien zwracać 503, a nie przekroczenie czasu, 404 czy 500. Dokumentacja Google dodaje, że robots.txt nie może wtedy zwracać 503 (Google: pause online business), a jeśli Googlebot widzi błąd 503 na tym samym adresie przez kilka dni, adres może wypaść z indeksu (Google: reduce crawl rate). WordPress, WooCommerce i PrestaShop działają na PHP, więc dotyczy to bardzo wielu polskich sklepów i blogów.
- Favicon. Od 27 października dokumentacja wymaga, by Googlebot mógł przejść przekierowania ze strony głównej do strony, na której zdefiniowano faviconę, a Googlebot-Image miał dostęp do samego pliku. Żadnego z tych adresów nie można blokować w robots.txt (Google: favicon).
- JPEG XL. Mueller potwierdził, że Google Grafika i Discover nie obsługują tego formatu. Bezpieczne formaty to nadal między innymi WebP i AVIF.
- Linki spamowe. Mueller radził, by nie sugerować się tym, czy Search Console pokazuje spamowe linki, i przypadkowe spamowe linki po prostu ignorować. Google od dawna mówi, że raport linków pokazuje tylko ich próbkę. Szerzej o tym, jak Google ocenia jakość linków, pisaliśmy w osobnym artykule.
- Podszywanie się pod Googlebota. Illyes powiedział, że AI pogorszyła ten problem, i przypomniał, żeby weryfikować Googlebota po adresie IP i odwrotnym DNS.
- Profile w wyszukiwarce i Business Home. Google rozszerzył profile twórców i wydawców na Indie i Kanadę, a pod koniec października szerzej opisano Business Home, testowany od kilku miesięcy panel łączący profil firmy, Merchant Center, YouTube i Google Ads. Obie funkcje są na razie niedostępne w Polsce.
- Wyniki Alphabet. 28 października Sundar Pichai powiedział przy wynikach za trzeci kwartał, że liczba zapytań rośnie najszybciej od pięciu lat (raport Alphabet za Q3). Przychody z wyszukiwarki i pokrewnych usług wyniosły 63,35 mld dolarów, o 12% więcej niż rok wcześniej.
Co warto zrobić po październiku?
Przejrzeć treści pisane z pomocą AI pod kątem czterech cech jakości z dokumentacji Google, zaczynając od tych, które najbardziej wymagają odświeżenia, usunąć fikcyjnych autorów i sprawdzić, czy tytuły, opisy i teksty alternatywne też ktoś sprawdził. Jeśli widzisz spadki z przełomu września i października, porównaj je z oknem spam update (24 września – 8 października), a dane z narzędzi do śledzenia pozycji z tego okresu zweryfikuj w Search Console. Jeśli masz polskie znaki w regułach robots.txt, rozważ zapisanie ich w kodowaniu procentowym, żeby rozumiały je też inne narzędzia. Sygnał blokujący trenowanie AI ma działać od 2027 roku, więc na razie wystarczy zdecydować, czy będziesz go używać, chyba że używasz NoArchive lub NoCache. Naszym zdaniem ocena treści według tych czterech cech powinna być dziś podstawą każdego audytu treści.
Najczęściej zadawane pytania
Czy w październiku 2026 był core update Google?
Nie. Jedyną potwierdzoną aktualizacją był September 2026 spam update, który trwał od 24 września do 8 października i objął wszystkie kraje i języki. W drugiej połowie października obserwowano skoki zmienności, ale Google ich nie potwierdził.
Co Google pisze o sprawdzaniu treści z AI?
Od 1 października wytyczne Google mówią, że przed publikacją bardzo ważne jest ręczne sprawdzenie faktów i wiarygodności wszystkiego, co wygenerowała AI. Dotyczy to też tytułów, opisów meta, tekstu alternatywnego obrazków i danych strukturalnych.
Jakie cztery cechy jakości treści opisał Google?
Wysiłek, oryginalność, talent lub umiejętności i dokładność. Opisuje je dokument o pomocnych treściach jako cechy, według których raterzy Google oceniają jakość treści głównej strony. Strony generowane automatycznie z feedów albo dużych ilości tekstu AI bez nadzoru Google opisuje jako treść, w którą włożono niewiele wysiłku.
Jak zablokować trenowanie AI w robots.txt?
Google, Microsoft, OpenAI i Anthropic zapowiedzieli obsługę wspólnego sygnału w robots.txt opartego na pracach IETF. Google planuje go obsługiwać na początku 2027 roku, ze składnią user-agent: __usage_ai-training, a Bing od 1 lutego 2027. Sygnał dotyczy trenowania, a nie widoczności w wyszukiwarce Google ani w AI Overviews, ale może ograniczyć cytowanie strony w aplikacji Gemini.
Ile trwa indeksowanie nowej strony w Google?
Gary Illyes pokazał na Search Central Live Deep Dive Europe, że odkrycie nowego adresu trwa zwykle około 20 godzin, a indeksowanie od pobrania do wyników około 1,5 godziny. W najgorszym razie może to trwać miesiące albo strona nie zostanie zaindeksowana wcale. Illyes zaznaczył, że pokazał te liczby w ramach ćwiczenia na konferencji, a nie jako oficjalne dane.
Dlaczego narzędzia do śledzenia pozycji pokazują w październiku dziwne wyniki?
Według Nozzle Google podsuwał części zapytań z narzędzi fałszywe strony wyników, w ich danych 8% stron wyników. Semrush potwierdził problem, określając jego wpływ jako ograniczony. Nagłe skoki pozycji z tego okresu warto sprawdzić w Search Console.