W branży SEO powtarza się stwierdzenie, że linki „przekazują zaufanie”. To uproszczenie zniekształca rzeczywistość. Patent Google US9165040B1, zatytułowany Producing a ranking for pages using distances in a web-link graph, nie mierzy żadnego „zaufania” w potocznym sensie tego słowa. Mierzy dystans, czyli liczbę i jakość kroków dzielących ocenianą stronę od zbioru stron startowych (seed pages). Różnica między propagacją zaufania a pomiarem dystansu jest fundamentalna i zmienia sposób, w jaki powinniśmy oceniać wartość poszczególnych linków.
W tym artykule analizujemy oryginalne prace akademickie, patenty Google, dane z Google API Leak oraz statystyki SpamBrain, aby pokazać, jak naprawdę działa graf zaufania w wyszukiwarce i dlaczego popularne metryki SEO nie oddają tego mechanizmu.
Czy liczba linków decyduje o pozycji w grafie?
PageRank w pierwotnej formie z 1998 roku traktował sieć WWW jako głosowanie: każdy link to jeden głos, a głos ze strony o wielu głosach waży więcej. Model dawał prostą odpowiedź na pytanie o wartość strony – im więcej linków prowadzi do danego adresu URL, tym wyżej powinien się on znaleźć. Dwie dekady badań nad spamem, farmami linków i sieciami PBN pokazały jednak, że sama liczba linków to zaledwie jedno z wielu wymiarów problemu.
Teoria grafów oferuje inne spojrzenie. W grafie skierowanym, jakim jest sieć linków, kluczowe nie jest wyłącznie ile krawędzi wchodzi do danego węzła (stopień wejściowy), lecz jego położenie topologiczne – odległość od węzłów o określonych właściwościach. Strona z trzema linkami od witryn bliskich Wikipedii, portalom rządowym czy uznanym mediom zajmuje inną pozycję w grafie niż strona z trzystu linkami od izolowanego klastra blogów stworzonych wyłącznie na potrzeby link buildingu.
Ankiety ekspertów SEO konsekwentnie wskazują, że jakość i kontekst linków mają większe znaczenie niż sama ich liczba. W badaniu Zyppy z 2024 roku, na które powoływaliśmy się w analizie 21 lat ankiet i badań nad czynnikami rankingowymi, respondenci oceniali „autorytet domeny linkującej” wyżej niż „liczbę linków zwrotnych”. Patenty Google potwierdzają tę intuicję, choć mechanizm algorytmiczny jest inny, niż sugeruje popularne pojęcie „autorytetu domeny”.
Nie chodzi bowiem o to, czy link pochodzi ze strony „autorytatywnej” w jakimś abstrakcyjnym sensie. Chodzi o to, jak blisko w grafie znajduje się strona linkująca względem zbioru stron, które algorytm uznaje za wiarygodne punkty startowe. Zrozumienie tej mechaniki wymaga analizy dwóch dokumentów: pracy akademickiej TrustRank z 2004 roku i patentu Google złożonego dwa lata później, który rozwiązuje ten sam problem w fundamentalnie inny sposób.
Co oznacza „trusted seed” w patencie Google?
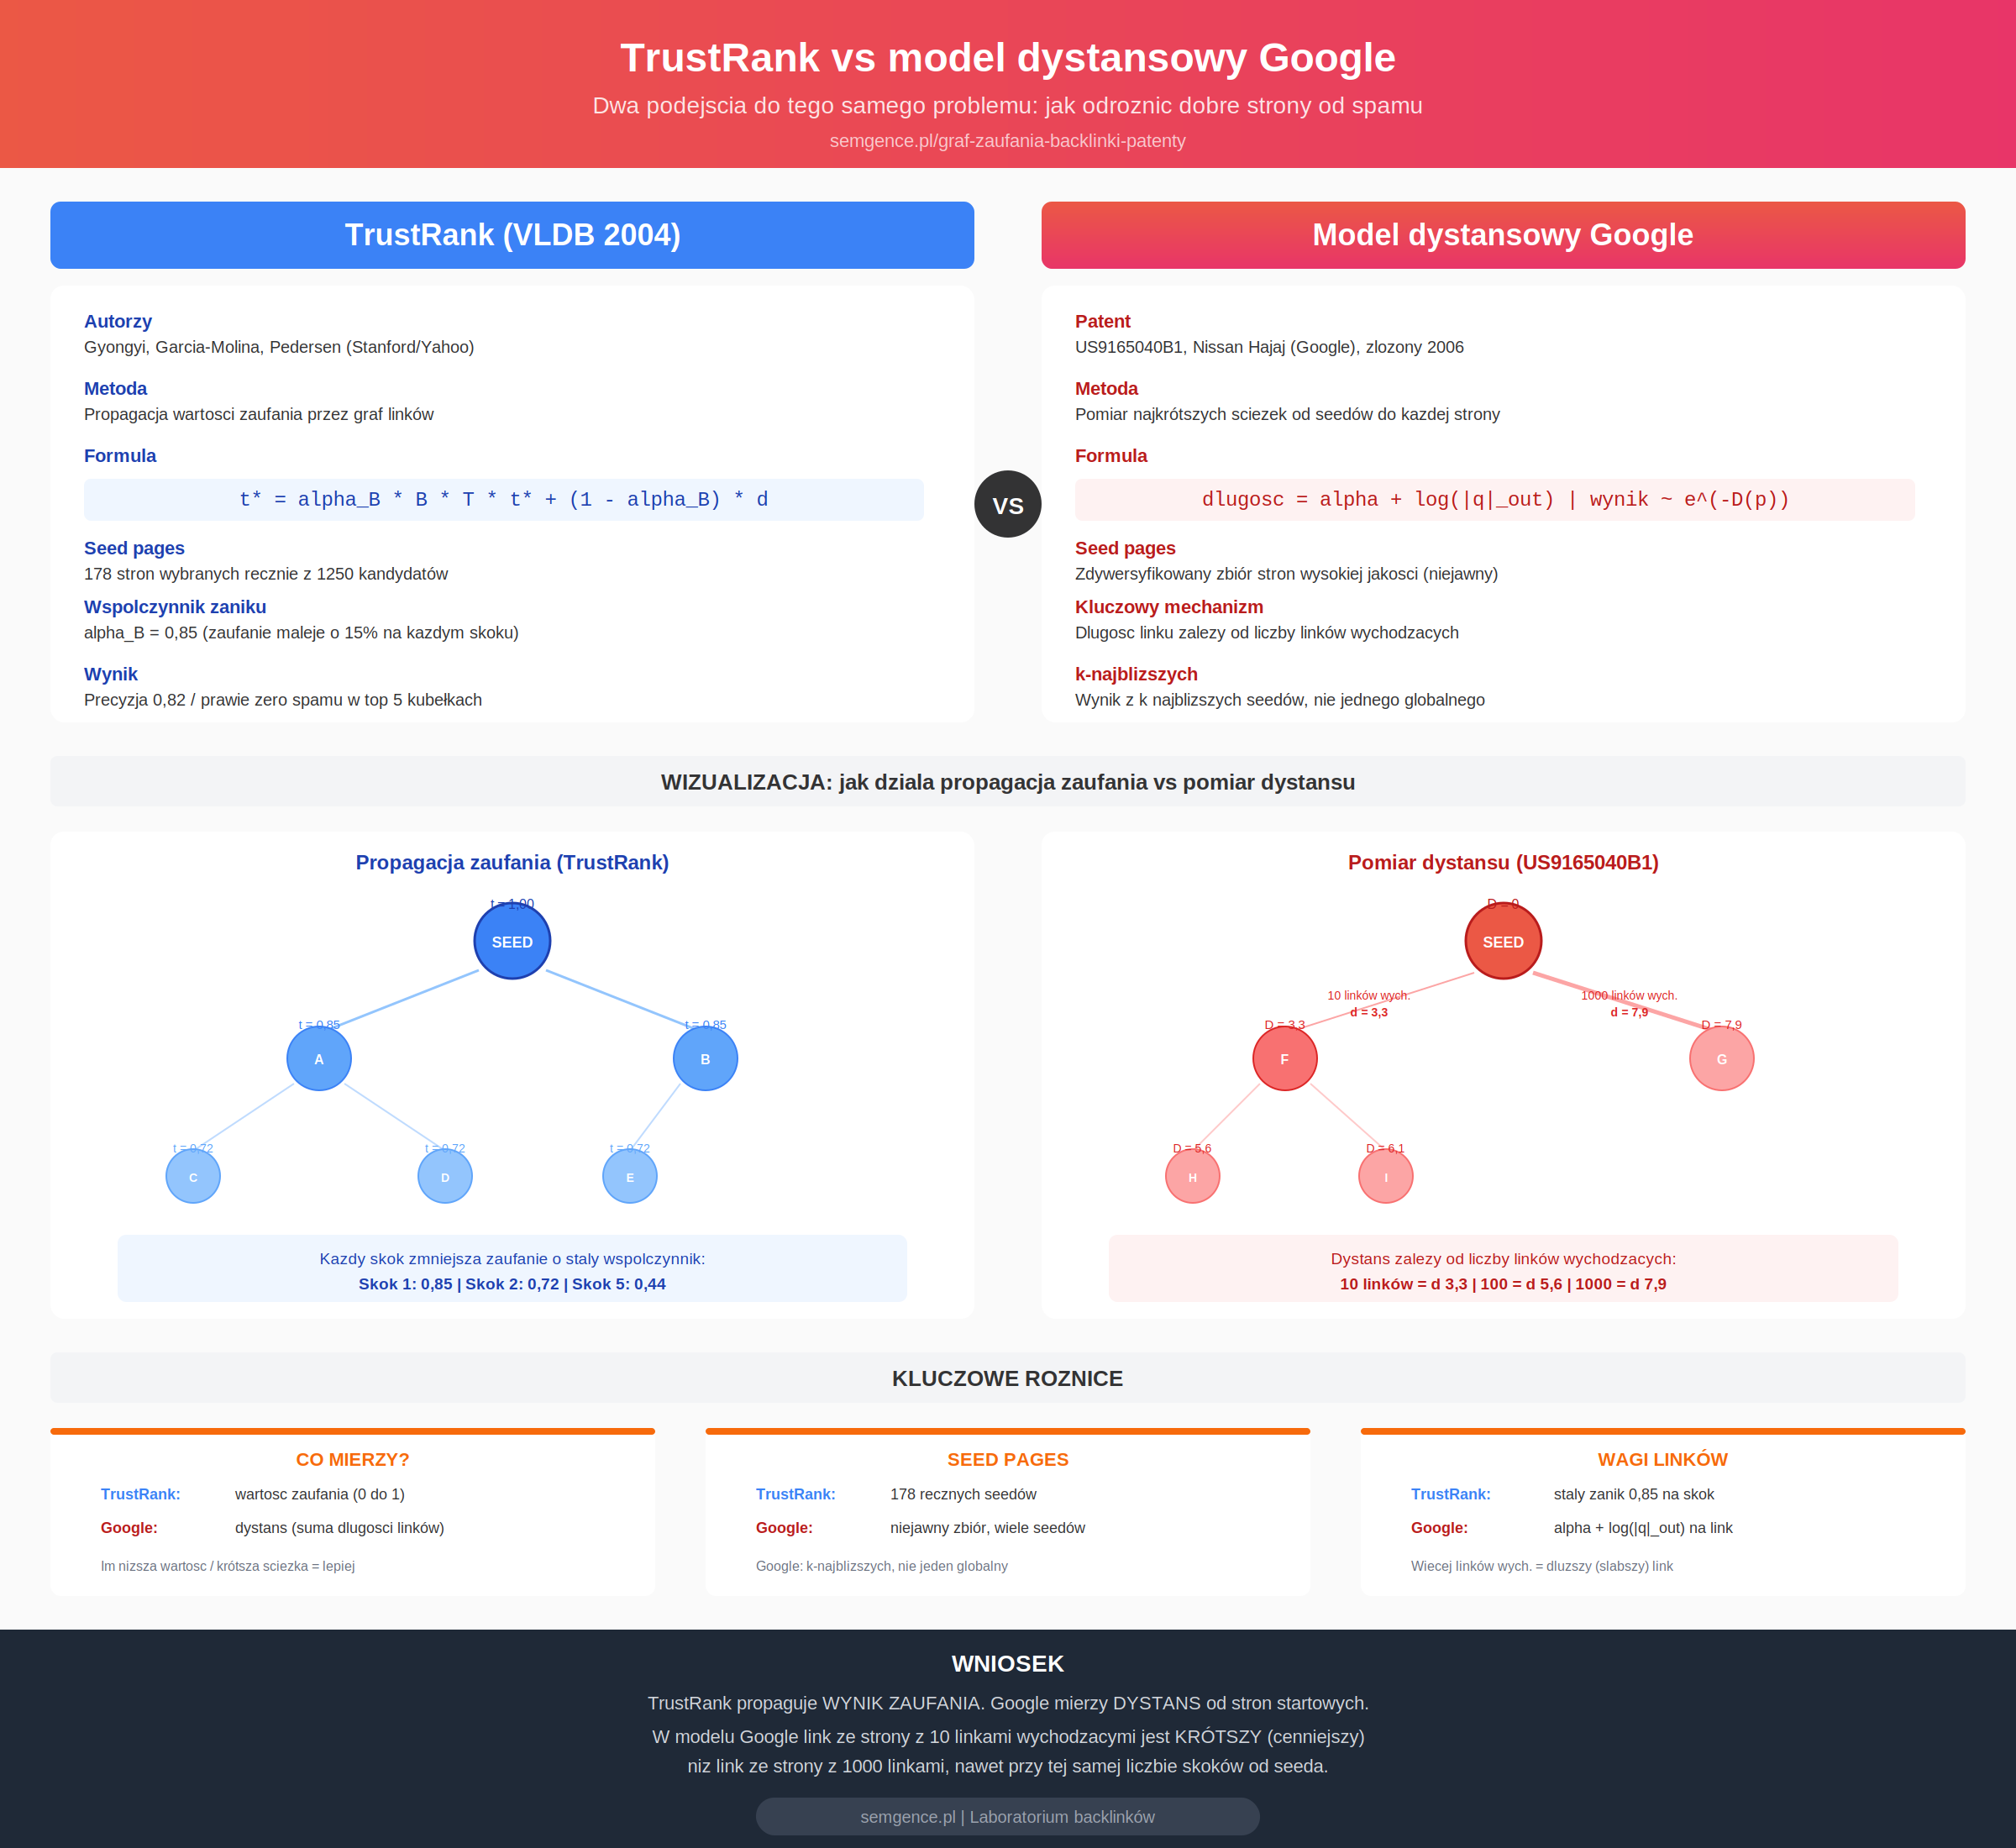
W 2004 roku trójka badaczy – Zoltán Gyöngyi i Hector Garcia-Molina ze Stanford University oraz Jan Pedersen z Yahoo – opublikowała na konferencji VLDB pracę Combating Web Spam with TrustRank. Ich podejście opierało się na jednym kluczowym założeniu: „dobre strony rzadko linkują do złych” (good pages seldom point to bad ones). Na tej podstawie stworzyli algorytm propagacji zaufania: spośród 1250 kandydatów wybrali ręcznie 178 stron startowych (seed pages), przypisali im pełne zaufanie, a następnie propagowali je przez graf linków ze współczynnikiem zaniku αB = 0,85. Formuła propagacji wyglądała następująco: t* = αB·B·T·t* + (1−αB)·d. Wynik: precyzja 0,82, praktycznie zerowy spam w pięciu najwyższych kubełkach rankingowych, podczas gdy porównywalny PageRank przepuszczał 20% spamu.
Dwa lata później, 12 października 2006 roku, inżynier Google Nissan Hajaj złożył patent, który w 2015 roku uzyskał numer US9165040B1 pod tytułem Producing a ranking for pages using distances in a web-link graph. Pomimo wspólnego punktu wyjścia – koncepcji seed pages – patent Google rozwiązuje problem w sposób fundamentalnie odmienny od TrustRank.
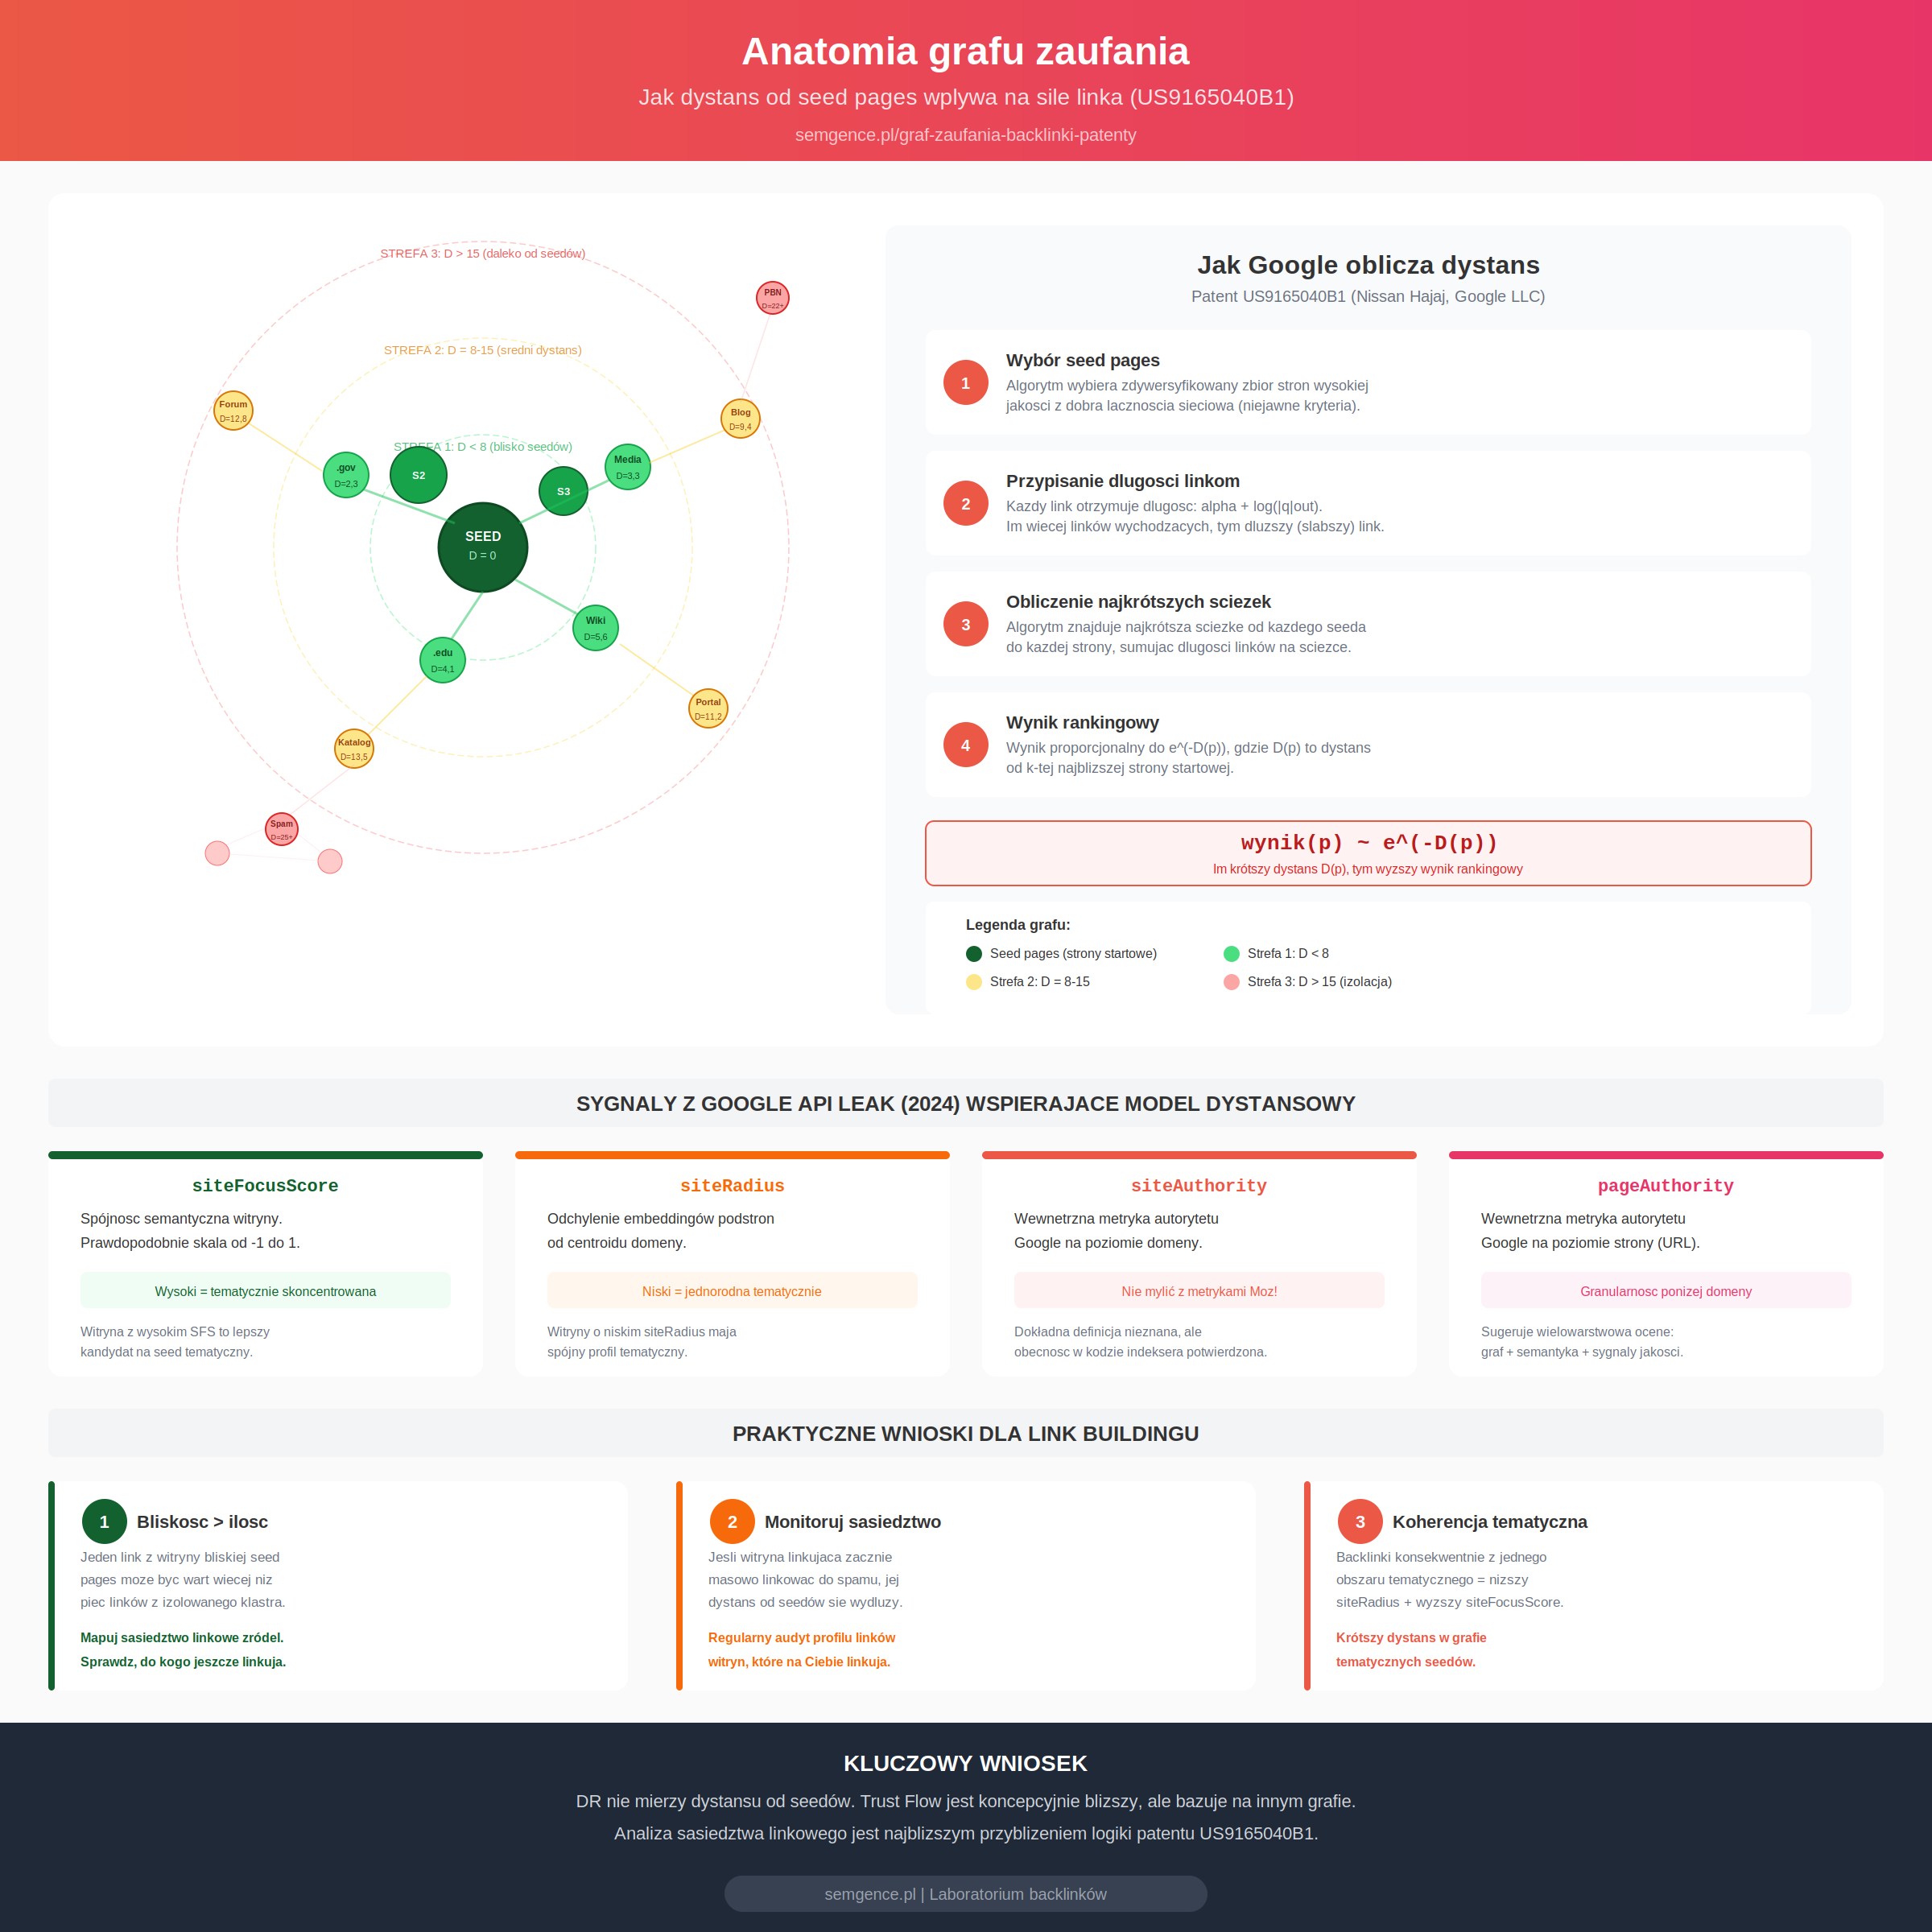
TrustRank propaguje wynik zaufania: każda strona otrzymuje konkretną wartość liczbową, która maleje z każdym kolejnym skokiem przez graf. Patent Google mierzy dystans: każdemu linkowi przypisuje długość obliczaną według wzoru α + log(|q|out), gdzie |q|out to liczba linków wychodzących ze strony źródłowej, a α jest stałą wynikającą z globalnego współczynnika tłumienia. Następnie algorytm oblicza najkrótsze ścieżki od zbioru stron startowych do każdej strony w grafie i przypisuje wynik rankingowy proporcjonalny do e−D(p), gdzie D(p) to dystans od k-tej najbliższej strony startowej.
Jak wyjaśniał Bill Slawski na SEO by the Sea w analizie tego patentu: Google wykorzystuje „zdywersyfikowany zbiór zaufanych stron jako strony startowe” do obliczania rankingów, a system przypisuje „długości linkom na podstawie właściwości linków i właściwości stron, do których te linki są dołączone”, po czym oblicza „najkrótsze dystanse od zbioru seed pages do każdej strony”. Slawski (zm. 2022) zauważył też, że choć Google i Yahoo/Stanford wychodzą od tej samej zasady – dobre strony rzadko linkują do złych – ich metody są wystarczająco odmienne, aby Google mógł obronić swój patent podczas procedury patentowej wobec patentu TrustRank (US7533092B2).
Różnica ma praktyczne znaczenie. W modelu TrustRank strona oddalona o pięć skoków od seeda otrzymuje zaufanie równe 0,855 ≈ 0,44 pierwotnej wartości. W modelu dystansowym Google ta sama strona otrzymuje wynik proporcjonalny do e−D, gdzie D zależy nie od liczby skoków, lecz od sumy długości linków na najkrótszej ścieżce. Link ze strony z tysiącem linków wychodzących jest „dłuższy” (mniej wartościowy) niż link ze strony z dziesięcioma linkami, nawet jeśli oba prowadzą tą samą liczbę skoków od seeda.
Roger Montti w analizie algorytmów dystansowych dla Search Engine Journal podkreślał, że Google organizuje zbiór seed pages według tematycznych kubełków (niche topic buckets), co czyni model odporniejszym na manipulację niż prosty TrustRank. W kontekście tego patentu słowo „trusted” opisuje właściwość stron startowych (są one godne zaufania, wolne od spamu), ale algorytm nie mierzy „zaufania” jako wartości numerycznej – mierzy odległość. Aby przeczytać ten patent we właściwym kontekście, warto zapoznać się z naszym przewodnikiem po czytaniu patentów Google o backlinkach.
Dlaczego nie znamy seedów używanych przez Google?
Google nigdy nie opublikował listy swoich stron startowych i nie ma powodu sądzić, że kiedykolwiek to zrobi. W oryginalnej pracy TrustRank z 2004 roku badacze wybrali 178 seedów ręcznie, przeglądając 1250 kandydatów. Ta metoda, choć skuteczna w badaniach akademickich na zbiorze 31 milionów stron, nie skaluje się do indeksu Google liczącego setki miliardów dokumentów.
Patent US9165040B1 wspomina o „specjalnie wybranych stronach wysokiej jakości, które zapewniają dobrą łączność sieciową z innymi stronami nie-startowymi”, ale celowo nie precyzuje kryteriów wyboru. Wiemy, że algorytm używa k najbliższych seedów do obliczenia dystansu, co sugeruje, że zbiór startowy jest duży i zdywersyfikowany, ale nie wiemy, czy liczy setki, tysiące, czy miliony pozycji.
Problem dużych witryn próbowała rozwiązać praca Topical TrustRank, opublikowana przez Baoning Wu, Vinaya Goela i Briana Davisona z Lehigh University na konferencji WWW w 2006 roku. Autorzy zauważyli, że klasyczny TrustRank faworyzuje duże, ogólnotematyczne witryny kosztem mniejszych, wyspecjalizowanych serwisów. Ich rozwiązanie polegało na podziale sieci na tematyczne fragmenty (topic shards), z których każdy otrzymywał odrębny zbiór seedów. Analogiczny pomysł – budowanie osobnych wektorów PageRank dla 16 kategorii tematycznych – zaproponował wcześniej Taher Haveliwala ze Stanford w pracy Topic-Sensitive PageRank z 2002 roku. Oba podejścia sugerują, że Google prawdopodobnie nie operuje jednym globalnym zbiorem seedów, lecz zestawami dostosowanymi do tematyki zapytania.
Niezależnie od modelu rankingowego, Google utrzymuje jasne zasady dotyczące spamu linkowego, kwalifikując kupowanie linków, schematyczne wymiany i automatyczne generowanie linków jako naruszenie wytycznych. W 2018 roku Google uruchomił SpamBrain, system oparty na uczeniu maszynowym, który do 2022 roku wykrywał 200 razy więcej stron spamowych niż w momencie wdrożenia. W grudniu 2022 roku SpamBrain wykrywał 50 razy więcej spamerskich stron wykorzystujących linki niż w lipcu 2021 i pięć razy więcej stron spamowych ogólnie. Google deklaruje, że 99% wyszukiwań jest wolnych od spamu, a system wykrywa spam już na etapie crawlowania. SpamBrain mógł częściowo zastąpić tradycyjny model seedów predykcją uczenia maszynowego, ale dystansowy sposób myślenia o grafie linków pozostaje aktualny, ponieważ kontynuacyjny patent US9953049B1 został złożony w 2015 roku, trzy lata przed debiutem SpamBrain.
Jak można zbudować ograniczony model badawczy?
Nie możemy odtworzyć grafu Google, ale możemy zbudować model obserwacyjny, który przybliża logikę dystansową. Kluczowe zastrzeżenie: strony, od których mierzymy dystans w takim modelu, to strony referencyjne wybrane przez analityka, nie seedów używanych przez Google. Nie mamy dostępu do algorytmu Google, więc nie możemy twierdzić, że nasze obserwacje odwzorowują jego wyniki. Możemy natomiast sprawdzić, czy strony bliższe uznanym źródłom w naszym modelu korelują z lepszymi pozycjami w wynikach wyszukiwania.
Metodologia, którą stosujemy w Semgence, opiera się na danych z Ahrefs i składa się z kilku kroków. Zaczynamy od eksportu pełnej listy domen linkujących do badanej witryny i do jej konkurentów. Następnie identyfikujemy domeny wspólne – te, które linkują zarówno do badanej witryny, jak i do stron referencyjnych (uznanych mediów, portali branżowych, instytucji naukowych). Im więcej domen wspólnych, tym krótszy dystans w grafie.
Kolejny krok to analiza sąsiedztwa tematycznego. Strona linkująca, która jednocześnie linkuje do autorytatywnych źródeł w tej samej tematyce, jest topologicznie bliżej stron referencyjnych niż strona linkująca wyłącznie do witryn o wątpliwej jakości. Sprawdzamy też wzorce reciprokalności – wzajemne linkowanie między dwoma stronami wydłuża efektywny dystans w modelu Google, ponieważ taki link wygląda na wymianę, nie na organiczną rekomendację.
Wreszcie identyfikujemy podejrzane klastry: grupy domen linkujących, które dzielą te same adresy IP, rejestratora, wzorce treści lub nawzajem na siebie linkują w zamkniętym obiegu, ale nie łączą się z szerszą siecią autorytatywnych źródeł. Takie klastry odpowiadają temu, co w patencie Google jest modelowane jako długie ścieżki od seedów – strony oddalone od wiarygodnych punktów startowych o wiele kosztownych kroków.
Model ten nie daje wyroku: nie mówimy, że dany link jest „zły”, bo jest daleko od naszych stron referencyjnych. Mówimy, że w logice dystansowej opisanej w patencie taki link prawdopodobnie wnosi mniejszą wartość niż link z witryny bliżej położonej w grafie. To narzędzie priorytetyzacji, nie kwalifikacji.
Co pokazuje graf klientów Semgence?
Stosując opisaną metodologię na portfelach klientów Semgence, obserwujemy kilka powtarzalnych wzorców, które są spójne z logiką patentu US9165040B1.
Po pierwsze, witryny z krótkim dystansem od stron referencyjnych wykazują większą stabilność rankingową podczas aktualizacji algorytmu. Gdy Google wdraża core update, strony z profilu linków złożonego głównie z izolowanych klastrów tracą pozycje szybciej i głębiej niż strony, których domeny linkujące mają szerokie powiązania z uznawanymi witrynami. Nie twierdzimy, że to jedyny czynnik – aktualizacje dotykają wielu sygnałów jednocześnie – ale korelacja między krótkim dystansem a stabilnością jest widoczna.
Po drugie, kontekst linkowy koreluje z dystansem. Linki osadzone w merytorycznej treści na stronach o bogatym sąsiedztwie linkowym (linkujących do wielu autorytatywnych źródeł) zazwyczaj pochodzą z witryn bliższych stronom referencyjnym. Linki z stopek i sidebarów na witrynach katalogowych lub zapleczowych – odwrotnie.
Po trzecie, wygasanie linków (link rot) może skracać lub wydłużać dystans w grafie. Gdy autorytatywna strona linkująca traci swoje linki przychodzące, jej pozycja w grafie się oddala od seedów, a wraz z nią oddala się każda strona, do której ta strona linkuje. Dlatego monitorowanie zdrowia profilu linków to nie tylko kwestia liczby aktywnych backlinków, ale też kondycji stron, które na nas linkują.
Dane z Google API Leak (ujawnionego w 2024 roku) wspierają ten obraz. Atrybuty takie jak siteFocusScore (mierzący spójność semantyczną witryny, prawdopodobnie w skali od -1 do 1) i siteRadius (określający, jak dalece embedddingi poszczególnych podstron odbiegają od centroidowego embeddingu domeny) sugerują, że Google analizuje nie tylko topologię grafu linków, ale też semantyczną koherencję witryn w nim uczestniczących. Witryna o wysokim siteFocusScore i niskim siteRadius to witryna tematycznie skoncentrowana – dokładnie taki profil, który Topical TrustRank z 2006 roku wyróżniałby jako lepszego kandydata na seed w danej kategorii tematycznej.
Dlaczego DR nie jest TrustRankiem?
Domain Rating (DR) Ahrefs to logarytmiczna skala od 0 do 100, która mierzy relatywną siłę profilu linków domeny. Jak wykazaliśmy w szczegółowej analizie tej metryki, DR bazuje na liczbie i jakości linków przychodzących mierzonych własnym algorytmem Ahrefs, który jest wariacją PageRank – nie ma nic wspólnego z modelem dystansowym ani z TrustRank.
DR nie uwzględnia kilku elementów kluczowych dla logiki patentu US9165040B1. Nie mierzy dystansu od żadnych stron startowych, ponieważ Ahrefs nie definiuje zbioru seedów. Nie rozróżnia linków z witryn bliskich autorytatywnym źródłom od linków z izolowanych klastrów – liczy się jedynie sumaryczna siła linków. Nie uwzględnia tematyczności sąsiedztwa, co oznacza, że domena z DR 60 zbudowanym na linkach z katalogów, forów i PBN-ów wygląda identycznie jak domena z DR 60 zbudowanym na linkach z uznanych mediów i portali branżowych.
Trust Flow (TF) Majestic jest koncepcyjnie bliższy TrustRank niż DR. Majestic deklaruje, że TF mierzy jakość linków na podstawie bliskości do „ręcznie sprawdzonego zbioru zaufanych witryn” – analogicznie do ręcznie wybranych 178 seedów w oryginalnej pracy Gyöngyiego. Jednak Trust Flow pozostaje uproszczoną metryką zewnętrzną, której zbiór seedów, formuła propagacji i aktualizacje nie są publiczne. Żadne narzędzie zewnętrzne nie może odtworzyć modelu Google, ponieważ żadne nie ma dostępu do pełnego grafu indeksowanego przez Google, do jego algorytmu wyboru seedów ani do sygnałów behawioralnych i semantycznych, które SpamBrain włącza do oceny.
Atrybuty z Google API Leak oferują ciekawszą perspektywę niż jakiekolwiek metryki zewnętrzne. siteAuthority i pageAuthority (nie mylić z metrykami Moz o tych samych nazwach) to wewnętrzne sygnały Google, których dokładna definicja nie jest znana, ale ich obecność w kodzie indeksera sugeruje, że Google oblicza pewien rodzaj autorytetu na poziomie domeny i strony. W połączeniu z siteFocusScore i siteRadius daje to obraz systemu, w którym dystans w grafie linków jest jednym z kilku wymiarów – obok semantycznej spójności witryny i jej tematycznego dopasowania do zapytania.
Praktyczna lekcja: oceniając prospekta linkowego, sprawdzanie samego DR to jak mierzenie odległości na mapie bez uwzględnienia terenu. Witryna z DR 30, której profil linków składa się z uznanych portali branżowych i mediów, może być topologicznie bliżej seedów Google niż witryna z DR 70 zbudowanym na szerokim, ale płytkim zapleczu.
Jak wykorzystać wiedzę o grafie w praktyce?
Wiedza o modelu dystansowym nie zmienia fundamentów link buildingu – nadal potrzebujemy linków z wartościowych stron w merytorycznym kontekście. Zmienia natomiast sposób priorytetyzacji i oceny jakości profilu linków.
Pierwsza zasada to priorytetyzacja bliskości nad ilością. Zamiast dążyć do maksymalizacji liczby domen linkujących, warto mapować sąsiedztwo linkowe potencjalnych źródeł. Strona, która linkuje do Wikipedii, portali rządowych, uznanych mediów branżowych i instytucji naukowych, prawdopodobnie znajduje się bliżej seedów Google niż strona, która linkuje wyłącznie do innych blogów o SEO. Jeden link z pierwszej jest prawdopodobnie wart więcej niż pięć linków z drugiej.
Druga zasada to monitorowanie jakości sąsiedztwa. W modelu dystansowym nie liczy się tylko strona, która na nas linkuje, ale też to, do czego ona linkuje i kto na nią linkuje. Jeśli witryna linkująca zacznie masowo linkować do serwisów spamowych, jej dystans od seedów się wydłuży, a wraz z nim wydłuży się dystans każdej strony, do której ta witryna prowadzi. Regularna analiza profilu linków witryn linkujących to element higieny, który większość specjalistów SEO pomija.
Trzecia zasada to tematyczna koherencja profilu. Topical TrustRank z 2006 roku i atrybuty siteFocusScore z API Leak wskazują, że tematyczność ma znaczenie nie tylko na poziomie pojedynczego linka (o czym pisaliśmy w analizie topical fit), ale na poziomie całego profilu linków. Witryna, której backlinki pochodzą konsekwentnie z jednego obszaru tematycznego, ma niższy siteRadius i wyższy siteFocusScore – a te sygnały korelują z krótszym dystansem w grafie tematycznych seedów.
W Semgence traktujemy analizę grafową jako narzędzie priorytetyzacji, nie wyrok. Nie mówimy klientom, że dany link jest „zły”, ponieważ nie znamy seedów Google i nie mamy dostępu do pełnego grafu. Mówimy natomiast, które elementy ich profilu linków wyglądają na topologicznie bliskie autorytatywnym źródłom, a które wydają się izolowane. To pozwala alokować budżet link buildingowy tam, gdzie potencjalna redukcja dystansu jest największa.
Czym różni się TrustRank od modelu dystansowego Google?
TrustRank (VLDB 2004) propaguje wynik zaufania przez graf linków ze współczynnikiem zaniku 0,85 na każdym skoku. Patent Google US9165040B1 mierzy najkrótszy dystans od stron startowych (seed pages), przypisując każdemu linkowi długość zależną od liczby linków wychodzących ze strony źródłowej. W TrustRank każda strona otrzymuje wartość zaufania; w modelu Google każda strona otrzymuje wynik odległości.
Co to są seed pages i jak wpływają na ranking?
Seed pages (strony startowe) to ręcznie lub algorytmicznie wybrane witryny wysokiej jakości, od których algorytm mierzy dystans do pozostałych stron w grafie. Im bliżej danej strony do seed pages (krótsza ścieżka w grafie linków), tym wyższy wynik rankingowy przypisuje jej algorytm. Google nie ujawnia swojego zbioru seedów.
Czy Domain Rating (DR) mierzy zaufanie?
Nie. DR Ahrefs to logarytmiczna skala mierząca relatywną siłę profilu linków domeny, bazująca na wariancie PageRank. Nie uwzględnia dystansu od stron startowych, tematyczności sąsiedztwa ani sygnałów antyspamowych. Witryna z wysokim DR może być topologicznie daleko od seedów Google, jeśli jej linki pochodzą z izolowanych klastrów.
Jak SpamBrain wykorzystuje analizę grafu linków?
SpamBrain, uruchomiony w 2018 roku, to system uczenia maszynowego, który do 2022 roku wykrywał 200 razy więcej stron spamowych niż w momencie wdrożenia. W grudniu 2022 wykrywał 50 razy więcej stron wykorzystujących spamerskie linki niż rok wcześniej. SpamBrain mógł częściowo zastąpić tradycyjny model seedów predykcją ML, ale logika dystansowa pozostaje aktualna – kontynuacyjny patent US9953049B1 został złożony w 2015 roku.
Czy można samodzielnie zbudować graf zaufania linków?
Można zbudować ograniczony model obserwacyjny, korzystając z danych Ahrefs: eksport domen linkujących, identyfikacja domen wspólnych z autorytatywnymi źródłami (stronami referencyjnymi), analiza reciprokalności, tematycznego sąsiedztwa i podejrzanych klastrów. Model taki nie odtwarza algorytmu Google, ale pozwala ocenić relatywną bliskość profilu linków do uznanych źródeł.
Co ujawnił Google API Leak o sygnałach zaufania?
API Leak z 2024 roku ujawnił atrybuty takie jak siteFocusScore (spójność semantyczna witryny), siteRadius (odchylenie embeddingów podstron od centroidu domeny), siteAuthority i pageAuthority. Razem sugerują, że Google analizuje nie tylko topologię grafu linków, ale też semantyczną koherencję witryn, co jest spójne z logiką Topical TrustRank.