Wyobraź sobie sytuację: publikujesz obszerny raport branżowy, ktoś udostępnia go na LinkedIn, artykuł łapie viralowy zasięg i w ciągu 48 godzin Twoja domena zyskuje 300 nowych backlinków. Zamiast świętować, zaczynasz się zastanawiać: czy Google potraktuje ten skok jako manipulację? Czy istnieje jakiś bezpieczny limit liczby linków, które można zdobyć w ciągu tygodnia? Branża SEO od lat operuje pojęciem „link velocity”, sugerując, że zbyt szybkie pozyskiwanie backlinków może uruchomić filtr lub karę algorytmiczną.
Problem w tym, że „link velocity” jako czynnik rankingowy to mit, który przetrwał ponad dekadę dzięki błędnej interpretacji jednego patentu Google. W tym artykule rozbieramy ten mit na czynniki pierwsze: analizujemy patent US 7,346,839, który zapoczątkował całą koncepcję, sprawdzamy co naprawdę mierzą systemy Google w kontekście tempa linkowania, co ujawnił wyciek dokumentacji API, jak Penguin i SpamBrain zmieniły podejście do nienaturalnych wzorców linkowych, i co na temat „link velocity” powiedzieli wprost Gary Illyes i John Mueller.
Czym jest link velocity i skąd wzięła się ta koncepcja?
Link velocity to termin opisujący tempo, w jakim domena pozyskuje (lub traci) backlinki w określonym przedziale czasowym. Narzędzia SEO takie jak Ahrefs, Majestic czy Semrush potrafią pokazać wykres nowych i utraconych domen linkujących dziennie, tygodniowo lub miesięcznie. Na podstawie tych danych branża SEO zbudowała całą teorię: naturalny profil linkowy powinien wykazywać stopniowy, równomierny wzrost, a nagłe skoki sygnalizują manipulację i mogą prowadzić do kary.
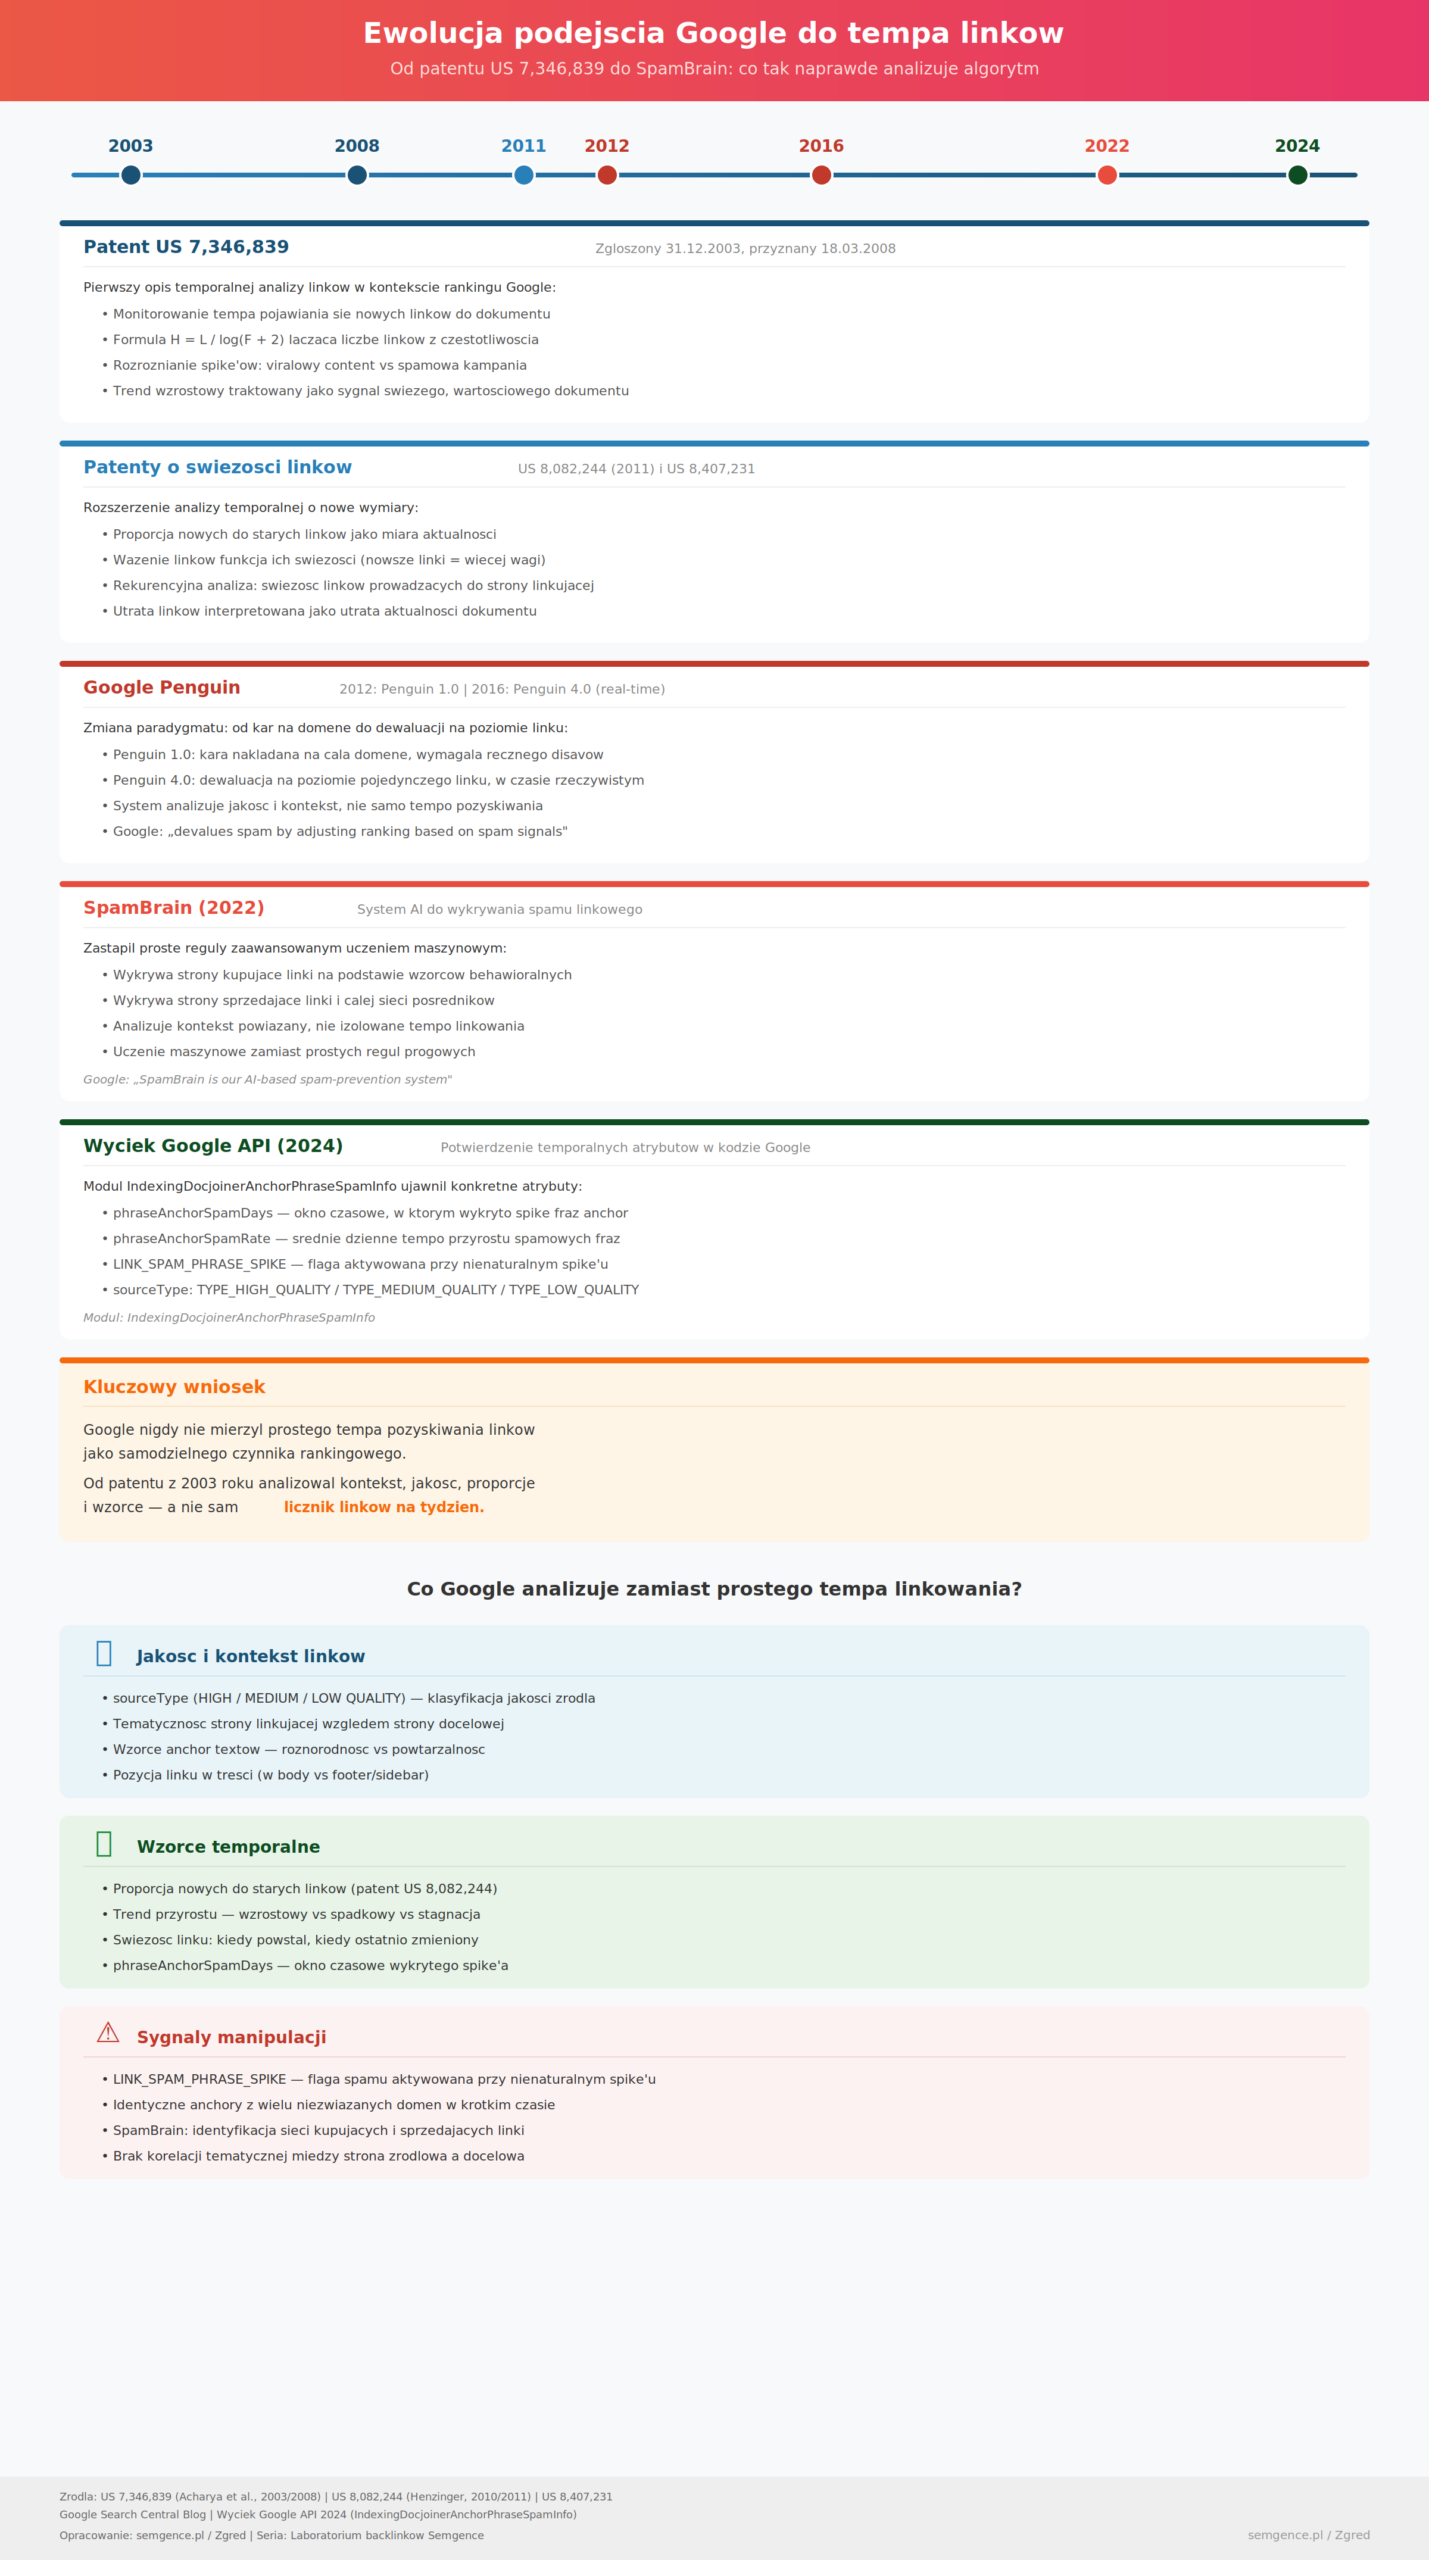
Źródłem tej teorii jest patent Google US 7,346,839 „Information retrieval based on historical data” (Anurag Acharya, Matt Cutts, Jeffrey Dean, Paul Haahr, Monika Henzinger, Urs Hoelzle et al.; zgłoszony 31 grudnia 2003, przyznany 18 marca 2008; Google Patents). To jeden z najczęściej cytowanych patentów w historii SEO, a zarazem jeden z najczęściej źle interpretowanych. Patent faktycznie opisuje analizę temporalną linków, ale wnioski, które wyciągnęła z niego branża, daleko wykraczają poza to, co tekst patentu rzeczywiście mówi. Zanim wyciągniesz z patentu praktyczne wnioski, warto przeczytać nasz poradnik o czytaniu patentów Google, który pokazuje typowe pułapki interpretacyjne.
Co mówi patent US 7,346,839 o tempie pozyskiwania linków?
Patent „Information retrieval based on historical data” to obszerny dokument obejmujący dziesiątki sygnałów temporalnych: od daty rejestracji domeny, przez częstotliwość zmian treści, po wzorce pozyskiwania linków. W kontekście link velocity kluczowe są trzy fragmenty.
Po pierwsze, patent opisuje monitorowanie tempa pojawiania się i znikania linków. Dokładny cytat brzmi: „search engine 125 may then monitor the time-varying behavior of links to the document, such as when links appear or disappear, the rate at which links appear or disappear over time”. System ma śledzić nie tylko liczbę linków, ale dynamikę ich zmian w czasie.
Po drugie, patent wprowadza formułę historycznego scoringu linków: H=L/log(F+2), gdzie H to wynik historyczny, L to liczba linków, a F to czas od daty powstania dokumentu. Ta formuła oznacza, że dokument, który zdobył 100 linków w miesiąc, dostaje wyższy score niż dokument z tą samą liczbą linków budowaną przez pięć lat. To nie jest kara za szybkie linkowanie, to nagroda za dynamiczny wzrost sugerujący aktualność i wartość treści.
Po trzecie, i tu zaczyna się źródło mitu, patent wspomina o skokach w liczbie linków: „A large spike in the quantity of back links may signal a topical phenomenon (…) or signal attempts to spam a search engine (…) by exchanging links, purchasing links”. Branża SEO wyciągnęła z tego zdania wniosek, że każdy gwałtowny przyrost linków grozi karą. Ale patent mówi o dwóch możliwych interpretacjach spike’a: albo to zjawisko tematyczne (viral, newsowa popularność), albo spam. System ma rozróżniać te przypadki, a nie karać za sam fakt szybkiego przyrostu.
Warto zwrócić uwagę na jeszcze jeden aspekt: patent opisuje także analizę trendów. Spadkowy trend w liczbie nowych linków („a downward trend in the number or rate of new links (…) over time could signal (…) that a document is stale”) może obniżać score dokumentu, a trend wzrostowy („an upward trend may signal a 'fresh’ document”) może go podnosić. To zupełnie odwrotna logika niż ta, którą promuje teoria link velocity: patent sugeruje, że rosnące tempo linkowania to sygnał pozytywny, a nie czerwona flaga.
Jak Google mierzy świeżość linku i dlaczego wiek backlinku ma znaczenie?
Temporalna analiza linków wykracza daleko poza sam patent US 7,346,839. Dwa kolejne patenty pokazują, że Google rozwinął sofistykowany system oceny linków w czasie.
Patent US 8,082,244 „Systems and methods for determining document freshness” (Monika Henzinger; zgłoszony 11 sierpnia 2010, przyznany 20 grudnia 2011; Google Patents) wprowadza koncepcję świeżości dokumentu opartą na linkach zwrotnych. System porównuje liczbę linków prowadzących do dokumentu teraz z liczbą linków sprzed określonego czasu. Jeśli obecna liczba jest mniejsza niż historyczna, dokument jest uznawany za „not fresh”. Jeśli większa, za „fresh”. Patent formalizuje to, co intuicyjnie brzmi logicznie: dokument, który traci linki, prawdopodobnie traci na aktualności, a dokument zyskujący nowe linki jest prawdopodobnie wartościowy i aktualny.
Co ciekawe, patent wprowadza także metrykę proporcji nowych do starych linków. Cytat: „If a ratio of a number of recent, or 'new,’ links to document p to a number of not recent, or 'old,’ links to document p is larger than a threshold value Th, then document p can be considered 'not fresh'”. Ta odwrócona logika sugeruje, że nadmiar nowych linków przy braku starych może wskazywać na wymianę treści (nowa strona pod starym URL), a nie na rosnącą popularność. System analizuje nie sam przyrost, ale proporcję nowych linków do całego profilu, co jest zupełnie innym podejściem niż proste liczenie „ile linków tygodniowo”.
Patent US 8,407,231 „Document scoring based on link-based criteria” (Google Patents) dodaje kolejny wymiar: ważenie linków funkcją malejącą z wiekiem. Cytat: „each link may be weighted by a function that increases with the freshness of the link”. Świeżość linku jest ustalana na podstawie daty pojawienia się linku, daty zmiany anchor textu oraz daty aktualizacji dokumentu zawierającego link. Patent opisuje także rekurencyjną analizę: dokument S może być uznany za „fresh”, jeśli określony procent linków do S jest świeży lub jeśli dokumenty linkujące do S same są uznawane za świeże.
Dla praktyki link buildingowej te patenty oznaczają coś istotnego: Google nie patrzy tylko na to, ile linków masz, ale na to, czy Twój profil linkowy żyje. Domena z 1000 backlinków, z których 90% powstało trzy lata temu i od tego czasu nie przybyło nic nowego, może być oceniana gorzej niż domena z 500 backlinków, które regularnie się odnawiają. To potwierdzają także analizy narzędzia Ahrefs, które pokazują zjawisko link rot: nawet najlepsze backlinki umierają z czasem, a brak nowych linków oznacza stopniową erozję profilu.
Czy nagły skok liczby linków naprawdę powoduje filtr lub karę?
To pytanie, które zadaje sobie każdy SEO-wiec po udanej kampanii PR-owej lub viralowej publikacji. Odpowiedź z patentów jest jednoznaczna: sam skok nie jest sygnałem negatywnym. Patent US 7,346,839 wyraźnie rozróżnia dwa scenariusze spike’a: zjawisko tematyczne (artykuł stał się popularny z uzasadnionego powodu) i manipulację (kupno linków, wymiana, PBN). System ma identyfikować przyczynę skoku, a nie karać za sam fakt jego wystąpienia.
W praktyce Google od 2016 roku (Penguin 4.0) nie stosuje kar za linki, lecz je dewaluuje. Penguin 4.0, wdrożony 23 września 2016 roku, zmienił podejście z karania na neutralizację. Zamiast obniżać pozycje całej domeny za nienaturalne linki, system zaczął po prostu ignorować linki uznane za manipulacyjne. Przejście z kary na dewaluację oznacza fundamentalną zmianę: nawet jeśli zbudujesz 1000 linków z PBN w jeden weekend, Google nie obniży Twoich pozycji, po prostu uzna te linki za bezwartościowe. Twoje pozycje nie wzrosną, ale też nie spadną z powodu samego tempa.
To nie oznacza, że szybkie budowanie linków jest bezpieczne. Problemem nie jest tempo, ale metoda. 300 linków z jednego viralowego artykułu na LinkedIn to coś zupełnie innego niż 300 linków z generowanych automatycznie profili na forach. Google nie mierzy prędkości, mierzy jakość, źródła i wzorce. Jak pokazuje analiza wykrywania PBN przez Google, algorytmy szukają footprintów wspólnej infrastruktury, powtarzalnych wzorców linkowania i nienaturalnej jednorodności, nie samego tempa przyrostu.
Co ujawnił wyciek dokumentacji Google API o temporalnej analizie linków?
W maju 2024 roku nastąpił bezprecedensowy wyciek wewnętrznej dokumentacji Google Content Warehouse API, ujawniający ponad 14 000 atrybutów używanych w systemach rankingowych (iPullRank, analiza Mika Kinga). Wśród nich znalazły się atrybuty bezpośrednio związane z temporalną analizą linków, które potwierdzają patentowe koncepcje w praktycznym kodzie.
Moduł IndexingDocjoinerAnchorPhraseSpamInfo zawiera dziewięć atrybutów dedykowanych wykrywaniu temporalnych anomalii w profilu anchor textów. Dwa z nich są szczególnie istotne w kontekście link velocity.
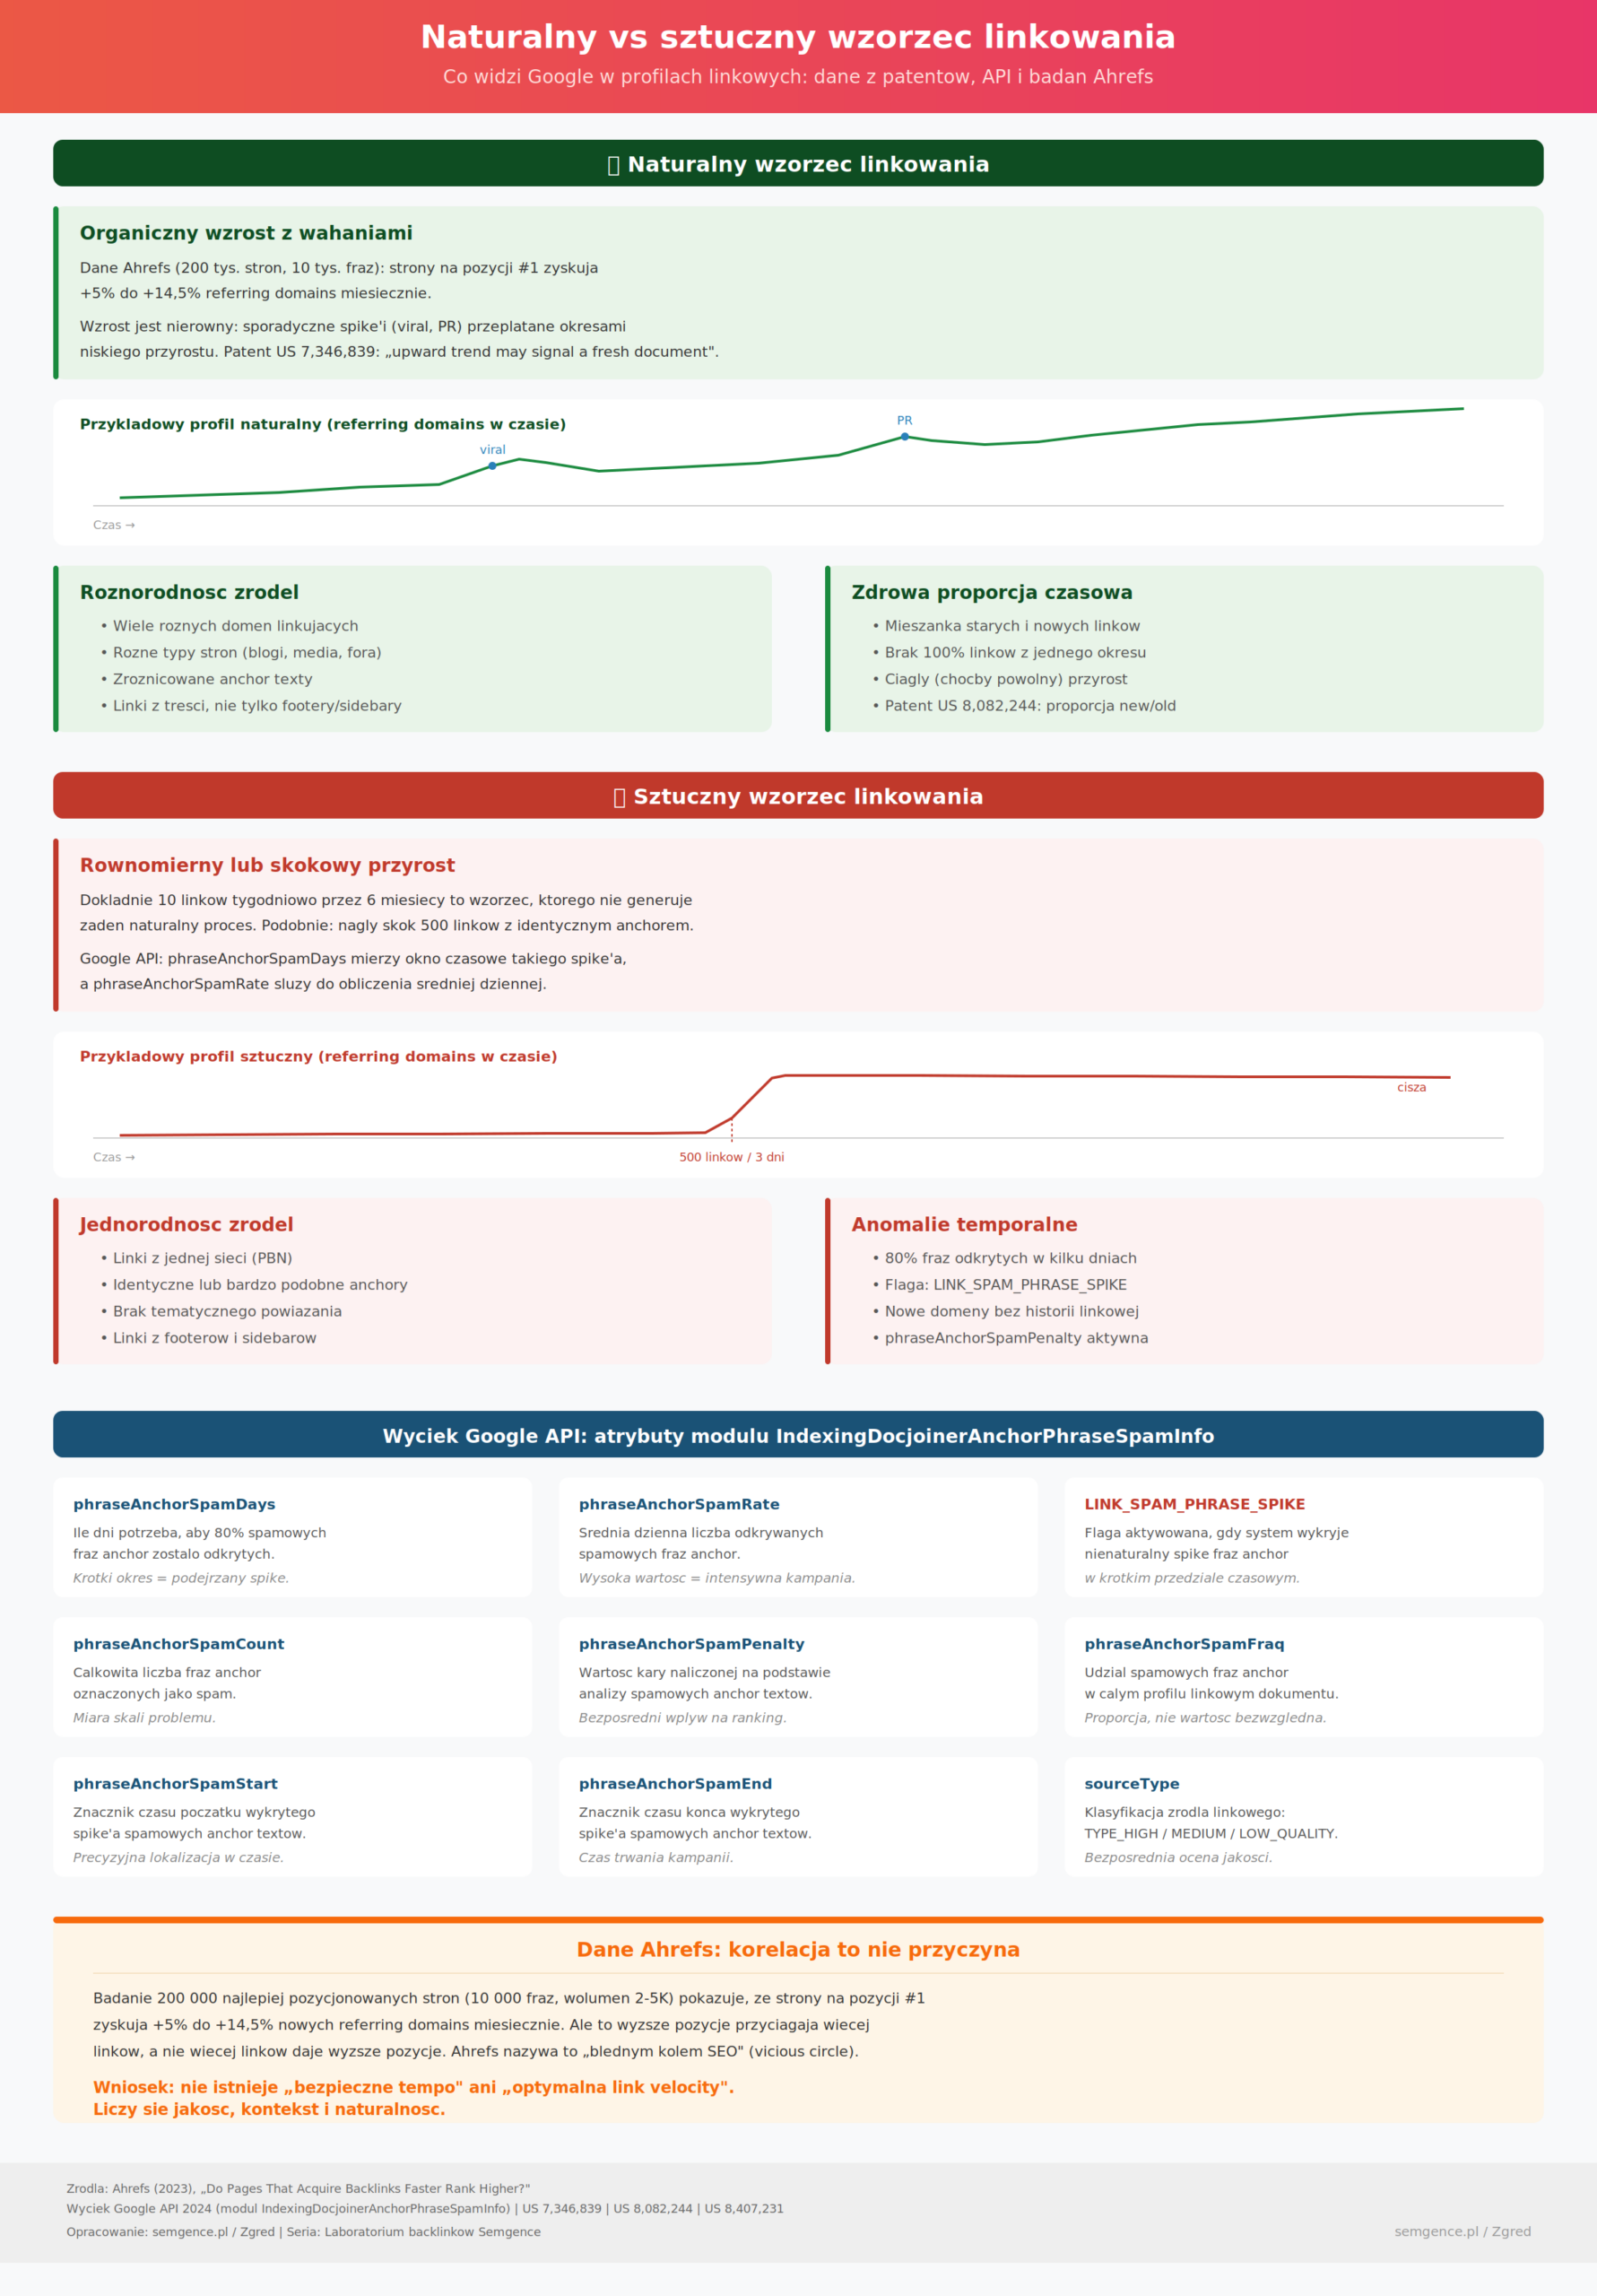
phraseAnchorSpamDays opisany jest jako „Over how many days 80% of these phrases were discovered”. To atrybut mierzący, w ilu dniach pojawiło się 80% spamowych fraz anchor text. Jeśli 80% identycznych anchor textów pojawia się w ciągu dwóch dni, to wyraźna anomalia sugerująca zautomatyzowaną kampanię. Naturalny profil linkowy buduje różnorodność anchor textów przez tygodnie i miesiące, nie godziny.
phraseAnchorSpamRate to „Average daily rate of spam anchor discovery”, czyli średnie dzienne tempo wykrywania spamowych anchorów. Atrybuty phraseAnchorSpamStart i phraseAnchorSpamEnd rejestrują dokładne timestamps początku i końca spike’a, oznaczonego wewnętrzną flagą LINK_SPAM_PHRASE_SPIKE.
To co wynika z tych atrybutów, jest kluczowe: Google nie mierzy ogólnego „link velocity” w sensie, w jakim rozumie to branża SEO. System mierzy temporalne anomalie w anchor textach. Nie interesuje go, ile linków zdobyłeś w ciągu tygodnia. Interesuje go, czy w krótkim czasie pojawiło się podejrzanie dużo linków z identycznymi lub podobnymi frazami kluczowymi w anchor text. To zasadnicza różnica: viralowy artykuł generujący 300 linków z różnorodnymi, naturalnymi anchorami (nazwa marki, tytuł artykułu, „kliknij tutaj”, URL) nie uruchomi tego systemu. Ale kampania link buildingowa, w której 200 linków ma anchor text „najlepszy prawnik Warszawa”, uruchomi go natychmiast.
Wyciek potwierdził także, że Google posiada wielopoziomowy system klasyfikacji źródeł linków. Atrybut sourceType w module IndexingDocjoinerAnchor kategoryzuje strony linkujące jako TYPE_HIGH_QUALITY, TYPE_MEDIUM_QUALITY i TYPE_LOW_QUALITY. Więcej o tym, jak Google klasyfikuje jakość linków, napisaliśmy w artykule o grafie zaufania.
Jak Penguin i SpamBrain zmieniły podejście do nienaturalnych wzorców linkowych?
Historia podejścia Google do nienaturalnych linków dzieli się na trzy wyraźne ery. Era manualna (2005-2012): zespół webspam Google pod kierownictwem Matta Cuttsa ręcznie nakładał kary na domeny z nienaturalnym profilem linkowym. Webmasterzy dostawali powiadomienia w Google Search Console o „unnatural links pointing to your site” i musieli składać wnioski o ponowne rozpatrzenie (reconsideration requests) po oczyszczeniu profilu.
Era Penguin (2012-2022): algorytm Penguin, uruchomiony 24 kwietnia 2012 roku, zautomatyzował wykrywanie nienaturalnych wzorców linkowych. Pierwsza wersja działała na zasadzie filtra nakładanego podczas aktualizacji indeksu, co oznaczało, że strony ukarane przez Penguin musiały czekać na kolejną aktualizację (czasem miesiącami), żeby zobaczyć efekty działań naprawczych. Penguin 4.0, wdrożony 23 września 2016 roku, zmienił trzy kluczowe elementy: stał się częścią algorytmu core (działał w czasie rzeczywistym), zaczął działać na poziomie strony zamiast domeny, i przeszedł z karania na dewaluację linków. Google oficjalnie potwierdził tę zmianę, informując że Penguin od tej pory „devalues spam by adjusting ranking based on spam signals” zamiast nakładania kary na całą domenę (Google Search Central Blog, 23 września 2016).
Era SpamBrain (2022-obecnie): w grudniu 2022 roku Google wdrożył link spam update oparty na SpamBrain, swoim systemie AI do wykrywania spamu. Oficjalny komunikat brzmiał: „SpamBrain is our AI-based spam-prevention system. Besides using it to detect spam directly, it can now detect both sites buying links, and sites used for the purpose of passing outgoing links” (Search Engine Roundtable). SpamBrain nie tylko identyfikuje podejrzane linki, ale wykrywa całe sieci: strony kupujące linki i strony, które istnieją głównie po to, żeby je sprzedawać. John Mueller potwierdził, że to nie jest ręczna akcja: „No, it’s not a manual action”, co oznacza, że system działa w pełni automatycznie.
Dla koncepcji link velocity te trzy ery mają jasną implikację.
- Era manualna (2005-2012): tempo linkowania mogło być jednym z sygnałów, które analityk Google brał pod uwagę przy ocenie profilu.
- Era Penguin (2012-2022): algorytm szukał wzorców (np. nadmiar exact match anchor text, linki z niskiej jakości katalogów), ale nie samego tempa.
- Era SpamBrain (2022-obecnie): system patrzy na relacje między stronami (kto kupuje, kto sprzedaje), kontekst linków i tematyczne dopasowanie, nie na prędkość pozyskiwania.
Czy Google Sandbox to rzeczywisty mechanizm powiązany z tempem pozyskiwania linków?
Google Sandbox to teoria, która pojawiła się około 2004 roku i sugeruje, że nowe domeny są celowo „wstrzymywane” w wynikach wyszukiwania przez określony czas (zwykle 3-6 miesięcy), niezależnie od jakości treści i linków. Teoria ta jest ściśle powiązana z koncepcją link velocity: jeśli nowa domena zbyt szybko zdobywa linki, powinna być „piaskowana”, czyli poddana obserwacji.
Patent US 7,346,839 faktycznie zawiera fragmenty, które mogłyby wspierać istnienie Sandbox. System może wykorzystywać datę rejestracji domeny do obliczania tempa pozyskiwania linków: „search engine 125 may use the inception date of a document to determine a rate at which links to the document are created (e.g., as an average per unit time based on the number of links created since the inception date)”. Formuła H=L/log(F+2) automatycznie penalizuje domeny, które zdobyły dużo linków w krótkim czasie od powstania, ponieważ mały F (krótki czas od rejestracji) obniża dzielnik logarytmu.
Ale Google nigdy oficjalnie nie potwierdził istnienia Sandbox. John Mueller, zapytany o ten mechanizm, stwierdził: „It can take a bit of time for search engines to catch up with your content, and to learn to treat it appropriately”. To sugeruje, że opóźnienie w rankingu nowych stron wynika z naturalnego procesu indeksowania i budowania sygnałów, a nie z celowego filtra. Matt Cutts w 2005 roku przyznał, że efekty przypominające sandbox „may be perceived as a sandbox that does not apply to all industries”, ale nie potwierdził istnienia dedykowanego mechanizmu.
Z perspektywy danych patentowych najbardziej prawdopodobne wyjaśnienie „efektu sandbox” to po prostu brak wystarczających sygnałów. Nowa domena nie ma:
- historii linków,
- historii kliknięć (NavBoost potrzebuje danych o interakcjach użytkowników),
- historii zmian treści,
- grafu zaufania.
System nie tyle „karze” nową domenę, co po prostu nie ma dość danych, żeby jej zaufać. To zupełnie inna perspektywa niż „Google karze Cię za zbyt szybkie budowanie linków”.
Co mówią dane Ahrefs o tempie przyrostu backlinków najlepiej pozycjonowanych stron?
Badanie Ahrefs przeprowadzone na próbie 200 000 stron rankujących w top 10 dla 10 000 fraz kluczowych (wolumen 2-5 tys. wyszukiwań miesięcznie) dostarcza twardych danych o tym, jak wygląda naturalne tempo pozyskiwania linków wśród najlepiej pozycjonowanych stron (Ahrefs Blog).
Kluczowe ustalenie: strony na pozycji #1 pozyskują nowe domeny linkujące w tempie +5% do +14,5% miesięcznie. To oznacza, że strona z 55 domenami linkującymi mogła w ciągu trzech miesięcy zyskać od 64 do 83 nowych domen. Badanie wykazało wyraźną korelację: im wyższa pozycja w SERP, tym szybsze tempo przyrostu backlinków.
Ale jest istotny niuans: badacze nie znaleźli związku przyczynowego między samym tempem pozyskiwania linków a zmianami pozycji. Strony na pozycji #1 nie rankują wyżej dlatego, że szybciej zdobywają linki. Rankują wyżej z wielu powodów (jakość treści, autorytet domeny, sygnały użytkowników), a wysoka pozycja generuje większą widoczność, która z kolei przyciąga więcej linków. Ahrefs opisuje to jako „błędne koło SEO” (the vicious circle of SEO): lepsze pozycje generują więcej ruchu, więcej ruchu generuje więcej linków, więcej linków wspiera lepsze pozycje.
Te dane są ważne z dwóch powodów. Po pierwsze, naturalne tempo pozyskiwania linków jest bardzo zróżnicowane i zależy od branży, wielkości domeny i widoczności w SERP. Nie istnieje żaden „bezpieczny limit” typu „5 linków tygodniowo”. Strona na pozycji #1 dla konkurencyjnej frazy może naturalnie zdobywać dziesiątki nowych domen linkujących miesięcznie, podczas gdy niszowa strona e-commerce może zdobywać jeden link na kwartał. Po drugie, metryki narzędziowe takie jak Domain Rating nie mierzą link velocity w sposób, który odpowiadałby algorytmom Google. DR reaguje na liczbę domen linkujących, nie na tempo ich przyrostu.
Jak Gary Illyes i John Mueller komentują „link velocity”?
Stanowisko Google w kwestii link velocity jest jednoznaczne, wyrażone przez dwóch najważniejszych publicznych przedstawicieli firmy.
Gary Illyes, Senior Search Analyst w Google, podczas sesji AMA (Ask Me Anything) na Reddicie, zapytany o negatywną link velocity, odpowiedział wprost: „I would love if you didn’t focus that much on links and made up terms like link velocity” (Bill Hartzer, 56 Takeaways from Gary Illyes’ AMA). To nie jest dyplomatyczne uchylenie się od odpowiedzi. Illyes wprost nazywa link velocity „wymyślonym terminem” (made up term), co jest jednym z najostrzejszych zdementowań koncepcji SEO, jakie kiedykolwiek padło z ust pracownika Google. W tej samej sesji Illyes dodał: „I really wish SEOs went back to the basics (i.e. MAKE THAT DAMN SITE CRAWLABLE) instead of focusing on silly updates and made up terms by the rank trackers”.
John Mueller, Search Advocate w Google, odniósł się do konkretnego scenariusza: kogoś, kto planował zdobyć 200 backlinków w dwa dni. Mueller odpowiedział: „It’s not so much a matter of how many links you get in which time period. It’s really just… if these are links that are unnatural or from our point of view problematic then they would be problematic. It’s like it doesn’t really matter how many or in which time” (Search Engine Journal). Mueller jednoznacznie wskazuje, że kluczowa jest jakość i naturalność linków, nie ich ilość czy tempo pozyskania. Dodał: „From my point of view if you’re jumping in with a question like this and you’re saying I’m going to get 200 backlinks in two days… then that sounds a lot like you’re not getting natural backlinks”. Problem nie leży w tempie, lecz w intencji: kto planuje zdobyć 200 linków w weekend, najprawdopodobniej ich nie zdobywa organicznie.
Te wypowiedzi powinny definitywnie zamknąć debatę: Google nie mierzy „link velocity” jako czynnika rankingowego. System mierzy jakość, źródła i naturalność linków. Tempo jest co najwyżej jednym z wielu elementów kontekstowych, który może sugerować manipulację, ale sam w sobie nie jest sygnałem.
Dlaczego mimo wszystko tempo linkowania jest wskaźnikiem, na który warto patrzeć?
Skoro Google nie mierzy link velocity jako czynnika rankingowego, to po co w ogóle na nie patrzeć? Odpowiedź leży w różnicy między czynnikiem rankingowym a wskaźnikiem diagnostycznym.
Tempo pozyskiwania linków to doskonałe narzędzie diagnostyczne profilu linkowego.
- Nagły spadek nowych linków może sygnalizować, że treść traci na aktualności, że konkurencja przejęła inicjatywę, lub że domena doświadcza link rot.
- Gwałtowny wzrost może oznaczać sukces kampanii PR-owej, viralową treść, lub że ktoś przeprowadza negatywne SEO (co w erze dewaluacji jest mniej groźne, ale warto o tym wiedzieć).
- Benchmarking konkurencji: jeśli główni konkurenci regularnie zdobywają 20-30 nowych domen linkujących miesięcznie, a Twoja domena stoi w miejscu, to nie kwestia algorytmu, to kwestia strategii.
Patent US 8,082,244 potwierdza tę perspektywę. System Google mierzy, czy profil linkowy „żyje”, czy „umiera”. Domena, która przestała zdobywać nowe linki, traci sygnał świeżości. Ale to nie jest „kara za niską link velocity”, to po prostu brak pozytywnego sygnału, który mogłyby dostarczyć nowe, świeże backlinki.
Jak wygląda naturalny wzorzec linkowania i czym się różni od sztucznego?
Zamiast mierzyć „link velocity”, warto zrozumieć, czym różni się naturalny profil linkowy od sztucznego w wymiarze temporalnym. Atrybuty z wycieku Google API dają tu jasne wskazówki.
Naturalny profil linkowy charakteryzuje się kilkoma cechami temporalnymi.
- Diversyfikacja anchor textów w czasie: linki pojawiające się przez tygodnie i miesiące naturalnie mają zróżnicowane anchory (nazwa marki, tytuł strony, „kliknij tutaj”, fragmenty zdań, nagie URL-e). Atrybut
phraseAnchorSpamDaysmierzy dokładnie to: ile dni zajęło pojawienie się 80% anchorów z daną frazą. Naturalny profil rozciąga to na setki dni. - Zróżnicowanie źródeł: linki przychodzą z różnych typów stron (blogi, portale branżowe, fora, social media) i mają różną klasę jakości (
sourceType: HIGH, MEDIUM, LOW). - Stopniowy, ale nierówny wzrost: naturalne linkowanie nie jest płaską linią. Są tygodnie z zerowymi nowymi linkami i tygodnie z pięcioma, czasem z kilkudziesięcioma po udanej publikacji. To właśnie „spiky rate” opisana w patencie jako potencjalny sygnał topicalnego zjawiska.
Sztuczny profil linkowy wykazuje inne wzorce temporalne.
- Koncentracja anchor textów w krótkim oknie:
phraseAnchorSpamDaysbliskie zeru, bo 80% spamowych fraz pojawia się w ciągu dni, nie miesięcy. - Wysoka wartość
phraseAnchorSpamRate: dziesiątki lub setki spamowych anchorów dziennie. - Jednorodność źródeł: linki z jednego typu stron (np. wyłącznie z katalogów lub z PBN), wszystkie sklasyfikowane jako
TYPE_LOW_QUALITY. - Wyraźny spike z ostrymi granicami:
phraseAnchorSpamStartiphraseAnchorSpamEndrejestrują dokładny moment kampanii.
To kluczowe rozróżnienie prowadzi do praktycznego wniosku: Google nie karze za szybkie linkowanie, karze (a właściwie neutralizuje) za nienaturalne wzorce. Różnica między szybkim a nienaturalnym leży w dywersyfikacji anchor textów, jakości źródeł i kontekście anchor context, nie w samym tempie.
Jak planować tempo pozyskiwania backlinków w praktyce?
Skoro link velocity nie jest czynnikiem rankingowym, a Google patrzy na jakość, źródła i wzorce, to jak planować strategię link buildingową w wymiarze temporalnym?
Zamiast ustalać „bezpieczne” limity linków tygodniowo (5, 10, 20, nie ma to znaczenia), skup się na tym, co naprawdę mierzy Google. Dywersyfikuj anchor texty: naturalna kampania generuje linki z różnymi typami anchorów.
- Brandowe anchory (nazwa firmy, domena).
- Anchory tematyczne (fragment tytułu, opis tematu).
- Generyczne anchory („kliknij tutaj”, „czytaj więcej”).
- Nagie URL-e.
Patent US 7,346,839 mówi wprost o zmianach anchor textów w czasie jako sygnale: „changes over time in anchor text associated with links to a document may be used as an indication that there has been an update or even a change of focus”. Monotonny anchor text to czerwona flaga, niezależnie od tempa.
Zróżnicuj źródła i cel linków. Nie buduj wszystkich linków do strony głównej ani do jednego URL-a. Naturalne linkowanie rozprasza się na wiele stron, w zależności od tego, która treść jest wartościowa. Jak pokazuje analiza targetowania URL-i, różne typy stron (produkt, kategoria, poradnik) generują różne typy linków.
Buduj profil, który żyje. Patent US 8,082,244 mierzy proporcję nowych do starych linków. Domena, która zdobywa linki wyłącznie w jednym miesiącu, a potem milknie na pół roku, wysyła inny sygnał niż domena ze stałym, nawet niewielkim, strumieniem nowych backlinków. Regularna publikacja wartościowej treści, outreach do mediów branżowych, guest posting na tematycznie dopasowanych stronach, to strategie, które generują naturalnie rozłożony w czasie profil linkowy.
Monitoruj anomalie, ale nie tempo. Zamiast śledzić „link velocity” jako wskaźnik zdrowia, śledź konkretne anomalie.
- Nagłe pojawienie się dużej liczby linków z anchor textem, którego nie planowałeś (potencjalne negative SEO).
- Masowy spadek domen linkujących (link rot lub usunięcie treści linkującej).
- Pojawienie się linków z domen o bardzo niskim Domain Rating (potencjalne spamowe farmy linków).
To są sygnały wymagające reakcji, nie sam fakt, że „zdobywamy za dużo/za mało linków tygodniowo”.
Co to wszystko oznacza dla strategii link buildingowej?
Analiza patentów, wycieku API i oficjalnych wypowiedzi Google prowadzi do jasnych wniosków dla praktyki SEO.
Link velocity jako izolowany czynnik rankingowy nie istnieje. Google nie mierzy, ile linków zdobywasz tygodniowo, i nie karze za szybkie tempo. Gary Illyes nazwał to „wymyślonym terminem”, John Mueller potwierdził, że liczy się naturalność, nie tempo. Patent US 7,346,839 opisuje spike’i jako potencjalny sygnał, ale system ma rozróżniać viralową popularność od manipulacji, a nie karać za sam fakt gwałtownego przyrostu.
To, co Google naprawdę mierzy, to cztery kluczowe wymiary.
- Temporalne wzorce anchor textów: jak szybko pojawiają się identyczne anchory.
- Jakość i klasyfikacja źródeł linków (
sourceType): HIGH, MEDIUM, LOW. - Proporcja świeżych do starych linków (freshness ratio).
- Kontekst linku: skąd przychodzą linki, jaka jest ich pozycja na stronie, czy generują kliknięcia.
Efekt sandbox nowych domen to prawdopodobnie nie celowy filtr, ale wynik braku wystarczających sygnałów historycznych. Patent US 7,346,839 formalizuje tę logikę w formule H=L/log(F+2), ale to nie kara, to konsekwencja tego, że system potrzebuje czasu na zebranie danych.
Najważniejsza zmiana ostatnich lat to przejście z karania na neutralizację (Penguin 4.0, 2016) i wdrożenie AI-based detection (SpamBrain, 2022). W praktyce oznacza to, że „zbyt szybkie” budowanie linków niskiej jakości nie obniży Twoich pozycji, po prostu nie przyniesie żadnego efektu, bo linki zostaną zneutralizowane. Twój budżet i czas zostaną zmarnowane, ale pozycje nie spadną.
Dlatego jedyną sensowną strategią link buildingową jest budowanie linków, które byłyby wartościowe nawet gdyby Google w ogóle nie istniał: linków, które przynoszą ruch referralowy, budują świadomość marki i pozycjonują Cię jako autorytet w branży. Tempo takiego linkowania reguluje się samo. Artykuł, który napiszesz na konferencji branżowej, wygeneruje inny profil linkowy niż raport roczny, a oba będą naturalnie różne od strategii contentowej opartej na evergreen poradnikach. I to jest dokładnie to, czego szukają systemy Google.
Najczęściej zadawane pytania
Czy Google karze za zbyt szybkie pozyskiwanie backlinków?
Nie. Google nie mierzy link velocity jako izolowanego czynnika rankingowego. Gary Illyes z Google wprost nazwał link velocity „wymyślonym terminem” (made up term). John Mueller potwierdził, że liczy się jakość i naturalność linków, nie ich ilość czy tempo pozyskania. Od Penguin 4.0 (2016) Google nie nakłada kar za linki, lecz je neutralizuje (dewaluuje).
Ile backlinków mogę bezpiecznie zdobyć w ciągu miesiąca?
Nie istnieje żaden uniwersalny „bezpieczny limit”. Badanie Ahrefs na próbie 200 000 stron pokazało, że strony na pozycji #1 pozyskują nowe domeny linkujące w tempie +5% do +14,5% miesięcznie. Naturalny przyrost zależy od branży, wielkości domeny i widoczności w wynikach wyszukiwania. Zamiast pilnować liczby, skup się na jakości źródeł, dywersyfikacji anchor textów i tematycznym dopasowaniu linków.
Czy nagły wzrost liczby linków po viralowej treści może zaszkodzić?
Nie, o ile linki są naturalne. Patent US 7,346,839 wyraźnie rozróżnia dwa scenariusze spike’a: zjawisko tematyczne (viralowa popularność) i manipulację (kupowanie linków, PBN). Google ma mechanizmy rozróżniania tych przypadków. Viralowy artykuł generujący setki linków z różnorodnymi anchor textami i z różnych źródeł nie uruchomi systemu detekcji spamu.
Co to jest Google Sandbox i czy dotyczy nowych domen?
Google Sandbox to niepotwierdzona teoria sugerująca, że nowe domeny są celowo wstrzymywane w wynikach wyszukiwania. Google nigdy oficjalnie nie potwierdził istnienia tego mechanizmu. John Mueller przyznał, że wyszukiwarki potrzebują czasu na odpowiednie przetworzenie nowej treści. Opóźnienie w rankingu nowych stron wynika prawdopodobnie z braku wystarczających sygnałów historycznych, a nie z celowego filtra.
Czym różni się naturalne tempo linkowania od sztucznego?
Kluczowa różnica leży nie w samym tempie, ale we wzorcach. Naturalne linkowanie charakteryzuje się: zróżnicowanymi anchor textami rozłożonymi w czasie, linkami z różnych typów i jakości stron, nierównym ale ciągłym przyrostem. Sztuczne linkowanie wykazuje: koncentrację identycznych anchor textów w krótkim oknie czasowym, jednorodność źródeł i wyraźne spike’i z ostrymi granicami czasowymi.
Jak SpamBrain wpływa na wykrywanie nienaturalnych wzorców linkowych?
SpamBrain, wdrożony w grudniu 2022 roku, to system oparty na sztucznej inteligencji, który wykrywa zarówno strony kupujące linki, jak i strony sprzedające linki. W odróżnieniu od Penguin, który analizował wzorce linkowe, SpamBrain identyfikuje całe sieci handlu linkami. System automatycznie neutralizuje (nullifies) wykryte spamowe linki, odbierając im wartość rankingową.