W maju 2024 z wyciekniętej dokumentacji Google API wyłoniła się cecha, która wcześniej żyła głównie w patentach: sourceType. Wartość wskazuje, z jakiego poziomu indeksu pochodzi strona linkująca – a co za tym idzie, jak Google traktuje link z tej strony. Ale sourceType to tylko jeden fragment większego obrazu. Trzy opatentowane przez Google mechanizmy opisują system, który dzieli każdą stronę na semantycznie odrębne regiony – i traktuje linki z tych regionów odmiennie.
Link w pierwszym akapicie artykułu i link w stopce tej samej strony mają tę samą wartość atrybutu href, ten sam status dofollow, ten sam Domain Rating w Ahrefs. Ale czy mają tę samą wartość w oczach algorytmu? Patenty mówią: niekoniecznie. Bill Slawski – który analizował patenty Google przez 17 lat na blogu SEO by the Sea – stwierdził to wprost w swojej analizie patentu o segmentacji stron: linki znalezione w różnych semantycznie odrębnych regionach mogą otrzymywać różne wagi, więc link w stopce strony może dostać mniejszą wagę niż link w ważniejszej sekcji. Przeczytaj też o patenty Google o backlinkach.
W tym artykule łączymy trzy warstwy: patenty opisujące mechanizmy segmentacji i detekcji boilerplate, oficjalne stanowisko Google na temat linków w szablonach, oraz nasze dane z audytu 120 backlinków, w których klasyfikowaliśmy położenie każdego linku w dokumencie źródłowym.
Trzy patenty, jeden wniosek: Google widzi, gdzie leży link
Patent 1: segmentacja dokumentu na semantycznie odrębne regiony
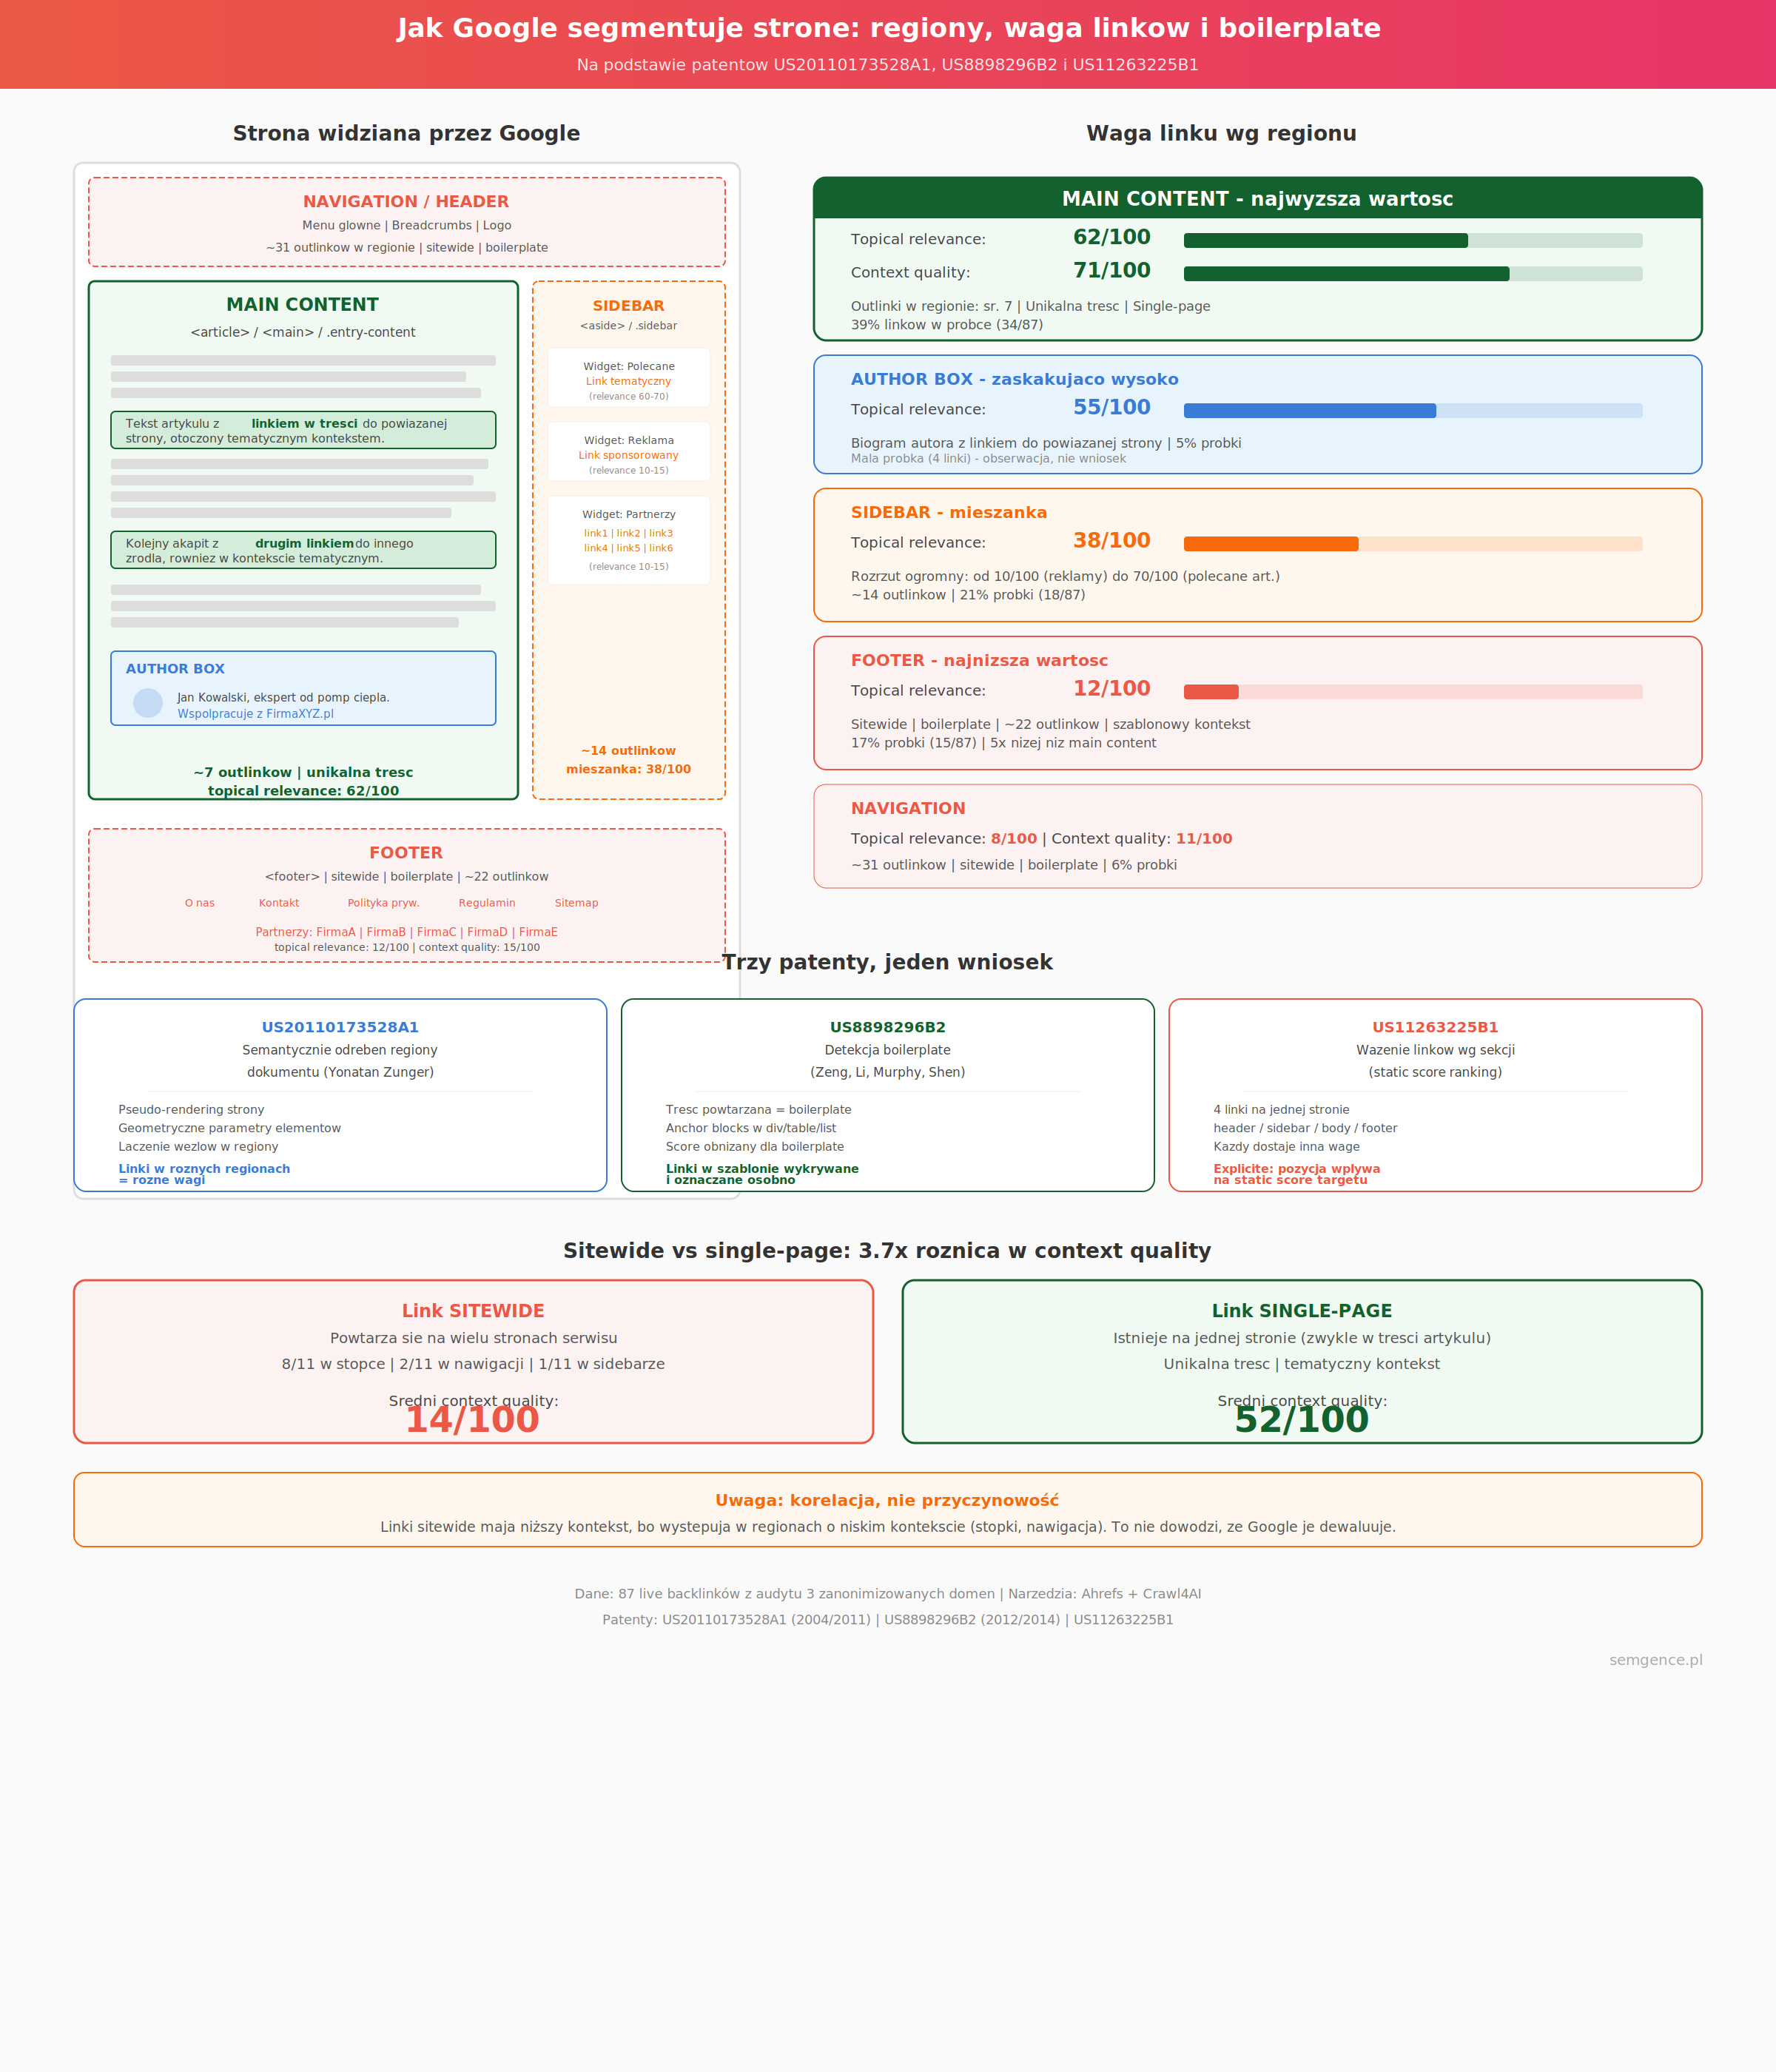
Patent US20110173528A1 („Determining Semantically Distinct Regions of a Document”) opisuje system, który tłumaczy dokument HTML na drzewo hierarchiczne, a następnie łączy węzły tego drzewa w regiony semantycznie odrębne – nagłówek, treść główna, sidebar, stopka, nawigacja. Wynalazca: Yonatan Zunger z Google. Patent z rodziny US7913163, zgłoszenie z 22 września 2004, udzielenie oryginalnego patentu w 2011.
Mechanizm opiera się na pseudo-renderingu: system nie patrzy tylko na kod HTML, ale symuluje wizualne renderowanie strony i na podstawie geometrycznych parametrów elementów (pozycja, rozmiar, otoczenie) decyduje, które fragmenty należą do tego samego regionu. Slawski opisał kluczową implikację: tekst znaleziony w niektórych częściach strony może mieć większą wagę niż w innych, więc strona z daną frazą kluczową w stopce może rankować niżej na to zapytanie niż gdyby ta fraza była w głównej treści.
Ta sama logika dotyczy linków: skoro system identyfikuje regiony, to może przypisywać linkom w tych regionach różne wagi. Link w <main> to nie to samo co link w <footer> – przynajmniej według możliwości opisanej w tym patencie.
Patent 2: detekcja boilerplate
Patent US8898296B2 („Detection of boilerplate content”) idzie dalej. Zamiast samej segmentacji opisuje system rozpoznawania treści powtarzalnej – boilerplate. Wynalazcy: Jian Zeng, Youlin Li, Brian R. Murphy i Yuzhu Shen z Google. Zgłoszenie: sierpień 2012, udzielenie: listopad 2014.
Patent definiuje boilerplate jako treść powtarzaną na wielu stronach jednego serwisu lub treść niezwiązaną z głównym tematem strony. System buduje drzewo DOM, identyfikuje węzły wykazujące cechy boilerplate (bloki nawigacyjne, reklamowe, disclaimer) i przypisuje im obniżony score. Kluczowy fragment: gdy treść boilerplate zawiera blok anchor (linki), system sprawdza, czy węzły są powiązane z elementami blokowym typu div, table lub list – typowymi strukturami menu nawigacyjnych i list linków w stopkach.
Co to oznacza: system potrafi nie tylko rozpoznać, że fragment strony jest boilerplate, ale też zidentyfikować, że linki w tym fragmencie są częścią powtarzalnego szablonu. To fundamentalnie różna sytuacja od linku osadzonego w unikalnej treści artykułu.
Patent 3: ważenie linków według sekcji dokumentu
Trzeci patent zamyka obraz. Dokument US11263225B1 opisuje system rankingowy, który explicite przypisuje różne wagi linkom wychodzącym w zależności od sekcji dokumentu. Patent podaje przykład z czterema linkami na jednej stronie: link w nagłówku (header), link w sidebarze (upper-middle, sidebar section), link w treści głównej (body section, middle of page) i link w stopce (footer section, near bottom). System przypisuje tym czterem linkom różne wartości – i te wartości wpływają na static score strony docelowej.
To nie jest spekulacja ani interpretacja. Patent wprost mówi: ponieważ cechy hiperłączy mają różne wartości, hiperłącza (outlinki) otrzymują różne wagi. Link w body section z pozycji „vertically near a middle of the first webpage” jest traktowany inaczej niż link w footer section z pozycji „vertically near a bottom of the first webpage”.
Co mówi oficjalna dokumentacja Google
Google spam policies wymieniają wprost „widely distributed links in the footers or templates of various sites” jako przykład link spamu, gdy służą manipulowaniu rankingiem. Dokumentacja Link Best Practices dodaje kontekst: Google używa linków do odkrywania nowych stron i do określania PageRank.
Zwróćmy uwagę na sformułowanie: „widely distributed links in the footers or templates” – szeroko dystrybuowane linki w stopkach i szablonach. Dokumentacja nie mówi „wszystkie linki w stopkach”. Mówi o masowej dystrybucji – czyli linkach, które pojawiają się w tej samej formie na setkach lub tysiącach stron serwisu. Link „Powered by [firma]” w stopce 500-stronowego serwisu to 500 identycznych linków z identycznym anchorem z regionu boilerplate. To dokładnie ten wzorzec, który patent US8898296B2 opisuje jako detekowalny.
Ale link do partnera biznesowego na stronie „Nasi partnerzy” – nawet jeśli technicznie jest w dolnej części strony – to zupełnie inna sytuacja: pojedynczy link, unikalna treść, unikalny kontekst.
Google API Leak 2024: co ujawnił o placemencie linków
Wyciekła dokumentacja Google API z maja 2024 (potwierdzona przez Google 29 maja 2024) dodaje trzy istotne fragmenty do obrazu.
Po pierwsze: atrybut sourceType wskazuje na to, że Google rozróżnia strony linkujące według poziomu indeksu. Strony z wyższego poziomu (editorial, high-quality, frequently updated) dostarczają linki o większej wartości. To nie mówi bezpośrednio o placemencie – ale mówi o tym, że Google ma mechanizm różnicowania wartości linków.
Po drugie: pola context2, fullLeftContext i fullRightContext potwierdzają, że Google zapisuje kontekst tekstowy wokół linku – hash 5 słów na lewo i prawo (zgodnie z patentem US8577893B1, który omówiliśmy w artykule o anchor context) oraz pełne fragmenty zdań. Skoro Google zapisuje kontekst, to logiczne jest, że rozróżnia kontekst z main content od kontekstu z boilerplate.
Po trzecie: atrybut anchorMismatchDemotion sugeruje, że Google może ignorować lub obniżać wagę linków, gdy istnieje rozbieżność tematyczna między treścią strony źródłowej a stroną docelową. To powiązane z placementem: link w treści artykułu o pompach ciepła, prowadzący do sklepu z pompami, ma naturalny kontekst tematyczny. Ten sam link w stopce z napisem „Partnerzy” obok 20 innych linków do niezwiązanych stron – kontekstu tematycznego nie ma.
Reasonable Surfer: model, który zmienia wagę linku według pozycji
Zanim przejdziemy do danych, trzeba omówić patent, który łączy placement z zachowaniem użytkownika. Patent US7716225B1 („Ranking documents based on user behavior and/or feature data”), znany w branży jako „Reasonable Surfer”, opisuje model, w którym prawdopodobieństwo kliknięcia linku przez rozsądnego użytkownika wpływa na wagę tego linku w kalkulacji PageRank.
Patent explicite wymienia cechy, które wpływają na to prawdopodobieństwo: pozycja linku na stronie (wyżej = większe prawdopodobieństwo kliknięcia), rozmiar czcionki linku, czy link jest w treści czy w bloku nawigacyjnym, ile innych linków jest w tym samym regionie, czy anchor text jest związany z tematem strony.
Tim Soulo z Ahrefs odniósł się do tego patentu w badaniu o linkach ze stron z ruchem: od czasu gdy społeczność SEO zapoznała się z patentem Reasonable Surfer, nie brakuje argumentów o wartości linków ze stron z ruchem. Część osób uważa je za cenniejsze niż linki ze stron bez ruchu – i dane korelacyjne Ahrefs to potwierdzają, choć z zastrzeżeniem o braku dowodu przyczynowości.
Implikacja dla placementu jest prosta: link w pierwszym akapicie artykułu, widoczny natychmiast po załadowaniu strony, w kontekście tematycznie powiązanym – ma wyższe prawdopodobieństwo kliknięcia niż link w 47. pozycji na liście partnerów w stopce. Jeśli Google waży linki proporcjonalnie do prawdopodobieństwa kliknięcia, to placement ma znaczenie nie jako abstrakcyjna reguła, ale jako proxy klikalności.
Jak klasyfikowaliśmy regiony w audycie
W audycie 120 backlinków, którego wyniki przedstawiliśmy w artykule o anchor context, klasyfikowaliśmy każdy link według regionu semantycznego strony źródłowej. Metodologia: pobranie rendered DOM za pomocą Crawl4AI, identyfikacja regionu na podstawie struktury HTML5 (<main>, <article>, <nav>, <footer>, <aside>) oraz heurystyk wizualnych (klasy CSS typu sidebar, footer-links, widget-area).
Wyróżniliśmy 8 regionów:
- Main content – treść artykułu, opisu produktu, poradnika. Otoczony tagami
<article>lub<main>, lub wewnątrz<div>z klasami typuentry-content,post-body - Author box – biogram autora, zwykle pod artykułem lub w sidebarze
- Navigation – menu główne, breadcrumbs, paginacja
- Footer – stopka serwisu, zwykle wewnątrz
<footer> - Sidebar – kolumna boczna, wewnątrz
<aside>lub divów z klasamisidebar,widget - Comment – sekcja komentarzy
- Widget/directory – bloki „polecane artykuły”, „partnerzy”, „katalog firm”
- Nie do ustalenia – strona zablokowana przez WAF/Cloudflare lub JavaScript uniemożliwiający parsing
Wyniki według placementu: co zobaczyliśmy w 120 backlinkach
Z 120 backlinków w próbie audytowej (3 zanonimizowane domeny klienckie, dane Ahrefs + Crawl4AI), po wykluczeniu linków niedostępnych i nierozstrzygniętych, udało nam się sklasyfikować placement dla 87 linków live.
| Region | Liczba linków | % próby | Śr. topical relevance | Śr. context quality |
|---|---|---|---|---|
| Main content | 34 | 39% | 62/100 | 71/100 |
| Sidebar | 18 | 21% | 38/100 | 34/100 |
| Footer | 15 | 17% | 12/100 | 15/100 |
| Widget/directory | 9 | 10% | 22/100 | 19/100 |
| Navigation | 5 | 6% | 8/100 | 11/100 |
| Author box | 4 | 5% | 55/100 | 48/100 |
| Comment | 2 | 2% | 41/100 | 28/100 |
Trzy obserwacje.
Po pierwsze: linki w main content mają drastycznie wyższy topical relevance i context quality niż linki w pozostałych regionach. Średni topical relevance 62/100 dla main content versus 12/100 dla footer i 8/100 dla navigation. To nie jest subtelna różnica – to pięciokrotna. Przyczyna jest oczywista: treść artykułu jest z definicji tematyczna. Stopka z definicji jest generyczna.
Po drugie: sidebar to mieszanka. 38/100 to średnia, ale rozrzut jest ogromny. Część linków sidebarowych to widgety „polecane artykuły” z tematycznie powiązaną treścią (relevance 60-70) – efektywnie quasi-kontekstowe. Inne to listy partnerów i reklamy (relevance 10-15). Klasyfikacja „sidebar” bez kontekstu jest bezużyteczna.
Po trzecie: author box daje wynik zaskakująco wysoki (55/100 topical relevance). Linki w biogramie autora („Jan Kowalski, ekspert od pomp ciepła, współpracuje z firmą X”) mają naturalny kontekst tematyczny. To nie jest boilerplate w sensie patentowym – to unikalna treść opisująca osobę, z linkiem do powiązanej strony.
Kiedy stopka jest naturalna, a kiedy ryzykowna?
Na podstawie danych i dokumentacji Google, wyłaniają się dwa wzorce stopkowych linków:
Wzorzec naturalny: „Stronę zaprojektowała agencja XYZ” na jednej stronie (zwykle strona główna). To jest credit, nie manipulacja. Jest jeden link, nie 500. Jest na jednej stronie, nie na każdej podstronie. Google spam policies mówią o „widely distributed” – ten wzorzec nie jest widely distributed.
Wzorzec ryzykowny: „Partnerzy: Firma A | Firma B | Firma C | … | Firma Z” w stopce powtarzającej się na 500 stronach serwisu. To 500 identycznych linków z identycznym anchorem z regionu boilerplate. To dokładnie wzorzec, który patent US8898296B2 opisuje jako detekowalny, a Google spam policies wymieniają jako przykład link spamu.
Między tymi dwoma biegunami leży szara strefa. Link w stopce na stronie „Nasi partnerzy” – nie jest sitewide, ale jest w stopce. Link „Powered by WordPress” – jest sitewide, ale jest naturalny (credit oprogramowania). Link agencji SEO w stopce 200-stronowego serwisu klienta – jest sitewide, ale odzwierciedla prawdziwy związek biznesowy.
Nasza rekomendacja z audytu: nie oceniaj linku stopkowego automatycznie jako słabego. Oceniaj go przez pryzmat trzech pytań: (1) czy jest sitewide? (2) ile innych linków jest w tym samym bloku? (3) czy treść wokół linku jest unikalna czy szablonowa?
Sitewide vs single-page: ile kopii tego samego linku ma znaczenie?
Patent o detekcji boilerplate (US8898296B2) explicite definiuje boilerplate jako treść powtarzaną na wielu stronach jednego serwisu. Ale ile to jest „wiele”? Patent nie podaje liczby. Google nie podaje liczby. Branża pracuje z heurystykami.
W naszej próbie 120 linków zidentyfikowaliśmy 11 linków sitewide (pojawiających się na więcej niż jednej stronie tego samego serwisu źródłowego). Z tych 11 linków sitewide: 8 było w stopce, 2 w nawigacji i 1 w sidebarze. Żaden link sitewide nie znajdował się w main content – co jest logiczne: treść artykułu jest z definicji unikalna, więc link w treści artykułu nie powtarza się na innych stronach.
Średni context quality dla linków sitewide: 14/100. Dla linków single-page: 52/100. Różnica 3.7x. Ale uwaga: to nie dowodzi, że Google obniża wagę linków sitewide. To dowodzi, że linki sitewide mają niższy kontekst – bo występują w regionach o niskim kontekście (stopki, nawigacja). Przyczynowość może działać w obu kierunkach.
Jak weryfikować placement po publikacji linku
Kupujesz artykuł sponsorowany. Wydawca publikuje go z linkiem w trzecim akapicie. Po trzech miesiącach link jest w sidebarze z napisem „Archiwum sponsorowane”. Po sześciu miesiącach – w stopce, w sekcji „Partnerzy”. To nie jest scenariusz hipotetyczny – obserwujemy to regularnie w audytach.
Weryfikacja placementu wymaga rendered DOM, nie raw HTML. Strona może mieć link w <main> w HTML, ale JavaScript przenosi go do sticky sidebara w rendered wersji. Crawl4AI fetchuje rendered DOM – i właśnie dlatego używamy go zamiast prostego fetchowania HTML.
Nasz pipeline weryfikacyjny dla placementu:
- Fetch rendered DOM (Crawl4AI)
- Identyfikacja regionu semantycznego (HTML5 tags + klasy CSS)
- Sprawdzenie sitewide (czy ten sam blok linkowy jest na innych stronach serwisu)
- Policzenie outlinków w regionie (ile linków wychodzących jest w tym samym bloku)
- Ocena kontekstu (anchor + tekst wokół linku – czy jest tematycznie powiązany z targetem)
- Porównanie z pierwszą wersją (jeśli mamy snapshot z momentu publikacji)
Krok 6 jest najważniejszy i najrzadziej wykonywany w branży. Większość SEO-wców sprawdza link raz – w momencie publikacji – i nigdy do niego nie wraca. Nasze dane sugerują, że placement zmienia się w czasie i że link, który zaczął w main content, może migrować do regionu o niższym kontekście.
Ile linków wychodzących w regionie? Problem gęstości
Patent Reasonable Surfer (US7716225B1) wymienia liczbę linków w regionie jako jedną z cech wpływających na prawdopodobieństwo kliknięcia. Logika: jeśli w bloku jest 3 linki, prawdopodobieństwo kliknięcia konkretnego jest ~33%. Jeśli w bloku jest 50 linków – ~2%.
W naszej próbie 120 linków zmierzyliśmy liczbę outlinków w regionie dla każdego backlinku. Wyniki:
| Region | Śr. outlinków w regionie | Mediana | Max |
|---|---|---|---|
| Main content | 7 | 5 | 28 |
| Sidebar | 14 | 12 | 45 |
| Footer | 22 | 18 | 67 |
| Navigation | 31 | 28 | 84 |
| Widget/directory | 18 | 15 | 52 |
Link w main content dzieli region średnio z 7 innymi linkami. Link w stopce – z 22. Link w nawigacji – z 31. Jeśli model Reasonable Surfer jest stosowany, to link w treści artykułu nie tylko ma lepszy kontekst tematyczny, ale też mniejszą konkurencję o uwagę użytkownika – a co za tym idzie, wyższe prawdopodobieństwo kliknięcia i potencjalnie wyższą wagę.
Czego nie wiemy i na co nie mamy dowodów
Żaden z opisanych patentów nie dowodzi, że Google aktualnie używa segmentacji dokumentu do ważenia linków. Patenty opisują możliwość techniczną, nie konfigurację produkcyjną. API Leak ujawnił struktury danych, nie wagi algorytmu. Nasze dane z audytu pokazują korelacje – nie przyczynowość.
Nie mamy dowodów na to, że:
- Google zeruje wszystkie linki w stopkach – dokumentacja mówi o masowej dystrybucji, nie o automatycznym zerowaniu
- Link w first viewport jest X razy silniejszy niż link below the fold – żadne publiczne dane nie podają mnożnika
- Sitewide linki są automatycznie dewaluowane – mogą być, ale mogą też być traktowane jak jeden link (deduplikacja)
- Author box jest optymalnym placementem – nasze dane pokazują wysoki relevance, ale próba 4 linków jest za mała
Co mamy: spójny obraz z trzech niezależnych źródeł (patenty, dokumentacja, dane audytowe), który wskazuje, że placement jest sygnałem diagnostycznym. Nie samodzielnym werdyktem – ale sygnałem, który w połączeniu z kontekstem, anchorem i topical relevance daje pełniejszy obraz jakości backlinku.
Implikacje praktyczne: co z tego wynika dla budowania linków
Na podstawie triangulacji patentów, dokumentacji Google i danych audytowych, formułujemy pięć wskaźników diagnostycznych dotyczących placementu:
- Link w main content > link w dowolnym innym regionie – i to z dużą przewagą w topical relevance (62 vs 12-38/100 w naszych danych). Negocjując publikację sponsorowaną, weryfikuj, że link jest w treści artykułu, nie w widgecie „Partnerzy”.
- Sitewide = ryzyko – ale nie automatyczne ryzyko. Sitewide link z creditem agencji na stronie głównej to inna sytuacja niż sitewide link z anchorem „tanie pożyczki” w stopce 2000 stron. Pierwszy jest naturalny; drugi odpowiada opisowi z Google spam policies.
- Gęstość regionu ma znaczenie – link w artykule z 5 outlinkami daje prawdopodobnie wyższy sygnał niż link na stronie partnerów obok 50 innych linków. Reasonable Surfer sugeruje to wprost.
- Weryfikuj rendered DOM, nie raw HTML – JavaScript może przenosić elementy między regionami. Sticky sidebar, lazy loading, dynamicznie ładowane widgety – to wszystko zmienia placement po stronie użytkownika i crawlera.
- Weryfikuj placement regularnie – link kupiony 6 miesięcy temu mógł migrować z treści do archiwum, z artykułu do widgetu. Jednorazowa weryfikacja nie wystarcza.
Najczęściej zadawane pytania
Czy Google ignoruje wszystkie linki w stopce?
Nie. Dokumentacja Google mówi o szeroko dystrybuowanych linkach w stopkach i szablonach jako przykładzie link spamu, gdy służą manipulacji rankingiem. Nie mówi o automatycznym zerowaniu każdego linku szablonowego. Link w stopce na jednej stronie (np. credit agencji) to zupełnie inna sytuacja niż ten sam link w stopce 500 stron.
Czym różni się link sitewide od linku single-page?
Link sitewide pojawia się na wielu stronach tego samego serwisu (zwykle w nawigacji, stopce lub sidebarze). Link single-page istnieje na jednej stronie – zwykle w treści artykułu. W naszej próbie linki sitewide miały średni context quality 14/100, a single-page 52/100.
Czy placement linku zmienia się w czasie?
Tak. Obserwujemy regularnie migrację linków z main content do archiwum, z artykułu do widgetu partnerów, z treści do sidebara. Weryfikacja rendered DOM w momencie publikacji nie gwarantuje, że link będzie w tym samym regionie za 6 miesięcy.
Ile linków wychodzących w regionie to za dużo?
Patent Reasonable Surfer sugeruje, że liczba linków w regionie wpływa na prawdopodobieństwo kliknięcia. W naszych danych linki w main content dzieliły region średnio z 7 innymi linkami, a linki w stopce z 22. Nie ma publicznego progu, ale logika prawdopodobieństwa kliknięcia jest jasna.
Czy warto kupować linki w sidebarze?
Sidebar to mieszanka. Część linków sidebarowych (polecane artykuły z tematycznym kontekstem) miała w naszej próbie topical relevance 60-70/100. Inne (reklamy, listy partnerów) – 10-15/100. Sam fakt, że link jest w sidebarze, nie mówi nic bez kontekstu.