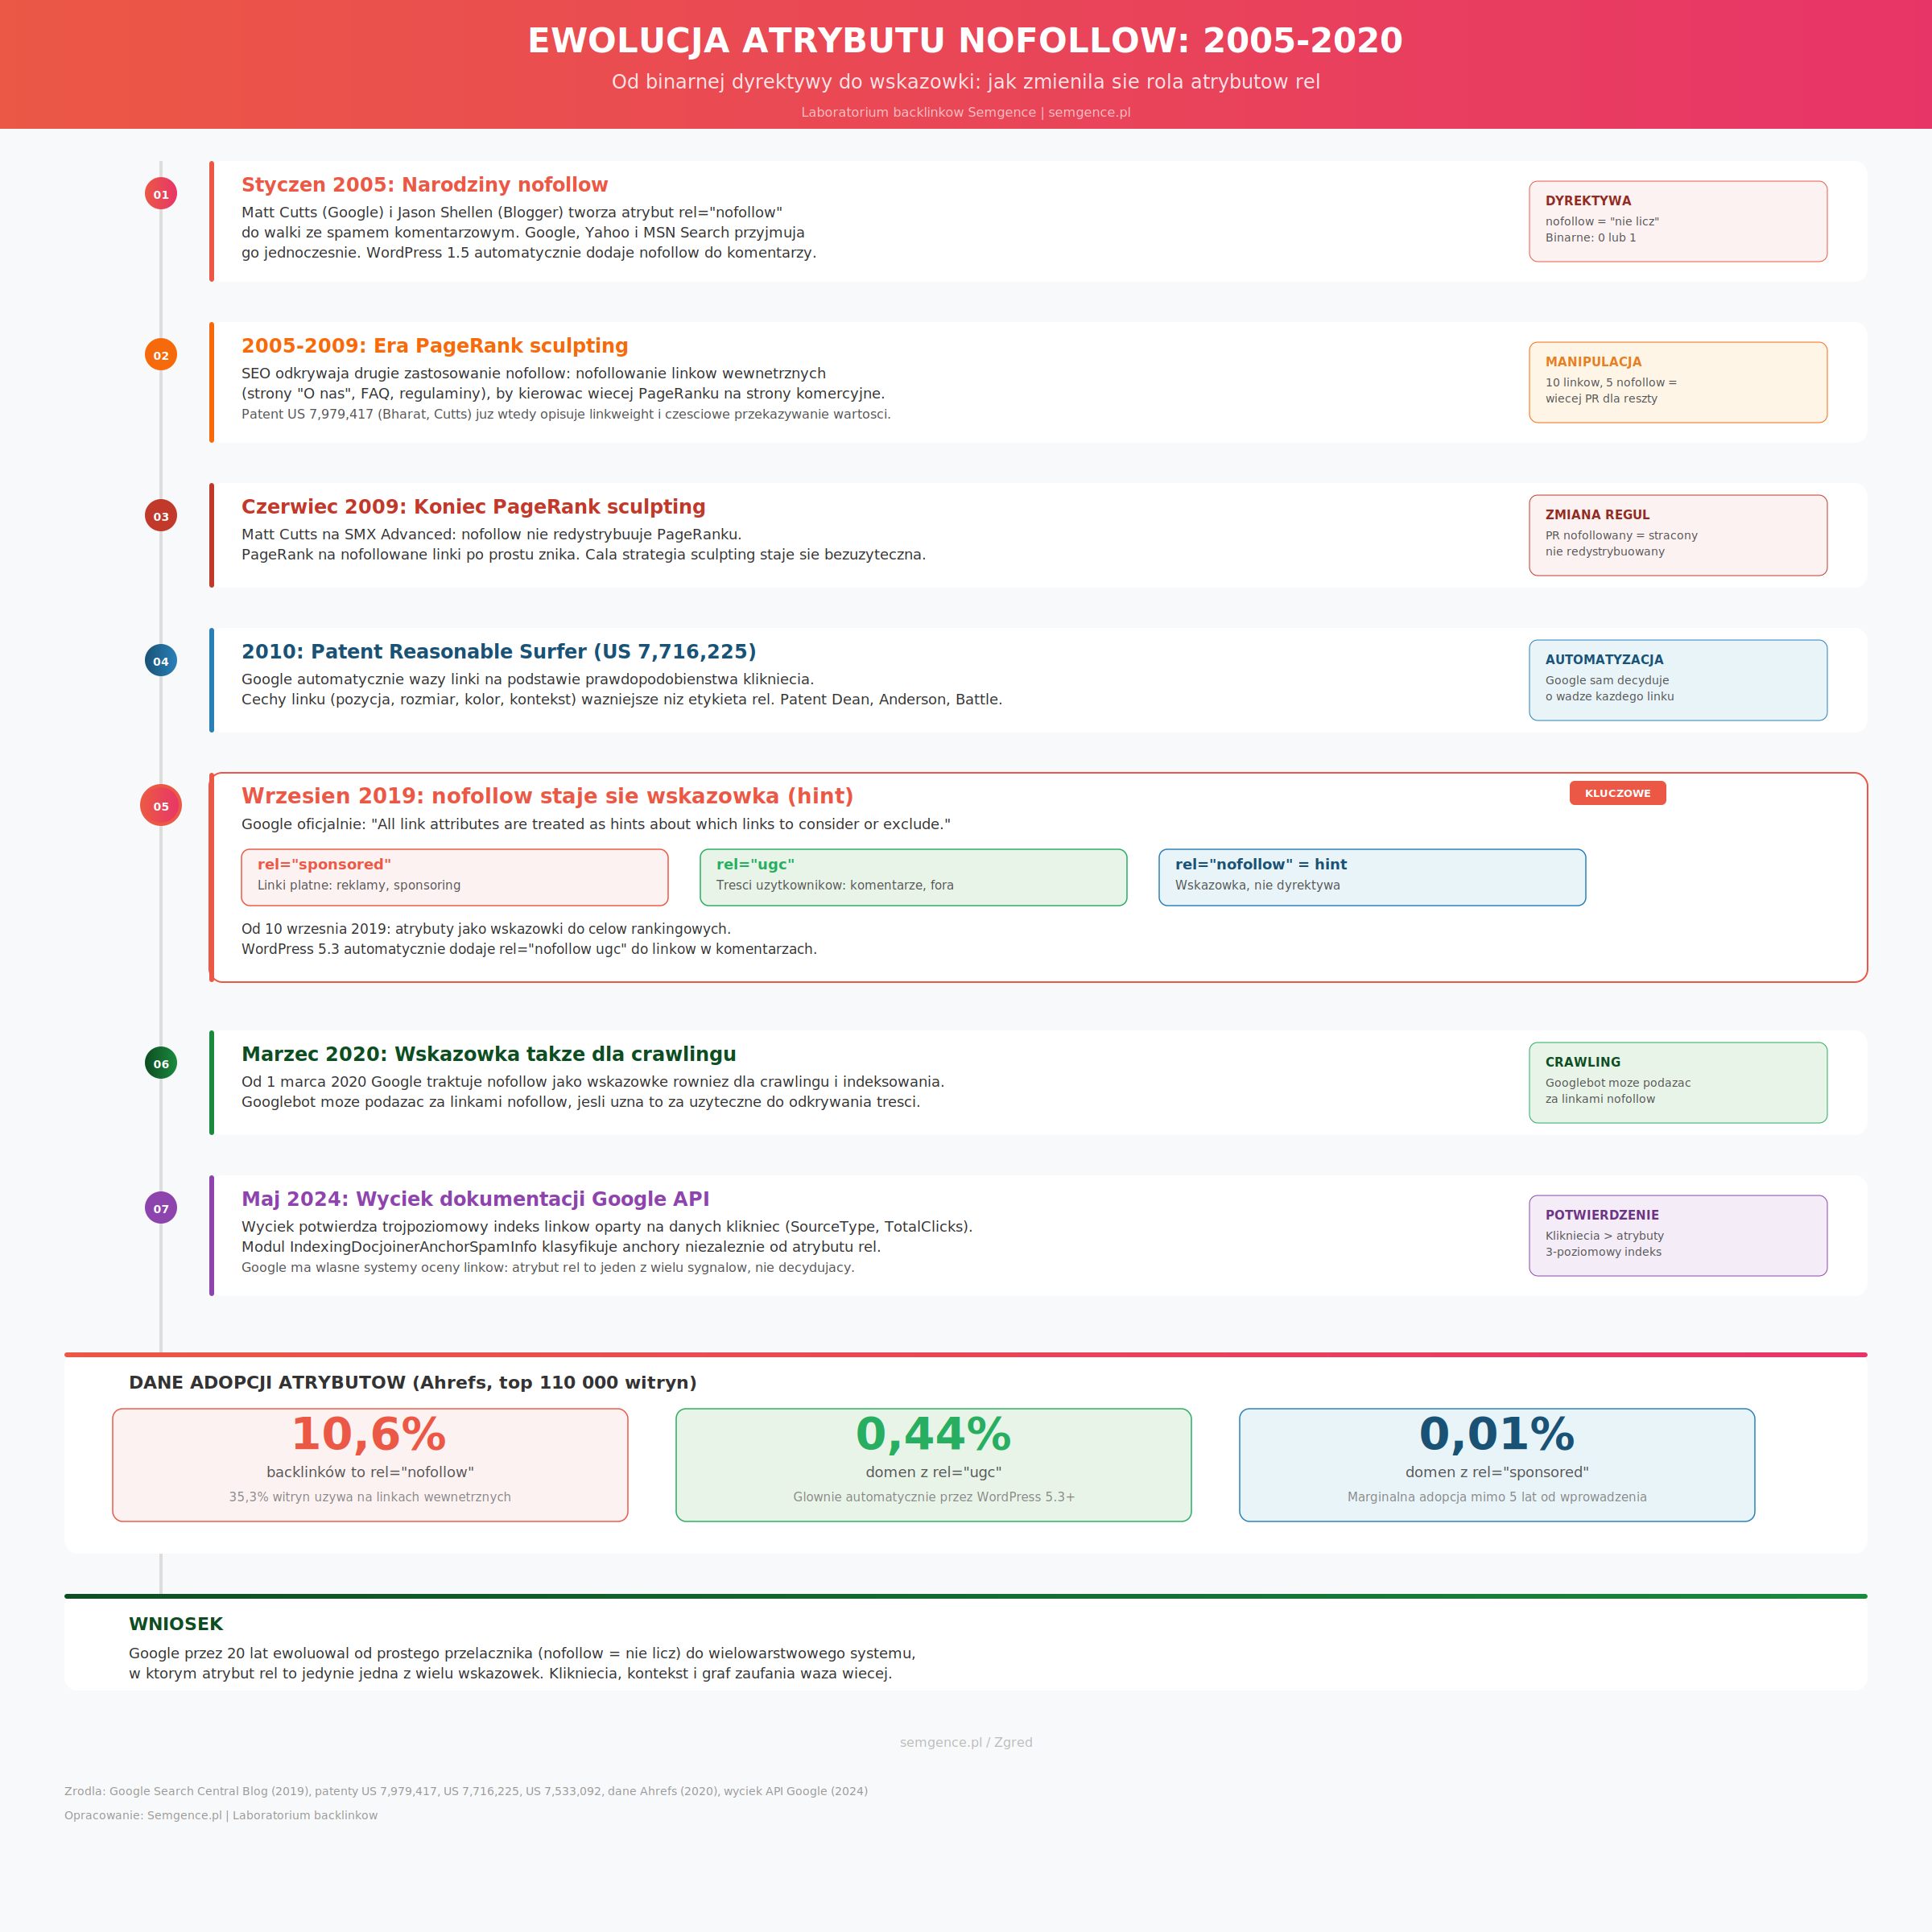
W styczniu 2005 roku Matt Cutts z Google i Jason Shellen z Bloggera ogłosili na swoich blogach, że komentarze spamowe stracą właśnie dostęp do PageRanku. Rozwiązanie było elegancko proste: jeden atrybut HTML, rel="nofollow", który mówił wyszukiwarce „nie licz tego linku”. W ciągu tygodni Google, Yahoo i MSN Search zgodnie go przyjęły. Branża SEO dostała jasny sygnał: link z nofollow jest martwy dla rankingu.
Dwadzieścia lat później ten prosty podział na „follow” i „nofollow” wygląda jak mapa z epoki odkryć geograficznych: przydatna, ale niewystarczająca do nawigacji. 10 września 2019 roku Google oficjalnie ogłosiło, że nofollow przestaje być dyrektywą i staje się jedynie wskazówką. Jednocześnie wprowadziło dwa nowe atrybuty: rel="sponsored" dla linków płatnych i rel="ugc" dla treści generowanych przez użytkowników. W tym artykule sprawdzamy, co te zmiany oznaczają w praktyce, ile stoi za nimi patentów i danych, i dlaczego proste dzielenie linków na „dofollow” i „nofollow” to dziś anachronizm.
Dlaczego Google w ogóle stworzył atrybut nofollow?
Kontekst 2005 roku jest kluczowy do zrozumienia kolejnych 20 lat ewolucji. Blogi przeżywały eksplozję popularności, a z nią falę komentarzy spamowych. Automaty wrzucały linki do Viagry i kasyn w każdy otwarty formularz komentarzy, kradnąc PageRank z legalnych witryn. Matt Cutts, ówczesny szef zespołu webspam Google, wprost opisał skalę problemu: komentarze spamowe generowały miliony linków dziennie, wypaczając graf linków, na którym opierał się cały system rankingowy Google.
Nofollow miał być chirurgicznym narzędziem: nie blokuj komentarzy, ale odetnij im przepływ PageRanku. Google, Yahoo i MSN Search (Wikipedia, Nofollow) przyjęły atrybut jednocześnie, co w historii wyszukiwarek zdarza się niezwykle rzadko. WordPress od wersji 1.5 automatycznie dodawał nofollow do wszystkich linków w komentarzach. Rozwiązanie szybko wyszło poza komentarze: webmasterzy zaczęli stosować nofollow na linkach do stron logowania, regulaminów, polityk prywatności, czyli wszędzie tam, gdzie link nie powinien „oddawać” wartości.
Czym było PageRank sculpting i dlaczego Google je zabił?
Między 2005 a 2009 rokiem branża SEO odkryła drugie zastosowanie nofollow, które jego twórcy prawdopodobnie nie planowali: PageRank sculpting. Logika była prosta: jeśli strona ma 10 linków, a 5 oznaczysz jako nofollow, to pozostałe 5 dostanie większą porcję PageRanku. Webmasterzy zaczęli masowo nofollować linki do stron „O nas”, FAQ, regulaminów, kierując cały PageRank na strony komercyjne.
15 czerwca 2009 roku Matt Cutts ogłosił na konferencji SMX Advanced, że Google zmienił sposób liczenia. Nofollowane linki nadal nie przekazują PageRanku, ale PageRank, który by na nie przypadał, nie jest już redystrybuowany do pozostałych linków. Po prostu znika. Jedna deklaracja i cała strategia sculpting stała się bezużyteczna.
Co ciekawe, Google już wcześniej patentował rozwiązania wykraczające daleko poza binarny model follow/nofollow. Patent US 7,979,417 „Embedded Communication of Link Information” (Krishna Bharat, Matthew D. Cutts, Paul G. Haahr, Radhika A. Malpani, Vibhu Mittal, Marcin Kaszkiel; zgłoszony 30 czerwca 2005, przyznany 12 lipca 2011; Google Patents) opisuje mechanizm linkweight, który pozwala na przekazywanie ułamkowego PageRanku. Zamiast binarnego 0/1, link mógłby przekazywać np. 50% wartości. Patent proponuje także „opinion-passing links”, czyli linki niosące subiektywną ocenę, np. offensive=very czy funny=somewhat. To pokazuje, że Google od początku myślał o linkach jako o nośnikach wielowymiarowej informacji, nie prostych głosach „za” lub „przeciw”.
Co dokładnie zmieniło ogłoszenie Google z września 2019?
10 września 2019 roku Google opublikował na oficjalnym blogu Search Central wpis „Evolving nofollow: new ways to identify the nature of links” (Google Search Central Blog). Zmiana obejmowała trzy elementy.
Po pierwsze: rel="sponsored" dla linków, za które ktoś zapłacił. Reklamy, artykuły sponsorowane, płatne recenzje: każdy link będący wynikiem transakcji finansowej powinien dostać ten atrybut. To formalnie zastąpiło praktykę oznaczania reklam jako nofollow, choć Google wyraźnie zaznaczył, że dotychczasowe nofollow na linkach sponsorowanych nadal będzie respektowane.
Po drugie: rel="ugc" dla treści generowanych przez użytkowników. Komentarze na blogach, posty na forach, recenzje: wszystko, co napisali użytkownicy, a nie redakcja witryny. WordPress od wersji 5.3 (wydanej 12 listopada 2019) automatycznie oznacza linki w komentarzach jako rel="nofollow ugc", łącząc oba atrybuty dla kompatybilności wstecznej (Search Engine Journal).
Po trzecie, i najważniejsze: nofollow przestał być dyrektywą, a stał się wskazówką (hint). Google oficjalnie napisał: „All the link attributes, sponsored, UGC and nofollow, are treated as hints about which links to consider or exclude within Search”. To fundamentalna zmiana filozoficzna. Przez 14 lat nofollow było nakazem: „Nie licz tego linku”. Od 2019 roku to sugestia: „Ten link może nie być wart liczenia, ale ostateczna decyzja należy do nas”.
Zmiana weszła w życie w dwóch fazach. Od 10 września 2019 Google zaczął traktować atrybuty jako wskazówki do celów rankingowych, co oznacza, że nofollow mógł zacząć przekazywać wartość rankingową, jeśli algorytm uznał to za zasadne. Od 1 marca 2020 roku wskazówki objęły także crawling i indeksowanie, czyli Google mógł zacząć podążać za linkami nofollow, nawet jeśli wcześniej ich nie odwiedzał.
Jak patenty Google traktują różne typy linków?
Oficjalne komunikaty Google to jedno. Patenty pokazują, jak systemy mogą faktycznie działać. Trzy patenty są szczególnie istotne w kontekście klasyfikacji linków.
Patent US 7,979,417 „Embedded Communication of Link Information” (Bharat, Cutts, Haahr et al., 2005/2011; Google Patents) wprowadza koncepcję granularnej kontroli nad linkami. Zamiast binarnego follow/nofollow, system pozwala na atrybuty typu linkweight=0.5, umożliwiając częściowe przekazywanie wartości. Bill Slawski, analizując ten patent na SEO by the Sea, zauważył, że „it looks like a way of enabling a site owner to do some PageRank sculpting”, ale dodał, że Reasonable Surfer patent czyni takie ręczne sterowanie zbędnym, bo Google i tak waży linki automatycznie.
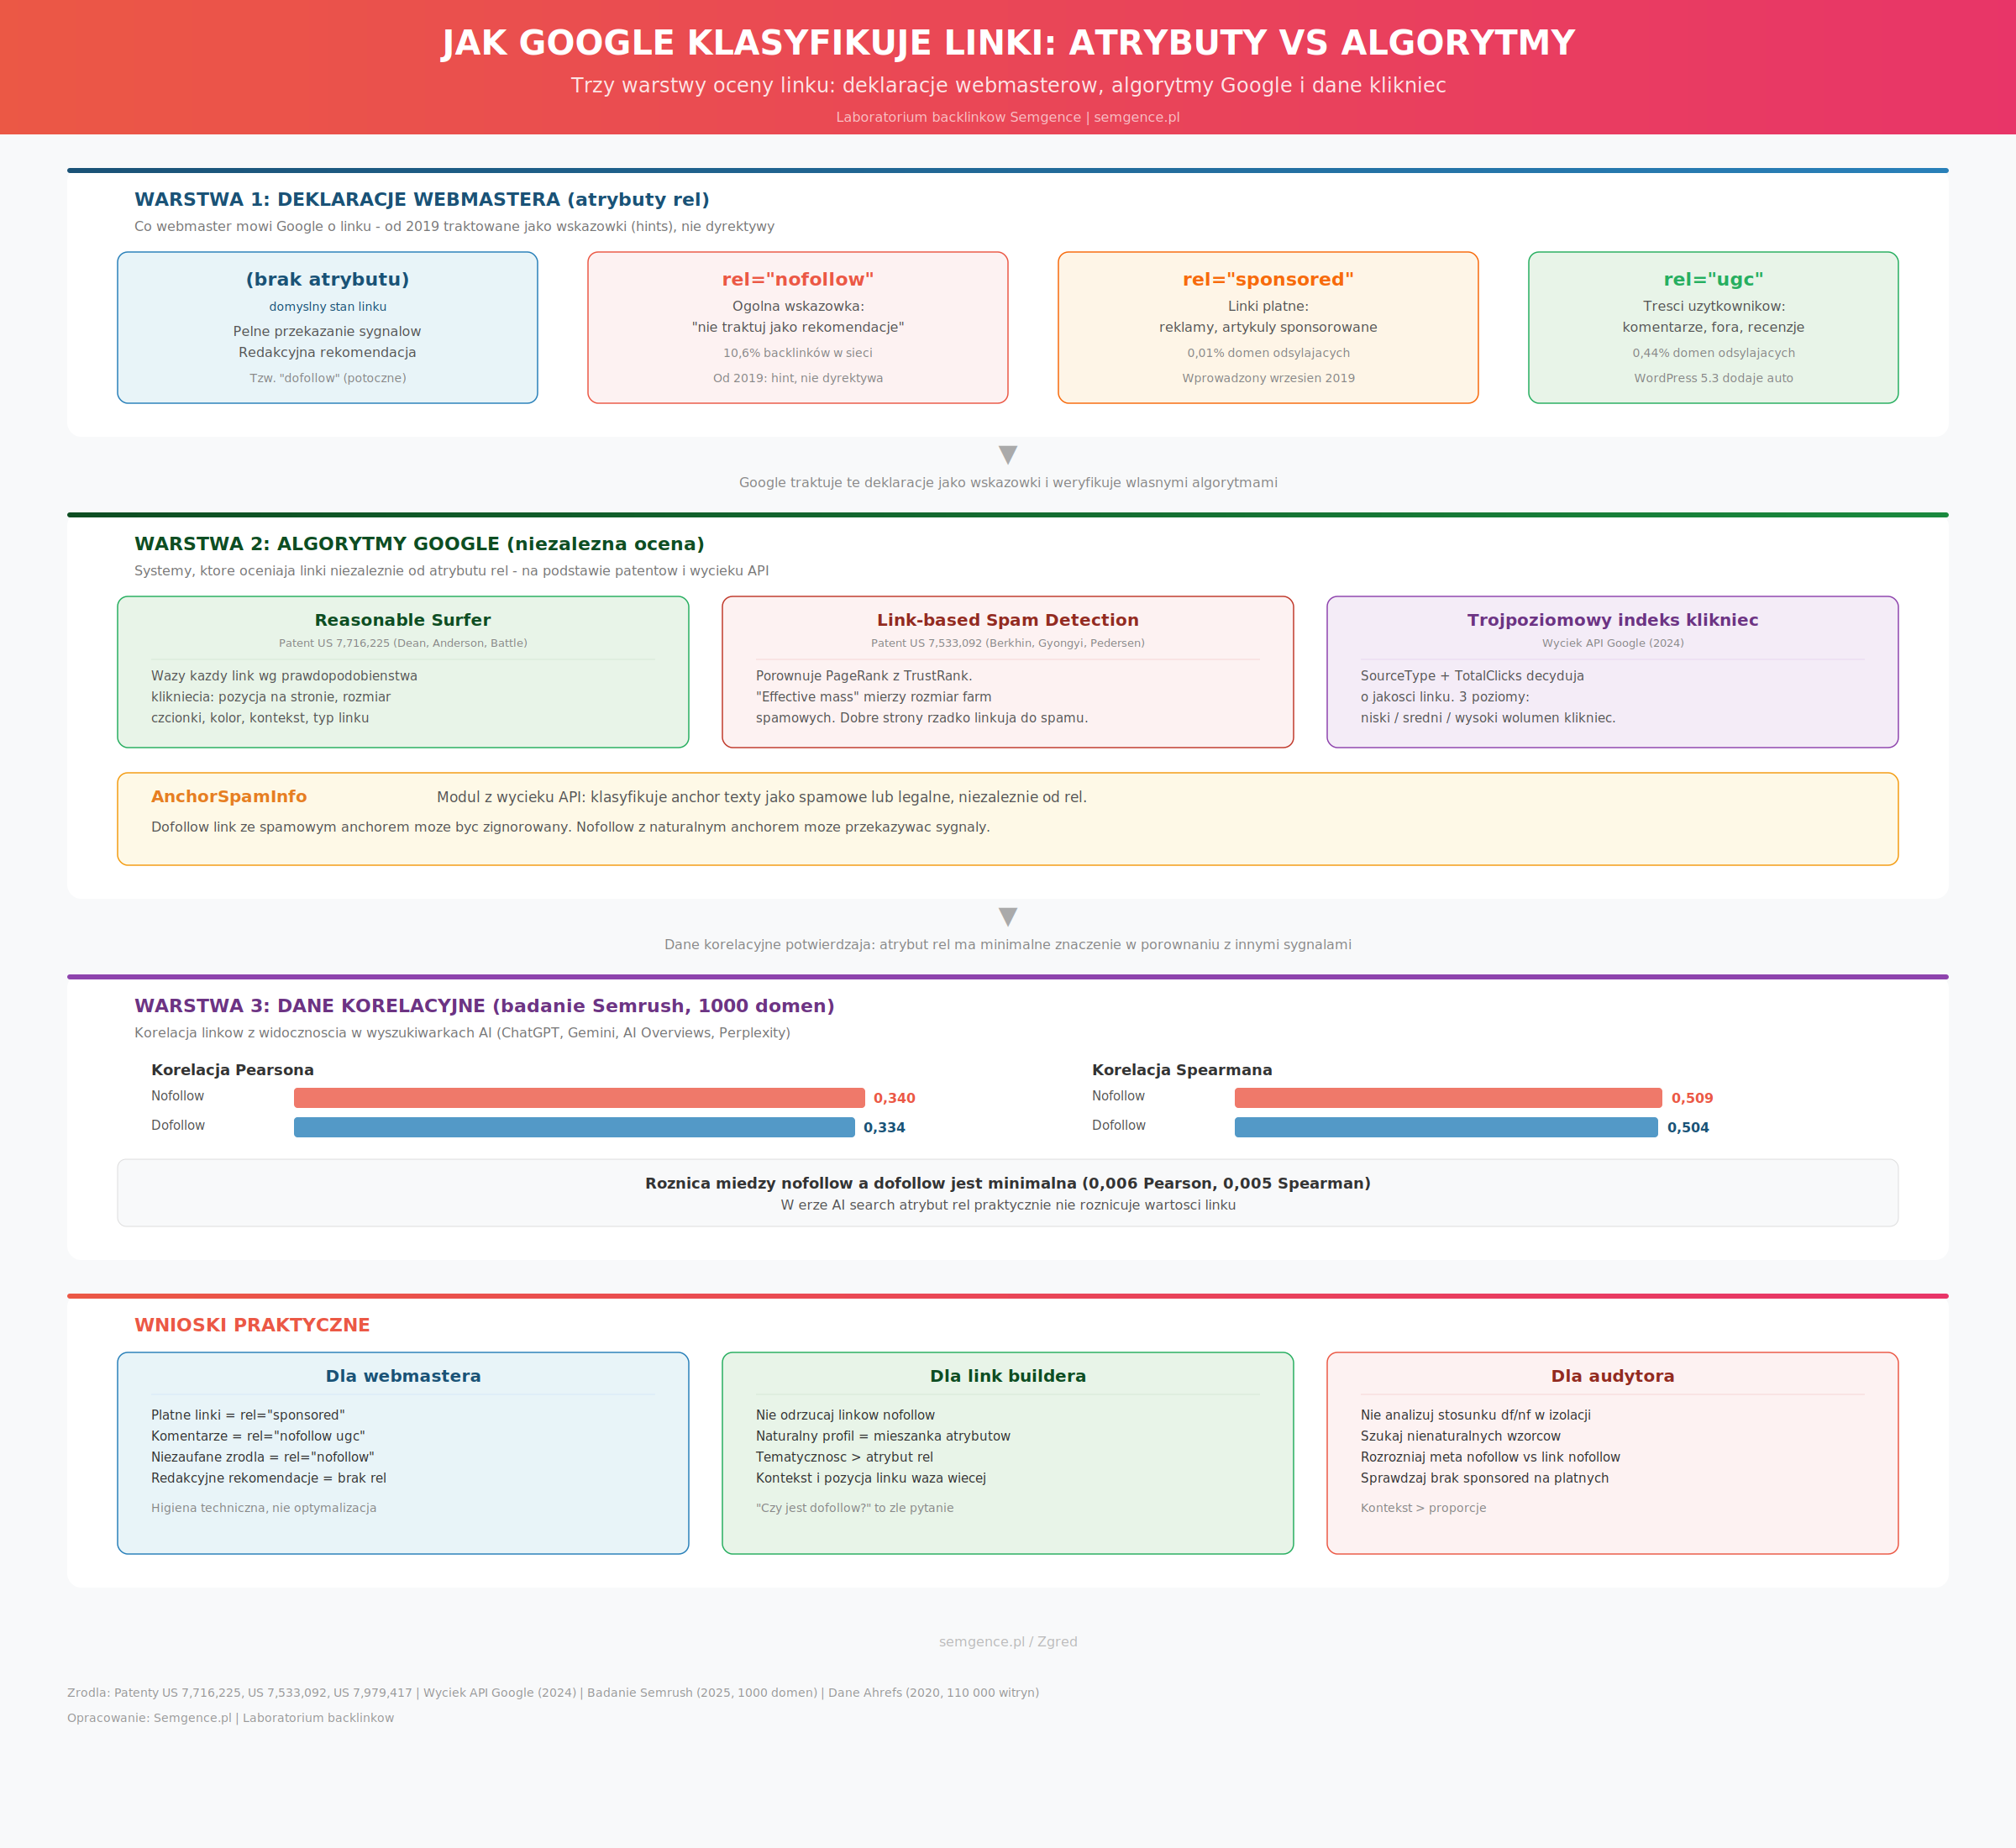
Patent US 7,716,225 „Ranking documents based on user behavior and/or feature data” (Jeffrey A. Dean, Corin Anderson, Alexis Battle; zgłoszony 17 czerwca 2004, przyznany 11 maja 2010; Google Patents) to patent Reasonable Surfer, który redefiniuje PageRank. Zamiast traktować wszystkie linki równo, system przypisuje każdemu linkowi prawdopodobieństwo kliknięcia na podstawie cech takich jak: rozmiar czcionki anchora, pozycja na stronie (góra vs dół), kolor tekstu, liczba słów w anchor texcie, typ linku (tekstowy vs obrazkowy) i kontekst słów otaczających link. Patent nie wspomina wprost o nofollow, ale jego logika jest przełomowa: wartość linku nie zależy od etykiety, lecz od tego, czy realny użytkownik prawdopodobnie by go kliknął.
Patent US 7,533,092 „Link-based spam detection” (Pavel Berkhin, Zoltan Istvan Gyongyi, Jan Pedersen; zgłoszony 4 sierpnia 2005, przyznany 12 maja 2009; Google Patents) opisuje system wykrywania sztucznego zawyżania PageRanku. Kluczowe pojęcie to „effective mass” (efektywna masa), mierząca szacowany rozmiar farm spamowych wskazujących na daną stronę. System porównuje PageRank strony z jej TrustRank i kiedy różnica przekracza próg, oznacza linki jako podejrzane. Zasada opisana w ramach koncepcji TrustRank jest prosta: dobre strony rzadko linkują do spamu. Ten patent bezpośrednio wpływa na to, jak Google traktuje linki z potencjalnie niezaufanych źródeł, niezależnie od ich atrybutu rel.
Razem te trzy patenty rysują obraz systemu, w którym atrybut nofollow to jedynie jeden z wielu sygnałów. Google nie musi ufać etykietce webmastera. Ma własne modele oceny: prawdopodobieństwo kliknięcia (Reasonable Surfer), rozbieżność między popularnością a zaufaniem (spam detection) i potencjał do granularnego ważenia (linkweight). Zmiana nofollow na „hint” w 2019 roku to formalne przyznanie, że te systemy istnieją i działają.
Co ujawnił wyciek dokumentacji Google API o linkach i ich atrybutach?
W maju 2024 roku do sieci wyciekła wewnętrzna dokumentacja Google Search API, obejmująca tysiące modułów i atrybutów (Rand Fishkin, SparkToro). Wyciek potwierdził kilka istotnych rzeczy o tym, jak Google wewnętrznie klasyfikuje linki.
Po pierwsze, Google operuje trójpoziomowym indeksem linków opartym na danych kliknięć. Linki ze stron bez kliknięć trafiają do indeksu niskiej jakości i są pomijane. Linki ze stron o umiarkowanym ruchu trafiają do indeksu średniej jakości. Tylko linki ze stron z weryfikowalnie wysokim wolumenem kliknięć trafiają do indeksu wysokiej jakości i przekazują pełne sygnały rankingowe. Pole SourceType i metryka TotalClicks decydują o przydziale do odpowiedniego poziomu. To wewnętrzne potwierdzenie tego, co opisaliśmy w artykule o NavBoost i Reasonable Surfer: Google ma wielowarstwowy system oceny linków, który wykracza daleko poza binarny follow/nofollow.
Po drugie, dokumentacja ujawniła moduł IndexingDocjoinerAnchorSpamInfo, dedykowany filtrowi spamu w anchor textach. To nie jest prosty filtr „jest nofollow, więc ignoruj”. To osobny system klasyfikujący anchor texty jako spamowe lub legalne, niezależnie od atrybutu rel. Innymi słowy: nawet jeśli link jest dofollow, jego anchor może zostać sklasyfikowany jako spam i zignorowany. I odwrotnie: link nofollow z naturalnym, kontekstowym anchorem może przekazywać sygnały, bo algorytm uznał go za wiarygodny.
Czy linki nofollow faktycznie przekazują wartość rankingową?
To pytanie dzieli branżę SEO od 2019 roku. Dane są niejednoznaczne, ale wskazują na jedno: nofollow nie jest już synonimem „bezwartościowy”.
Badanie Semrush z 2025 roku na próbie 1000 domen sprawdzało korelację między linkami a widocznością w wyszukiwarkach AI (ChatGPT, Gemini, AI Overviews, Perplexity). Wyniki są zaskakujące. Korelacja Pearsona dla linków nofollow wyniosła 0,340, a dla linków dofollow 0,334. Korelacja Spearmana: nofollow 0,509, dofollow 0,504 (Megrisoft, analiza badania Semrush). Różnice są minimalne i w obu przypadkach linki nofollow wypadły nieznacznie lepiej. ChatGPT i Gemini delikatnie preferowały nofollow, podczas gdy AI Overviews i Perplexity lekko faworyzowały dofollow.
Te dane nie oznaczają, że nofollow jest „lepszy” od dofollow. Oznaczają, że w erze wyszukiwania AI różnica między tymi typami linków zaciera się. Wyjaśnienie jest logiczne: wyszukiwarki AI budują rozumienie na podstawie kontekstu i powiązań semantycznych, nie na podstawie atrybutu rel w kodzie HTML.
Warto spojrzeć na poszczególne case studies. Badanie TekNick wykazało 288% wzrost widoczności z 88 linków nofollow niskiej jakości (Orbit Media Studios). Firma Fractl odnotowała 271% wzrost ruchu organicznego po uzyskaniu jednego linka nofollow z BuzzFeed. SurveyMonkey zaobserwował masowe indeksowanie treści dzięki linkom nofollow. Gary Illyes z Google ujawnił na Pubcon 2019, że ponad połowa wszystkich linków w internecie jest oznaczonych jako nofollow. Gdyby Google całkowicie je ignorował, pozbawiłby się ponad 50% grafu linków, co jest nieakceptowalnym kompromisem dla jakości wyników wyszukiwania.
Jak mało witryn faktycznie używa rel=”sponsored” i rel=”ugc”?
Dane Ahrefs z maja 2020 roku, oparte na analizie 110 000 najlepiej ocenianych witryn, pokazują zdumiewająco niską adopcję nowych atrybutów (Ahrefs, The State of Nofollow, UGC & Sponsored Link Attributes).
Atrybut rel="ugc" pojawia się na zaledwie 0,44% domen odsyłających do witryn z top 110 000. W kontekście wszystkich backlinków to 0,016%. Jeśli chodzi o linki wewnętrzne, 3,1% badanych witryn go używa, ale stanowi on jedynie 0,0002% wszystkich linków wewnętrznych.
Atrybut rel="sponsored" ma jeszcze mniejszy zasięg: 0,01% domen odsyłających i 0,008% wszystkich backlinków. Na linkach wewnętrznych: 0,14% witryn, 0,0016% linków.
Dla porównania: klasyczny nofollow to 10,6% wszystkich backlinków do witryn z top 110 000 i 3,6% linków wewnętrznych na 35,3% badanych witryn.
Te liczby mówią jasno: sześć lat po wprowadzeniu nowych atrybutów, adopcja jest marginalna. Głównym motorem wdrożenia był WordPress, który od wersji 5.3 automatycznie dodaje rel="nofollow ugc" do linków w komentarzach. Poza automatycznym wdrożeniem przez CMS-y, prawie nikt nie implementuje sponsored i ugc ręcznie. To tworzy paradoks: Google wprowadził bardziej precyzyjny system klasyfikacji linków, ale internet go nie przyjął. Zmusza to algorytmy Google do dalszego polegania na własnych systemach klasyfikacji, takich jak graf zaufania i SpamBrain, zamiast na deklaracjach webmasterów.
Czy Google może sam rozpoznać link sponsorowany bez atrybutu rel?
Tak, i ma do tego zarówno patenty, jak i systemy produkcyjne. Patent US 7,533,092 „Link-based spam detection” (Berkhin, Gyongyi, Pedersen; 2005/2009; Google Patents) opisuje porównywanie PageRanku i TrustRanku danej strony. Strona ze sztucznie zawyżonym PageRankiem (bo linki przychodzące pochodzą z podejrzanych źródeł) zostaje zidentyfikowana automatycznie, bez względu na to, czy linki mają atrybut nofollow czy nie.
Google ma też inne narzędzia. Patent US 7,783,639 „Determining quality of linked documents” (Krishna Bharat, Amit Singhal, Paul Haahr; zgłoszony 30 czerwca 2004, przyznany 24 sierpnia 2010; Google Patents) opisuje system wykrywania afiliacji między stronami. Gdy wiele linków przychodzi od tego samego autora lub z powiązanych witryn (ten sam hosting, podobne adresy IP, wspólna struktura linków), system konsoliduje je jako jeden sygnał, zmniejszając ich łączną wagę. Zasada jest prosta: 10 linków z 10 stron tego samego właściciela to nie 10 głosów, to jeden głos z echem.
W praktyce oznacza to, że brak atrybutu sponsored na linku płatnym nie daje przewagi. Jeśli profil tematyczny linkujących witryn nie pasuje do linkowanej strony, jeśli linki pojawiają się w schematach sugerujących transakcje (nagły wzrost z niepowiązanych domen, identyczne anchory, linki w stopkach wielu witryn), algorytm klasyfikuje je jako podejrzane, z atrybutem sponsored czy bez niego.
Jak nofollow wpływa na crawling i odkrywanie treści?
Przed marcem 2020 roku nofollow był dyrektywą także dla crawlera. Jeśli link miał nofollow, Googlebot go nie odwiedzał. To miało poważne konsekwencje: jeśli jedynym linkiem do danej strony był link nofollow, strona mogła nigdy nie zostać zaindeksowana.
Od 1 marca 2020 roku Google traktuje nofollow jako wskazówkę także dla crawlingu. Googlebot może podążyć za linkiem nofollow, jeśli uzna to za użyteczne. To nie znaczy, że zawsze to robi. To znaczy, że ma swobodę decyzji. Google oficjalnie potwierdził: „For crawling and indexing purposes, nofollow will become a hint as of March 1, 2020″ (Google Search Central Blog).
Dla link builderów ta zmiana ma praktyczne konsekwencje. Link nofollow na wysoko autorytetowej stronie (Wikipedia, Reddit, GitHub) nie tylko może przekazywać jakąś wartość rankingową: może w ogóle być przyczyną odkrycia i zaindeksowania strony docelowej. John Mueller z Google jasno stwierdził: „definitely use rel=sponsored for affiliate links, if you can” i dodał, że „making sure the links use rel=nofollow / rel=sponsored would still allow sites to get visibility” (Rise at Seven, Everything John Mueller said about links in 2020). To nie jest zachęta do ignorowania linków nofollow. Wręcz przeciwnie: Mueller potwierdza, że linki z tymi atrybutami nadal umożliwiają widoczność.
Jak powinien wyglądać profil linków w erze trzech atrybutów?
Odpowiedź na to pytanie zależy od tego, czy myślisz jak webmaster (który oznacza linki wychodzące) czy jak SEO (który buduje profil linków przychodzących). Obie perspektywy są istotne.
Perspektywa webmastera: Poprawne oznaczanie linków wychodzących to dziś kwestia higieny, nie optymalizacji. Jeśli publikujesz link sponsorowany bez atrybutu rel=”sponsored”, Google może to sam wykryć, co potencjalnie budzi większe podejrzenia niż jawne oznaczenie. Zasada jest prosta: linki, za które zapłaciłeś, oznacz jako sponsored. Linki w komentarzach i treściach użytkowników: ugc. Linki, którym nie ufasz, ale nie pasują do powyższych kategorii: nofollow. Linki redakcyjne do wartościowych źródeł: bez atrybutu rel.
Perspektywa SEO budującego profil linków: Dane pokazują, że zdrowy profil linków to profil zróżnicowany. Dane Ahrefs wskazują, że 10,6% backlinków do najlepszych witryn to linki nofollow (Ahrefs, SEO Statistics). To nie jest problem do rozwiązania: to naturalny rozkład. Strona, która ma wyłącznie linki dofollow, wygląda podejrzanie, bo w naturalnym ekosystemie internetu zawsze pojawią się linki z komentarzy (nofollow/ugc), wzmianki w mediach społecznościowych (nofollow), odniesienia na forach (nofollow) i linkowania z Wikipedii (nofollow).
Mueller z Google jasno powiedział: „You Don’t Need A Good Distribution Between Followed & Unfollowed Links”. Nie chodzi o optymalny stosunek procentowy. Chodzi o to, żeby linki były w odpowiednich miejscach, w odpowiednim kontekście, z naturalnym anchor contextem. Atrybut rel to detale implementacyjne, nie fundament strategii.
Jakie błędy najczęściej widzimy w audytach profili linków?
Audyty profili linków, które przeprowadzamy w Semgence, regularnie ujawniają te same wzorce błędów związanych z atrybutami rel.
Błąd 1: Masowe nofollowanie linków wewnętrznych. Niektóre witryny nadal stosują nofollow na linkach do stron logowania, regulaminów, polityk prywatności. W 2009 roku to miało sens jako próba sculpting. Dziś to antywzorzec. Google traktuje nofollow jako wskazówkę, więc prawdopodobnie i tak podąża za tymi linkami, ale sygnał o strukturze witryny jest słabszy.
Błąd 2: Brak atrybutu sponsored na linkach płatnych. Google twierdzi, że nie karze za brak sponsored, jeśli link jest nofollow. Ale dodaje: „rel=sponsored is the preferred method”. To subtelna, ale wyraźna wskazówka. Jeśli Google wykryje link płatny bez żadnego atrybutu (co potrafi zrobić: patent US 7,533,092 opisuje porównywanie PageRank/TrustRank), konsekwencje mogą objąć nie tylko link, ale całą domenę linkującą.
Błąd 3: Obsesyjna analiza stosunku dofollow/nofollow. Narzędzia takie jak Ahrefs i Majestic pokazują ten stosunek, więc klienci go analizują. Problem w tym, że nie istnieje „optymalny” stosunek. Profil linków New York Timesa ma inny rozkład niż profil lokalnego sklepu meblowego. Kontekst jest ważniejszy niż proporcje.
Błąd 4: Ignorowanie linków nofollow w strategii. Jeśli jedynym kryterium selekcji witryn do outreachu jest „czy link będzie dofollow”, tracisz możliwości. Link nofollow z Forbesa, Reddita czy branżowego forum przynosi ruch, buduje rozpoznawalność i z danych wynika, że może przekazywać sygnały rankingowe. Strategia oparta wyłącznie na dofollow wygląda nienaturalnie i ogranicza zasięg.
Błąd 5: Nierozróżnianie nofollow na poziomie strony i linku. Meta tag <meta name="robots" content="nofollow"> na poziomie strony i atrybut rel="nofollow" na poziomie pojedynczego linku to dwa różne mechanizmy. Pierwszy mówi „nie podążaj za żadnym linkiem na tej stronie” (choć po zmianach z 2020 to też jest wskazówka). Drugi dotyczy konkretnego linku. Niektóre witryny omyłkowo stosują oba jednocześnie, wprowadzając redundancję, która utrudnia diagnostykę.
Błąd 6: Łączenie wielu atrybutów w niewłaściwej kolejności. Google akceptuje łączenie atrybutów, np. rel="nofollow sponsored" lub rel="nofollow ugc" (tak robi WordPress 5.3+). Ale niektóre CMS-y i wtyczki generują niepoprawne kombinacje jak rel="dofollow" (dofollow nie istnieje jako atrybut HTML; jest to domyślny stan linku) lub duplikują atrybuty. Te błędy są kosmetyczne, ale świadczą o braku zrozumienia mechanizmu, co zwykle oznacza, że cała strategia linkowa wymaga przeglądu.
Co to wszystko oznacza dla przyszłości link buildingu?
Ewolucja od jednego atrybutu do trzech to nie kosmetyczna zmiana. To sygnał, że Google zmierza w kierunku coraz bardziej granularnego rozumienia relacji między stronami. Patent US 7,979,417 pokazywał tę wizję już w 2005 roku z koncepcją linkweight. Reasonable Surfer (patent US 7,716,225) zautomatyzował ważenie linków na podstawie cech wizualnych i behawioralnych. Wyciek API z 2024 roku potwierdził, że kliknięcia użytkowników decydują o tym, do którego indeksu jakości trafia link.
W tym kontekście atrybuty rel (nofollow, sponsored, ugc) to raczej metadane dostarczane przez webmasterów, z których Google korzysta wtedy, gdy uzna to za użyteczne. Nie są one ani obowiązkowe (strona bez żadnego z tych atrybutów nie jest karana), ani gwarancją czegokolwiek (atrybut nofollow nie gwarantuje ignorowania linku). To wskazówki w świecie, w którym algorytm ma własne, niezależne sposoby oceny.
Dla praktyków link buildingu wniosek jest prosty: atrybuty rel to element higieny technicznej, nie element strategii. Strategia powinna opierać się na tym, co patenty i dane mówią o wartości linku: tematyczność linkującej strony, pozycja linku w treści, kontekst tekstu otaczającego link, prawdopodobieństwo kliknięcia i pozycja witryny w grafie zaufania. Atrybut rel to jedna zmienna w równaniu z dziesiątkami zmiennych, i patenty Google konsekwentnie pokazują, że jest to zmienna o malejącym znaczeniu.
Warto też spojrzeć na szerszy trend. Wyciek dokumentacji Google API z 2024 roku ujawnił moduł IndexingDocjoinerAnchorSpamInfo, który klasyfikuje anchor texty niezależnie od atrybutu rel. SpamBrain, system oparty na uczeniu maszynowym, identyfikuje nienaturalne wzorce linkowania bez polegania na deklaracjach webmasterów. To kierunek, który będzie się pogłębiał: im lepsze stają się algorytmy klasyfikacji, tym mniej istotne stają się ręczne etykiety.
Dla agencji SEO i specjalistów link buildingu praktyczna implikacja jest taka: przestańcie myśleć o atrybutach rel jako o najważniejszym czynniku decyzyjnym. Pytanie „czy ten link będzie dofollow?” powinno ustąpić miejsca pytaniom: „Czy ta witryna jest tematycznie powiązana z naszą stroną?”, „Czy link będzie w kontekście redakcyjnym, który naturalnie prowadzi do kliknięcia?”, „Czy docelowa strona jest właściwą stroną do linkowania?” Te pytania prowadzą do linków, które działają, niezależnie od tego, jaki atrybut rel niesie tag <a>.
Jeśli chcesz sprawdzić, jak czytać patenty Google o backlinkach i samodzielnie weryfikować tego typu twierdzenia, zacznij od naszego poradnika metodologicznego. A jeśli Twój profil linków wymaga profesjonalnej oceny z uwzględnieniem wszystkich omawianych sygnałów, dowiedz się, jak ewoluowały czynniki rankingowe, i skontaktuj się z nami.
Najczęściej zadawane pytania
Czy link nofollow może przekazywać wartość rankingową?
Od września 2019 roku Google traktuje nofollow jako wskazówkę (hint), nie dyrektywę. Oznacza to, że algorytm może zdecydować o przekazaniu wartości rankingowej przez link nofollow, jeśli uzna to za zasadne. Badanie Semrush z 2025 roku wykazało, że korelacja linków nofollow z widocznością (Pearson: 0,340) jest praktycznie identyczna jak dofollow (0,334). Case study TekNick odnotował 288% wzrost widoczności z linków nofollow.
Jaka jest różnica między rel=”nofollow”, rel=”sponsored” i rel=”ugc”?
Nofollow to ogólna wskazówka, że link nie powinien być traktowany jako rekomendacja. Sponsored oznacza link będący wynikiem transakcji finansowej (reklamy, płatne recenzje, artykuły sponsorowane). UGC (User Generated Content) identyfikuje linki w treściach tworzonych przez użytkowników, np. komentarzach i postach na forach. Google przyjmuje także kombinacje, np. rel=”nofollow sponsored” lub rel=”nofollow ugc”.
Czy muszę zmieniać stare linki nofollow na sponsored lub ugc?
Nie. Google oficjalnie potwierdził, że istniejące oznaczenia nofollow będą nadal respektowane. Nowe atrybuty sponsored i ugc są opcjonalne i pozwalają na bardziej precyzyjną klasyfikację, ale nie wymagają retroaktywnych zmian. Google zaleca stosowanie nowych atrybutów na nowych linkach, ale nie karze za używanie samego nofollow.
Ile stron faktycznie używa atrybutów sponsored i ugc?
Dane Ahrefs z 2020 roku pokazują marginalną adopcję: rel=”ugc” pojawia się na 0,44% domen odsyłających, a rel=”sponsored” na zaledwie 0,01%. Głównym motorem wdrożenia jest WordPress, który od wersji 5.3 automatycznie dodaje rel=”nofollow ugc” do linków w komentarzach. Poza automatycznym wdrożeniem przez CMS-y, prawie nikt nie implementuje tych atrybutów ręcznie.
Czy Google może wykryć link sponsorowany bez atrybutu rel=”sponsored”?
Tak. Patent US 7,533,092 „Link-based spam detection” opisuje porównywanie PageRanku i TrustRanku strony, co pozwala identyfikować sztucznie zawyżony PageRank. Wyciek dokumentacji Google API z 2024 roku ujawnił moduł IndexingDocjoinerAnchorSpamInfo, który klasyfikuje anchor texty jako spamowe niezależnie od atrybutu rel. Google nie polega wyłącznie na deklaracjach webmasterów.
Jaki powinien być optymalny stosunek linków dofollow do nofollow?
Nie istnieje „optymalny” stosunek. John Mueller z Google jasno stwierdził, że nie trzeba utrzymywać dobrej dystrybucji między linkami followed i unfollowed. Dane Ahrefs wskazują, że 10,6% backlinków do witryn z top 110 000 to linki nofollow, ale to naturalny rozkład, nie cel do osiągnięcia. Ważniejsze od proporcji atrybutów są: tematyczność linkujących witryn, kontekst redakcyjny i pozycja linku w treści.