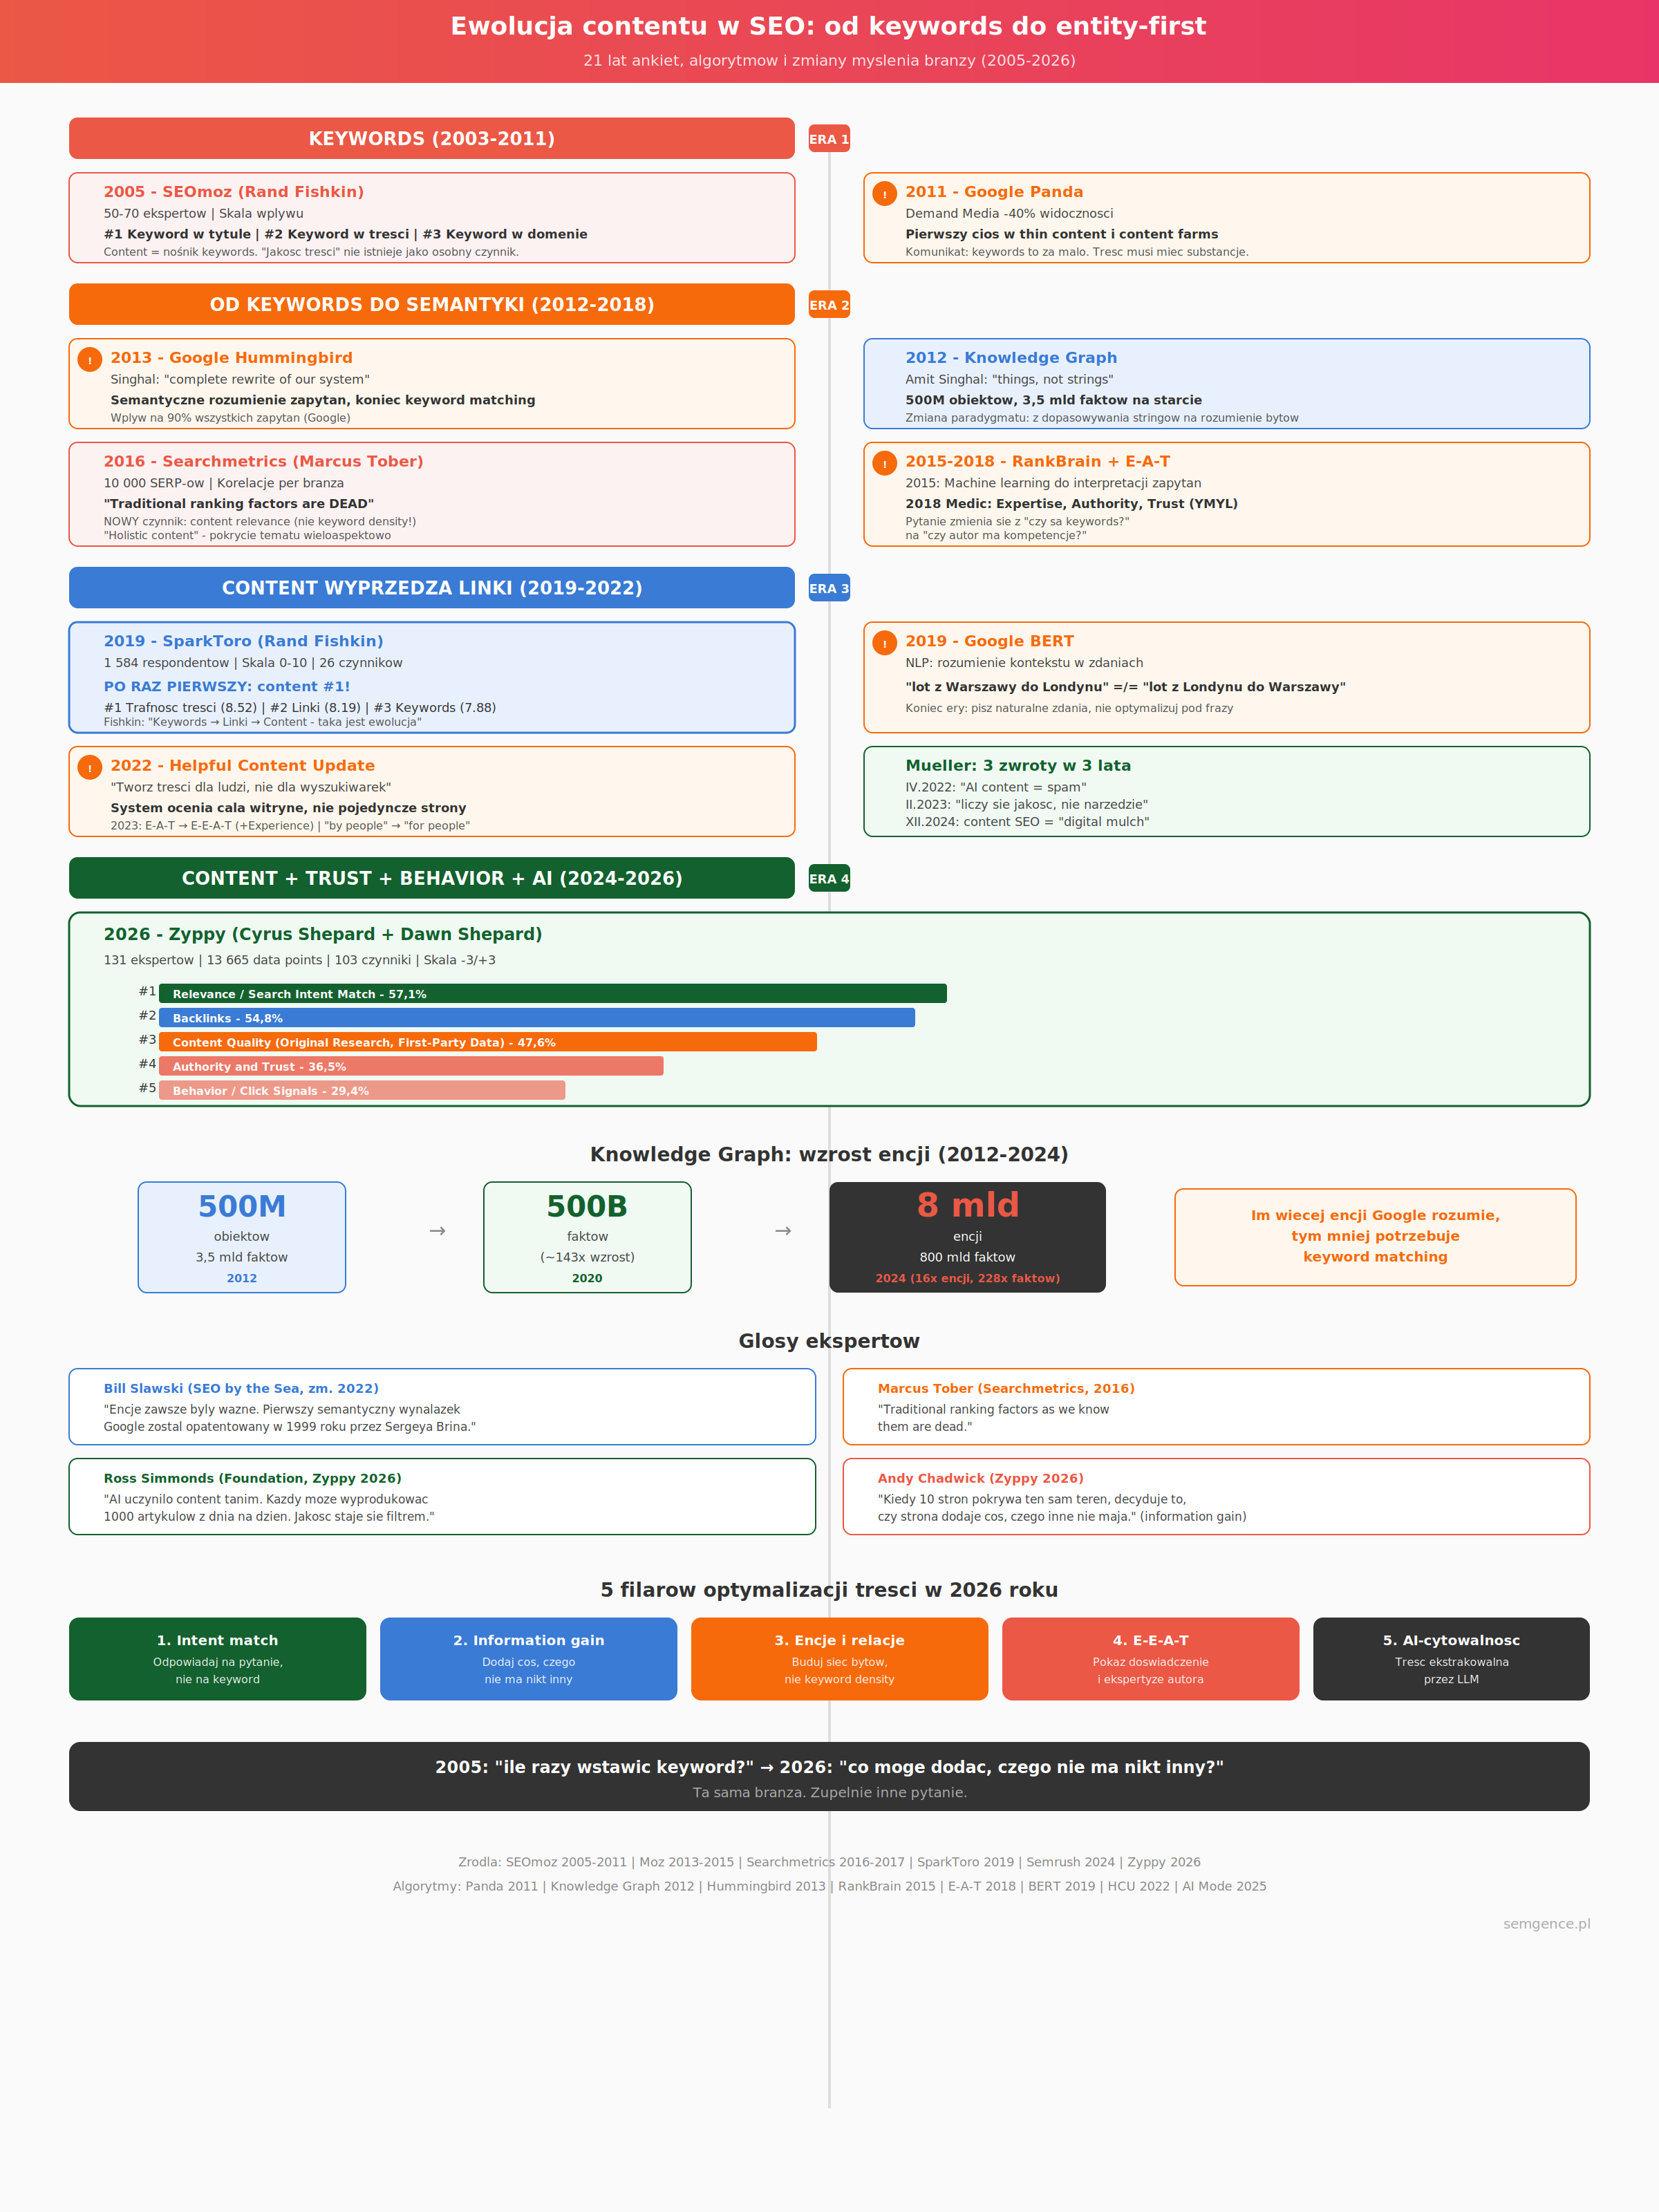
W 2005 roku Rand Fishkin opublikował pierwszą ankietę o czynnikach rankingowych Google. Słowa kluczowe w domenie, tytule i treści strony – to były trzy najważniejsze elementy według 50-70 zaproszonych ekspertów. Dwadzieścia jeden lat później, w ankiecie Zyppy z 2026 roku, te same keyword signals spadły poza pierwszą dziesiątkę. Na ich miejsce weszły: trafność treści wobec intencji użytkownika (57,1% ekspertów wskazało jako top 3), jakość contentu z naciskiem na oryginalne badania i dane first-party (47,6%) oraz – co nowe – information gain, czyli wartość dodana, której nie daje żaden inny wynik w SERP.
Co się stało między 2005 a 2026 rokiem? Jak optymalizacja treści przeszła od keyword stuffingu do entity-first content? W tym artykule łączymy dane z siedmiu ankiet i badań (SEOmoz, Moz, Searchmetrics, SparkToro, Semrush, Zyppy), cytaty ekspertów, które definiowały kolejne ery, oraz kamienie milowe algorytmu Google – od Florida przez Panda i Hummingbird po Helpful Content Update i AI Mode. To nie jest historia technologii. To historia zmiany myślenia całej branży.
Era 1: keywords (2003-2011) – im więcej słów kluczowych, tym lepiej
Żeby zrozumieć, jak daleko zaszliśmy, trzeba pamiętać, skąd startowaliśmy. W pierwszej dekadzie Google optymalizacja treści oznaczała jedno: słowa kluczowe. Im więcej razy fraza docelowa pojawiała się w tytule, nagłówkach, treści, meta description, alt tagach – tym lepiej. Tag <meta name="keywords"> był traktowany poważnie. Keyword density 3-5% uchodziła za optymalną. Exact Match Domains (np. tanie-pozyczki.pl) dawały przewagę, bo słowo kluczowe było w samym adresie URL.
Pierwsza ankieta SEOmoz z 2005 roku dokumentuje ten świat. 50-70 zaproszonych ekspertów oceniało czynniki na skali wpływu. Top 3: keyword w tytule strony, keyword w treści, keyword w domenie. Linki były na drugim miejscu (PageRank), ale sam content był rozumiany wyłącznie przez pryzmat słów kluczowych. Nie było pojęcia „jakość treści” jako oddzielny czynnik – bo jakość była utożsamiana z obecnością właściwych keywords.
System był prosty i łatwy do wykorzystania. Content farms – fabryki treści takie jak eHow, Demand Media czy Associated Content – produkowały tysiące artykułów dziennie, każdy zoptymalizowany pod inne keyword. Treść była cienka, często generowana z szablonów, ale zawierała odpowiednie słowa kluczowe i zbierała linki z katalogów. I to wystarczało.
W ankietach Moz z 2009 i 2011 roku słowa kluczowe nadal dominowały, ale zaczynały pojawiać się nowe kategorie. „Page-Level Social Metrics” weszły do zestawienia (choć potem okazały się korelacją, nie przyczynowością). Ważniejsze było co innego: eksperci zaczęli rozróżniać „keyword w treści” od „jakość i unikalność treści” – to był pierwszy sygnał, że samo wklejenie keywords nie wystarcza.
Panda 2011: pierwszy cios w thin content
24 lutego 2011 Google wypuścił aktualizację Panda – i content farms padły. Demand Media straciło 40% widoczności organicznej. eHow, Suite101, HubPages – strony, które przez lata żyły z produkowania masowej, cienkiej treści pod keywords – zostały zdegradowane. Panda nie pytała „czy ten artykuł zawiera słowo kluczowe?”. Pytała: „czy ten artykuł jest wartościowy dla użytkownika?”.
To był moment, w którym branża SEO po raz pierwszy usłyszała komunikat: keywords to za mało. Treść musi mieć substancję. Ale Panda nadal operowała w paradygmacie content quality vs thin content – nie w paradygmacie encji i semantyki. Do tego przejścia potrzebny był kolejny kamień milowy.
Era 2: od keywords do semantyki (2012-2018) – „things, not strings”
16 maja 2012 roku Amit Singhal – SVP of Engineering w Google – opublikował wpis na oficjalnym blogu Google, który zmienił trajektorię całej branży. Tytuł: „Introducing the Knowledge Graph: things, not strings”. Cztery słowa, które stały się manifestem nowej ery wyszukiwania.
Knowledge Graph wystartował z 500 milionami obiektów i 3,5 miliarda faktów. Zamiast traktować zapytanie „Taj Mahal” jako ciąg znaków do dopasowania z treścią stron, Google zaczął rozumieć, że Taj Mahal to jednocześnie zabytek w Agra, muzyk bluesowy i restauracja – i potrafił rozróżnić, o który byt chodzi użytkownikowi. To nie była optymalizacja wyszukiwarki. To była zmiana paradygmatu: z dopasowywania ciągów znaków na rozumienie rzeczywistości.
Bill Slawski – który na blogu SEO by the Sea analizował patenty Google od 2005 roku aż do swojej śmierci w 2022 – pisał o encjach na długo zanim branża zwróciła na nie uwagę. W wywiadzie dla SchemaApp przyznał: „Przejrzałem swoje wcześniejsze posty i zauważyłem, że słowo 'entities’ pojawiało się w około 20% moich artykułów. To coś, o czym zawsze pisałem.” W innym wywiadzie dla Spectrum Group stwierdził wprost: „Encje zawsze były ważne. Pierwszy semantyczny wynalazek wyszukiwarki Google został opatentowany w 1999 roku przez Sergeya Brina. Rozumiejąc encje, rozumiesz, jak Google patrzy na strony internetowe i interpretuje zawarte w nich informacje.”
Hummingbird 2013: kompletny restart silnika
We wrześniu 2013 Google ogłosił Hummingbird – i Singhal na konferencji SMX opisał go jako „complete rewrite of our system. The last time we did a complete rewrite was shortly after 2000.” To nie była aktualizacja. To był nowy silnik wyszukiwania, zbudowany od podstaw wokół semantycznego rozumienia zapytań.
Przed Hummingbird zapytanie „jaka jest najlepsza kawiarnia blisko mnie” było przetwarzane jako zbiór słów: „najlepsza”, „kawiarnia”, „blisko”, „mnie”. Po Hummingbird Google rozumiał, że to pytanie o lokalizację, preferencje i bliskość – i potrafił odpowiedzieć nawet bez exact match na żadne z tych słów na stronie. Dla twórców treści komunikat był jasny: nie optymalizuj pod słowa. Optymalizuj pod pytania i intencje.
Ankiety Moz z 2013-2015 odzwierciedlają to przejście. W 2013 roku pojawił się nowy czynnik: „Page-Level Keyword Agnostic Features” – cechy strony niezwiązane z konkretnymi keywords. W 2015 „Page-Level Keyword & Content-Based Features” zajęły pozycję #3 (8,19/10), ale sam opis kategorii zmieniał się z „keyword w treści” na „jakość i trafność treści wobec zapytania”. Branża zaczynała rozumieć, że keywords to sygnał, nie cel.
Searchmetrics 2016: „ranking factors are dead”
Marcus Tober – założyciel i CTO Searchmetrics – wyszedł na scenę SearchLove London 2016 z prezentacją zatytułowaną „WHY USER-FOCUSED CONTENT IS THE DEATH OF RANKING FACTORS”. Teza: tradycyjne czynniki rankingowe – w tym optymalizacja pod konkretne keywords – są martwe. Ich miejsce zajmuje coś, co Searchmetrics nazwał „content relevance” i „holistic content”.
Badanie Searchmetrics z 2016 roku – oparte na korelacjach z 10 000 SERP-ów – wprowadzało content relevance jako nowy, odrębny czynnik. Nie keyword density. Nie keyword w H1. Content relevance – czyli jak dobrze tekst pokrywa temat semantycznie, niezależnie od dokładnych fraz kluczowych. Wynik: strony na pozycjach 3-6 miały najwyższy content relevance score. Pozycje 1-2 zajmowały marki, które korzystały z rozpoznawalności i zaufania.
Średnia długość treści w top 10 wynosiła 1633 słów na desktopie i 1222 na mobile. Ale – i to kluczowe zastrzeżenie – Tober mówił wprost: Google nie nagradza długiego tekstu. Nagradza tekst, który pokrywa temat w głębokości i z wielu perspektyw – to, co Searchmetrics nazywało „holistic content”. Długość była efektem ubocznym głębokości, nie celem samym w sobie.
W 2017 roku Searchmetrics poszedł dalej i ogłosił koniec „universal ranking factors” – czynniki rankingowe zależą od branży. Co działa w e-commerce (zdjęcia produktów, structured data, ceny), nie działa w mediach (świeżość, autorstwo, cytowania). Optymalizacja treści przestała być jedną receptą dla wszystkich.
To było ważne przesunięcie konceptualne. Branża SEO przez lata szukała „jednego przepisu na ranking” – idealnej gęstości keywords, optymalnej długości tekstu, właściwej liczby nagłówków. Searchmetrics powiedział: nie ma jednego przepisu. Są branże, zapytania, intencje – i każda kombinacja wymaga innego podejścia do treści. Artykuł medyczny musi mieć cytowania i autora z kwalifikacjami (E-A-T). Opis produktu musi mieć specyfikację i cenę (structured data). Artykuł newsowy musi być świeży (freshness signals). Uniwersalny „content pod SEO” nie istnieje – istnieje content dopasowany do kontekstu.
RankBrain 2015 i E-A-T 2018: machine learning i zaufanie
Dwa kamienie milowe zamknęły erę przejściową. RankBrain (październik 2015) wprowadził machine learning do interpretacji zapytań – Google przestał potrzebować ręcznych reguł do rozumienia nowych, nigdy wcześniej niewpisywanych queries. A Medic Update z sierpnia 2018 zdefiniował E-A-T (Expertise, Authoritativeness, Trustworthiness) jako framework oceny treści YMYL (Your Money, Your Life) – zdrowia, finansów, bezpieczeństwa.
E-A-T zmienił pytanie z „czy ta treść zawiera właściwe słowa?” na „czy autor tej treści ma kompetencje, żeby o tym pisać?”. Strona z poradami medycznymi pisana przez copywritera bez wykształcenia medycznego traciła widoczność – nawet jeśli technicznie była zoptymalizowana pod keywords. Treść przestała być nośnikiem słów kluczowych. Stała się dowodem ekspertyzy.
Era 3: content wyprzedza linki (2019-2022) – przełom SparkToro
W 2019 roku Rand Fishkin – po odejściu z Moz i założeniu SparkToro – opublikował ankietę o czynnikach rankingowych, która po raz pierwszy w historii tych badań dała content pozycję #1. 1584 respondentów (największa próba w historii ankiet SEO), skala 0-10, 26 czynników.
Wyniki: trafność treści wobec zapytania (Relevance/Quality of Overall Content) – 8,52/10, pozycja #1. Po raz pierwszy od 2005 roku content wyprzedził linki. Jakość linkujących stron – 8,19/10, pozycja #2. Słowa kluczowe uznawane za kluczowe – 7,88/10, pozycja #3. E-A-T domen – 7,78/10, pozycja #4.
Fishkin sam podsumował zmianę: „We wczesnych latach keywords dominowały. Potem przez dekadę linki przejęły prowadzenie. A teraz relevance i jakość treści przejęły prowadzenie.” Jedna obserwacja w trzech zdaniach podsumowała 14 lat ewolucji.
BERT 2019: Google zaczyna czytać zdania
Miesiąc po ankiecie SparkToro Google wypuścił BERT (Bidirectional Encoder Representations from Transformers) – model NLP, który zmienił sposób, w jaki Google rozumie język naturalny. Przed BERT Google interpretował słowa osobno. Po BERT – rozumiał kontekst w zdaniu. Różnica między „lot z Warszawy do Londynu” a „lot z Londynu do Warszawy” – która technicznie zawiera te same słowa – stała się czytelna dla algorytmu.
Dla twórców treści BERT oznaczał jedno: pisz naturalne zdania, nie optymalizuj pod frazy. Google potrafi zrozumieć, o czym piszesz, nawet jeśli nie użyjesz dokładnie tej frazy, na którą chcesz rankować. To był koniec ery „keyword w pierwszym akapicie, keyword w H2, keyword w podsumowaniu”. W 2021 roku Google dodał MUM (Multitask Unified Model) – model multimodalny zdolny do rozumienia informacji w wielu językach i formatach jednocześnie. Początek ery: napisz najlepszą odpowiedź na pytanie użytkownika, a Google sam zrozumie, na jakie zapytania ta odpowiedź pasuje.
Helpful Content Update 2022: ludzie, nie algorytm
W sierpniu 2022 Google wypuścił Helpful Content Update z komunikatem, który branża cytuje do dziś: twórz treści dla ludzi, nie dla wyszukiwarek. System oceniał nie pojedyncze strony, ale całą witrynę – jeśli duża część treści na stronie była „unhelpful” (stworzona wyłącznie po to, żeby rankować), cały serwis mógł stracić widoczność.
John Mueller – Google Search Advocate – definiował quality content szerzej, niż branża się spodziewała. W Google Hangout z 2021 roku powiedział: „Kiedy mówimy o jakości treści, nie mamy na myśli tylko tekstu artykułów. To jakość całej strony – layout, design, sposób prezentacji, integracja obrazów, szybkość – wszystkie te czynniki wchodzą w grę.” A w grudniu 2024 roku Mueller poparł krytykę treści SEO jako „digital mulch” – cyfrowej ściółki, produkowanej masowo, bez wartości, wyłącznie pod algorytm.
W 2023 roku Google zaktualizował Quality Rater Guidelines: „Content written by people” zmieniło się na „content created for people”. Zmiana jednego słowa – z „by” na „for” – odzwierciedlała akceptację narzędzi AI w procesie tworzenia treści, o ile wynik jest wartościowy dla użytkownika. E-A-T stał się E-E-A-T – dodano Experience (doświadczenie), podkreślając, że treść oparta na bezpośrednim doświadczeniu autora jest cenniejsza niż kompilacja cudzych źródeł.
Era 4: content + trust + behavior + AI (2024-2026)
Ankieta Zyppy z września 2026 – autorstwa Cyrus i Dawn Shepard, 131 ekspertów, 13 665 punktów danych, 103 czynniki – rysuje obraz systemu, który jest fundamentalnie inny niż ten z 2005 roku. Nie dlatego, że keywords nie mają znaczenia (mają – ale jako sygnał intentu, nie jako czynnik sam w sobie). Ale dlatego, że Google mierzy dziesięć wymiarów tam, gdzie kiedyś mierzył dwa.
Relevance: nie keyword match, a intent match
Czynnik #1 w ankiecie Zyppy (57,1% ekspertów wskazało jako top 3): Search Intent Match – „jak dobrze strona spełnia typ wyniku lub zadanie, które użytkownik wydaje się chcieć”. Nie „czy strona zawiera keyword”. Nie „czy keyword jest w tytule”. Ale: czy strona daje użytkownikowi to, czego szuka?
Melissa Popp (RicketyRoo) ujęła to w ankiecie Zyppy: „Możesz mieć technicznie doskonały content z nieskazitelnymi nagłówkami i piękną strukturą URL, ale jeśli użytkownik szukał jednego, a ty odpowiedziałeś na co innego – nic cię nie uratuje.”
Content Quality: original research i information gain
Czynnik #3 w ankiecie Zyppy (47,6%): Content Quality – ale nie w rozumieniu „poprawny, długi tekst”. W rozumieniu: oryginalne badania, dane first-party, unique insights. Na szczycie listy czynników content quality znalazły się „Original Research” i „First-Party Data” – treści, których nie da się wygenerować AI, bo wymagają własnych danych, eksperymentów, doświadczeń.
Andy Chadwick w ankiecie Zyppy dodał kluczową obserwację: „Dorzuciłbym information gain. Kiedy dziesięć stron dopasowuje intent i pokrywa ten sam teren, decyduje to, czy strona dodaje coś, czego inne nie mają.” Information gain – wartość dodana, unikalny wkład – to nowy wyznacznik jakości treści. Nie „czy pokryłeś temat”, ale „czy dodałeś coś, czego nie ma nikt inny”.
Ross Simmonds (Foundation) podsumował nową rzeczywistość: „AI uczyniło content tanim. Każdy może wyprodukować tysiąc artykułów z dnia na dzień. I Google to wie. Dlatego jakość staje się filtrem. Kiedy wolumen treści eksploduje, koszt publikacji spada do zera – ale koszt zaufania rośnie.”
A Everett Sizemore sformułował praktyczną regułę: „Używanie AI do publikowania dziesięciokrotnie większej ilości treści tej samej jakości w połowie czasu nie jest tak dobre jak używanie AI do publikowania tej samej ilości treści, ale dziesięciokrotnie lepszej jakości.”
Nowe kategorie: brand signals i user satisfaction
Ankieta Zyppy ujawniła dwie kategorie, których ankiety sprzed 2019 roku nie wyodrębniały. Brand Signals (#6, 27%) – czy ludzie szukają Twojej marki z nazwy, czy Ci ufają, czy Cię odwiedzają. I User Satisfaction (#7, 19,8%) – czy użytkownik realizuje swoje zadanie na Twojej stronie, czy wraca do SERP niezadowolony.
Roger Montti (Martinibuster.com) stwierdził w ankiecie: „Branded Search to nowy link – od 2012 roku, jeśli wierzyć pewnemu patentowi Google.” Dan Petrovic (Dejan) poszedł dalej: „To konkurs popularności. Kiedy Google uznaje Cię za trafnego na zapytanie, nie nagradza treści 10x lepszej. Treść zbyt ekspercka może nawet szkodzić widoczności. Musisz trafić w sweet spot, gdzie przemawiasz do jak najszerszego grona.”
AJ Kohn (Infinite Visibility) dodał perspektywę techniczną: „NavBoost to wciąż potwór. Strony powinny budować metrykę satysfakcji (często per typ strony), żeby emulować satysfakcję. Bo jest ranking ceiling, kiedy sygnały kliknięć są gorsze niż u konkurentów w SERP.”
Od keywords do encji: mechanizm przejścia
Ankiety dokumentują zmianę percepcji branży. Ale co stoi za tą zmianą od strony technologicznej? Trzy przejścia, każde budujące na poprzednim.
Przejście 1: od strings do meanings (2012-2013). Knowledge Graph + Hummingbird. Google przestał dopasowywać ciągi znaków i zaczął rozumieć pojęcia. „Pompa ciepła” przestała być dwoma słowami – stała się encją (urządzenie, kategoria produktu, element systemu grzewczego) z atrybutami (moc, COP, typ: powietrze-woda vs gruntowa) i relacjami (producent, instalator, alternatywa: kocioł gazowy).
Przejście 2: od meanings do intents (2015-2019). RankBrain + BERT. Google zaczął rozumieć nie tylko CO użytkownik wpisuje, ale DLACZEGO. „Pompa ciepła” może oznaczać „chcę kupić”, „chcę zrozumieć zasadę działania”, „chcę porównać z kotłem gazowym” lub „szukam instalatora w mojej okolicy”. Każdy z tych intentów wymaga innego typu treści – i Google nauczył się to rozróżniać.
Przejście 3: od intents do information gain (2022-2026). HCU + AI Mode. Kiedy dziesięć stron dopasowuje intent identycznie, Google potrzebuje nowego wyróżnika. Information gain – wartość, której nie daje żaden inny wynik – staje się kluczowy. Oryginalne dane, first-party research, unikalne perspektywy, case studies z własnymi liczbami. Gianluca Fiorelli (ankieta Zyppy) dodał istotne zastrzeżenie: „Za dużo konsensusu i jesteś niewidoczny, bo nie wnosisz nic nowego. Za dużo information gain i jesteś shadowbannowany za bycie zbyt kontrowersyjnym.” Balance jest trudny – ale to ten balance definiuje treść, która wygrywa w 2026 roku.
Knowledge Graph: od 500 milionów do 8 miliardów encji
Skala transformacji jest widoczna w liczbach. Knowledge Graph wystartował w maju 2012 z 500 milionami obiektów i 3,5 miliarda faktów. Do 2020 roku rozrósł się do ponad 500 miliardów faktów. Do 2024 roku – według danych NiuMatrix – obejmował 8 miliardów encji i 800 miliardów faktów. Szesnastokrotny wzrost liczby encji w 12 lat.
Te liczby warto zestawić z danymi z ankiet. W 2005 roku (SEOmoz) keywords w treści były top 3. W 2012 (Knowledge Graph launch) Google miał 500M encji. W 2015 (Moz) keywords spadły na pozycję 3. W 2019 (SparkToro) content wyprzedził linki. W 2024 Google miał 8B encji – 16x więcej niż na starcie. Korelacja nie jest przypadkowa: im więcej encji Google rozumie, tym mniej potrzebuje keyword matching, żeby ocenić treść. Każdy skok w Knowledge Graph osłabiał wartość tradycyjnej optymalizacji pod keywords.
Dla twórców treści te liczby mają konkretne implikacje. Kiedy Google ma 8 miliardów encji, nie potrzebuje keyword matching, żeby zrozumieć, o czym jest strona. Patrzy na encje, które pojawiają się w treści, na relacje między nimi, na atrybuty tych encji. Strona o pompach ciepła, która wymienia konkretne modele (encje: produkty), producenta (encja: firma), parametry techniczne (atrybuty: COP, moc, typ) i porównuje z alternatywami (relacje: pompa ciepła vs kocioł gazowy) – jest czytelna dla Knowledge Graph na poziomie semantycznym. Strona, która powtarza frazę „najlepsza pompa ciepła” 15 razy – nie jest.
Bill Slawski – którego metodologię analizy patentów opisaliśmy w artykule o czytaniu patentów Google – rozumiał to wcześniej niż większość branży. Jego analiza patentów Google o rozpoznawaniu encji, budowaniu grafu wiedzy i semantycznym indeksowaniu treści wyprzedzała rynek o 5-10 lat. Kiedy branża w 2016 roku zaczęła mówić o „holistic content”, Slawski pisał o encjach od dekady. Kiedy w 2022 roku branża odkryła „entity SEO”, Slawski miał za sobą 1000+ postów o tym, jak Google rozumie świat przez pryzmat bytów i relacji.
Co Mueller zmienił, czego branża nie zauważyła
John Mueller w ciągu kilku lat wykonał trzy zwroty, które odzwierciedlają ewolucję podejścia Google do treści.
Kwiecień 2022: Mueller w wywiadzie na YouTube stwierdził, że treści generowane przez AI to spam. Komunikat był jasny: AI content = naruszenie Webmaster Guidelines.
Luty 2023: Google opublikował nowe wytyczne. Kompletny zwrot: „Google rewards high-quality content, however it is produced.” Nie liczy się, kto (lub co) napisał treść. Liczy się, czy jest wartościowa. Mueller sam odszedł od kategorycznego stanowiska z 2022 roku.
Sierpień 2024: Mueller stwierdził: „nobody at Google counts links or words in blog posts.” A w grudniu 2024 poparł artykuł nazywający treści SEO „digital mulch” – cyfrową ściółką.
Ten trzypunktowy łuk – od „AI = spam” przez „liczy się jakość, nie narzędzie” do „content SEO = ściółka” – odzwierciedla szerszą zmianę. Google nie walczy z narzędziami. Walczy z brakiem wartości. AI, które produkuje wartościową treść, jest OK. Człowiek, który produkuje szablonowy content pod keywords, nie jest OK. Narzędzie jest nieistotne. Wartość – kluczowa.
Ta zmiana ma konkretne konsekwencje dla branży SEO. Przez lata „content marketing” w polskim SEO oznaczał: zamów 10 artykułów po 3000 słów, każdy pod inny keyword, opublikuj na blogu, zlinkuj do money page. Ten model zakładał, że wartość treści = obecność keyword + długość + link. Mueller explicite powiedział, że Google nie liczy słów w artykułach. Searchmetrics w 2016 wykazał, że Google nagradza głębokość, nie długość. Zyppy w 2026 stawia Original Research na szczycie – a tego nie da się zamówić w fabryce contentu po 50 zł za tysiąc znaków.
Polski rynek SEO jest tu w tyle za anglosaskim. Według naszych obserwacji w Semgence – prowadzonych od 2006 roku – większość polskich agencji SEO w 2026 nadal operuje w modelu „content pod keyword”. Artykuły blogowe pisane z briefu „keyword: X, H2: Y, długość: 3000 słów” – bez danych, bez doświadczenia autora, bez information gain. To jest dokładnie ten „digital mulch”, o którym mówi Mueller. I dokładnie ten model, który każda kolejna aktualizacja Google degraduje.
Jak wygląda optymalizacja treści w 2026 roku
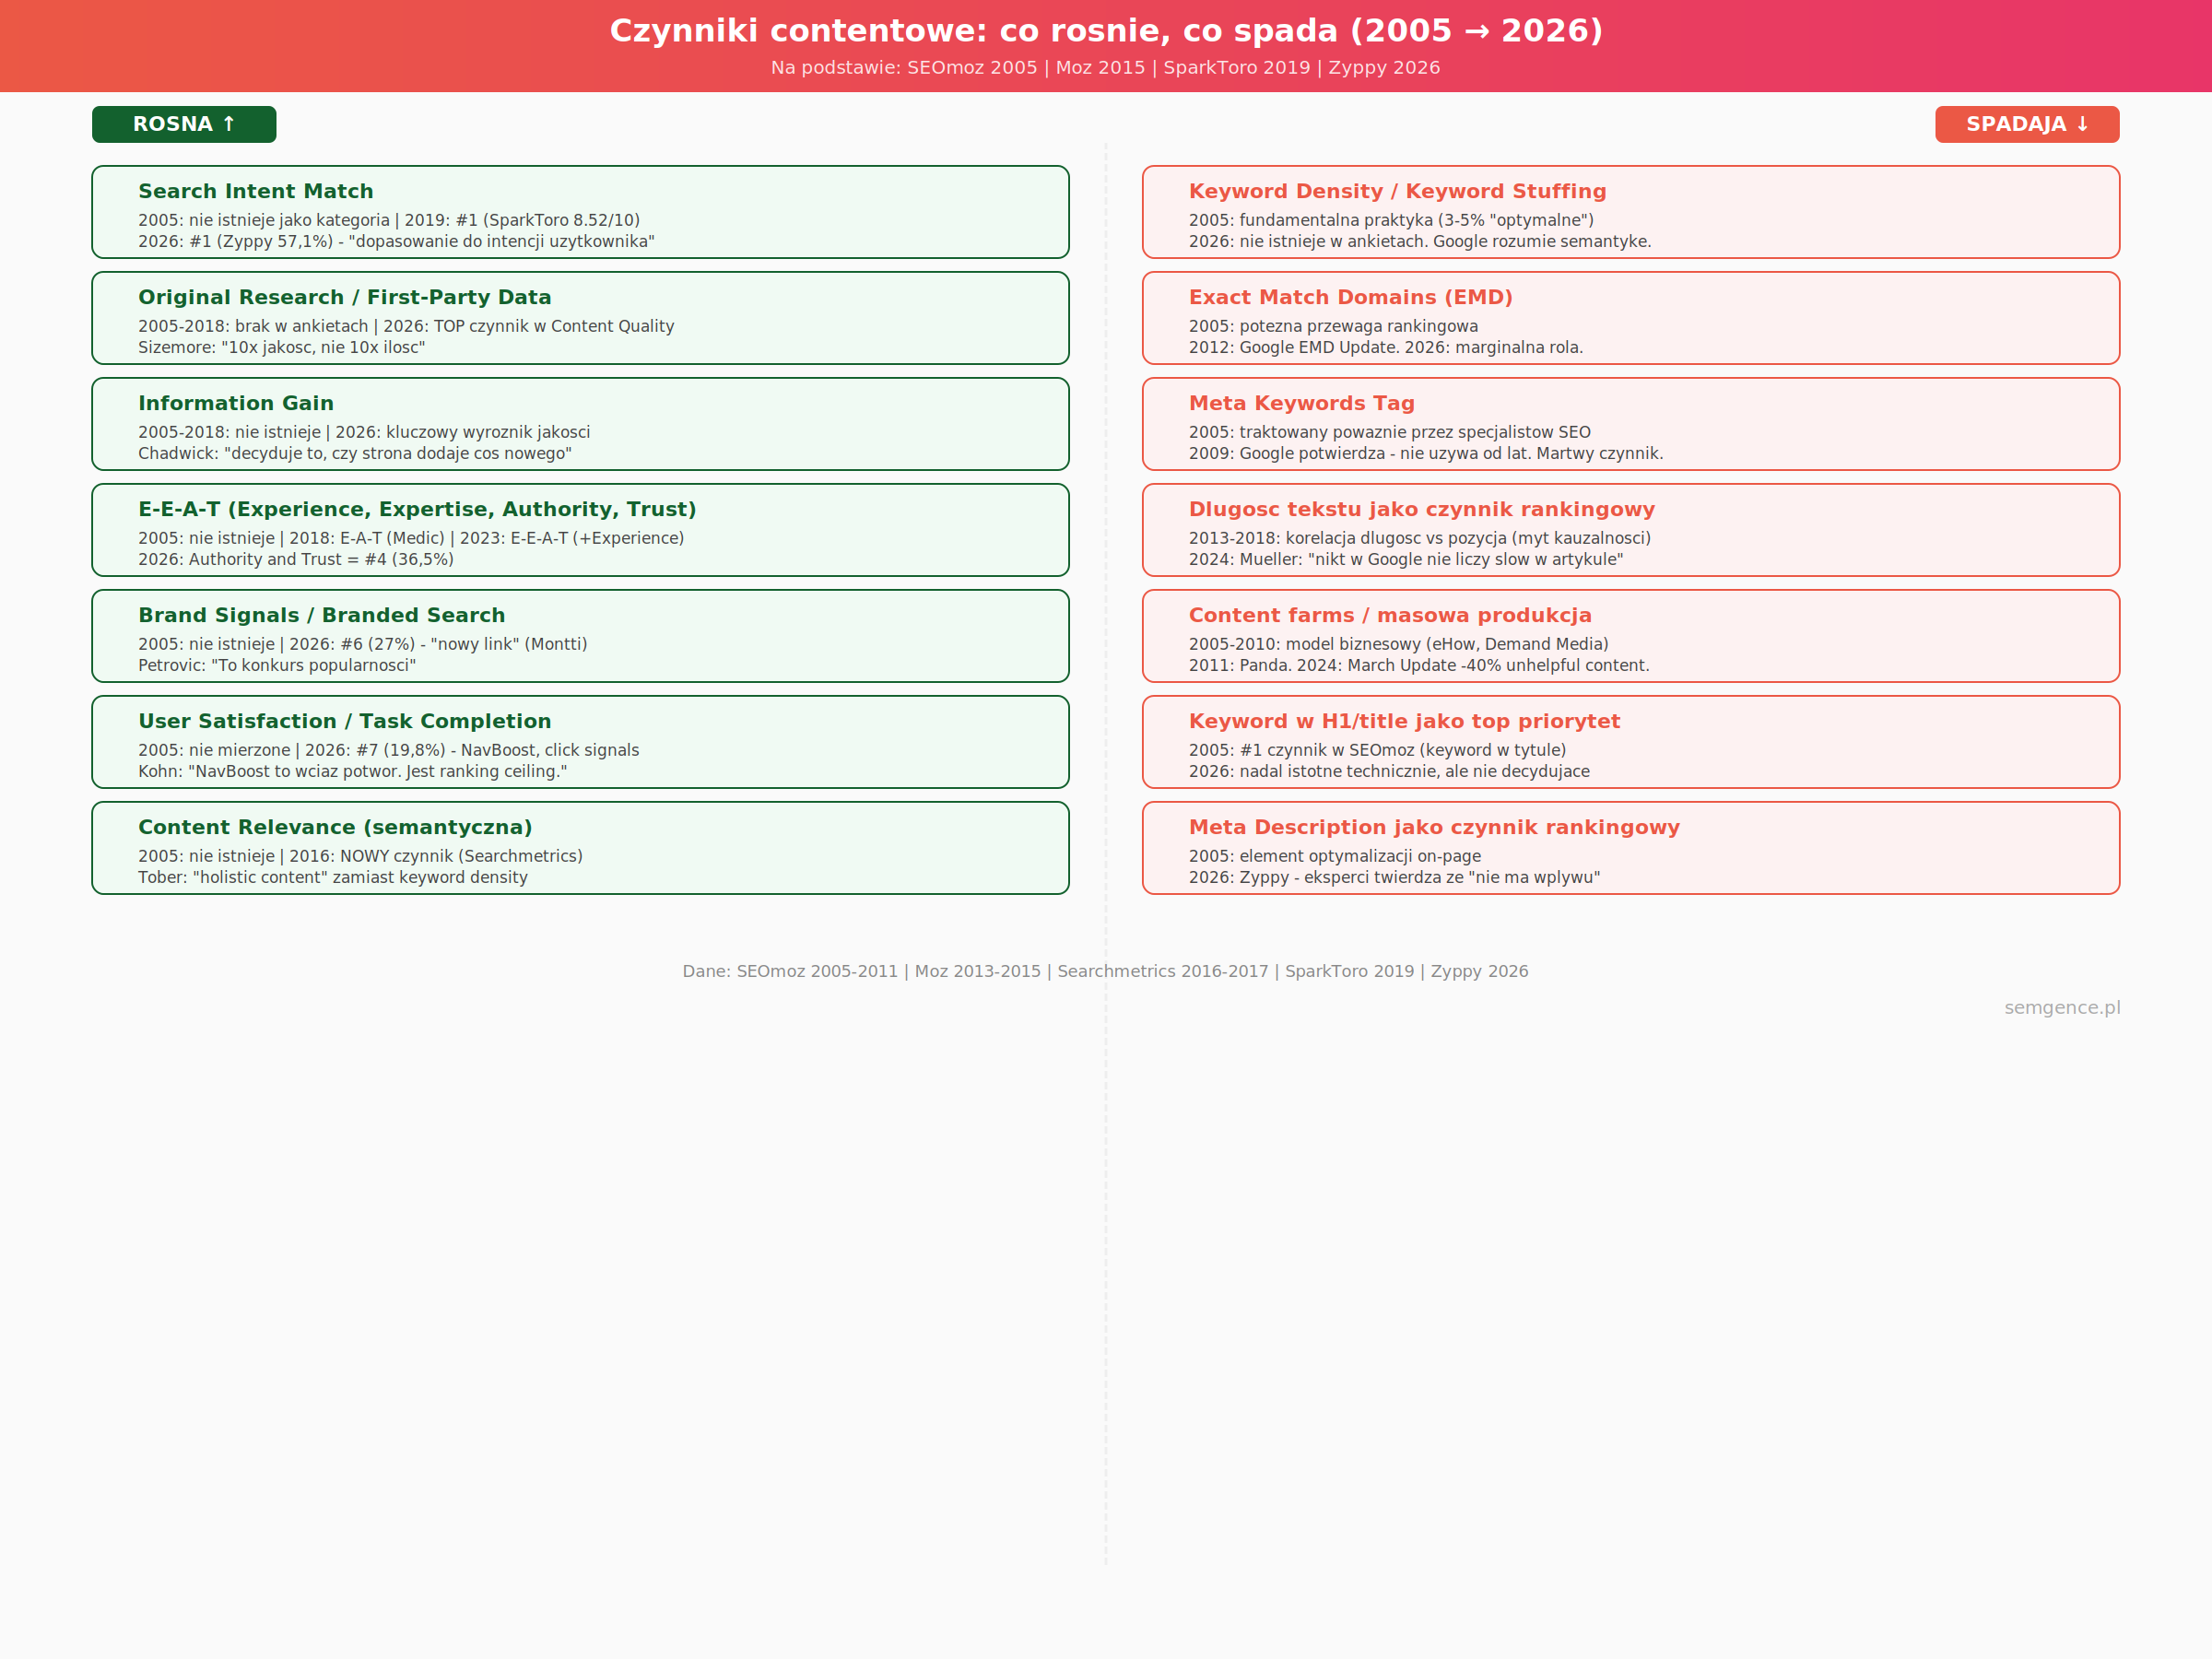
Na podstawie danych z ankiet, cytatów ekspertów i ewolucji algorytmu, optymalizacja treści w 2026 roku opiera się na pięciu filarach – żaden z nich nie istniał jako osobna kategoria w ankietach z 2005 roku.
Intent match, nie keyword match. Treść odpowiada na pytanie, które użytkownik faktycznie ma – nie na frazę, którą wpisał. „Jak wybrać pompę ciepła” wymaga poradnika z kryteriami wyboru, nie opisu produktu z keyword „pompa ciepła” powtórzonym 20 razy.
Information gain, nie information coverage. Nie wystarczy pokryć temat. Trzeba dodać coś, czego nie ma nikt inny: własne dane, case study, oryginalną analizę, perspektywę z doświadczenia. Jak pisaliśmy w artykule o czynnikach rankingowych: Zyppy 2026 stawia Original Research i First-Party Data na szczycie content quality.
Encje i relacje, nie keywords i density. Treść buduje sieć encji: ludzie, produkty, firmy, koncepty, lokalizacje. Każda encja ma atrybuty i relacje z innymi encjami. Google mapuje tę sieć na Knowledge Graph – im bardziej spójna i bogata, tym lepiej Google rozumie treść. Jak pisaliśmy w artykule o tematyczności backlinków, Google operuje na topic embeddings – wielowymiarowych reprezentacjach wektorowych tematów.
E-E-A-T jako fundament, nie dekoracja. Ekspertyza, doświadczenie, autorytet i zaufanie nie są oddzielnymi czynnikami do „dodania”. To framework, przez który Google ocenia całą treść. Autor z doświadczeniem w branży, strona z historią publikacji, treść z konkretnymi danymi – to sygnały E-E-A-T, które nie wynikają z optymalizacji, ale z kompetencji.
Treść dla ludzi, cytowalna przez AI. W erze AI Mode, AI Overviews i ChatGPT Search treść musi być nie tylko dobra dla użytkownika – musi być łatwa do wyekstrahowania i cytowania przez systemy AI. Structured data, jasna hierarchia nagłówków, concrete claims z danymi, answer-first structure. Treść, która jest świetna dla ludzi, ale niemożliwa do wyekstrahowania przez LLM, traci drugi kanał dystrybucji.
Czego nie wiemy
Ankiety mierzą percepcję ekspertów, nie konfigurację algorytmu Google. Korelacje (Searchmetrics, Semrush) nie dowodzą przyczynowości. Nie wiemy, jaką wagę Google przypisuje information gain vs intent match vs E-E-A-T. Nie wiemy, jak dokładnie HCU ocenia „helpfulness” treści. Nie wiemy, czy Knowledge Graph z 8 miliardami encji jest kompletny czy ma luki w polskich branżach niszowych.
Wiemy natomiast, że:
- 7 ankiet i badań z 21 lat konsekwentnie pokazuje shift od keywords do content quality do intent match + information gain
- Każdy kamień milowy algorytmu (Panda → Hummingbird → BERT → HCU) przesuwał wagę z keywords na semantykę i wartość
- Knowledge Graph wyrósł 16-krotnie w encjach (500M → 8B) i 228-krotnie w faktach (3,5B → 800B)
- Eksperci w 2026 (Zyppy) stawiają Original Research i First-Party Data na szczycie content quality – sygnały, których AI nie wygeneruje z cudzych danych
- Mueller sam przeszedł od „AI = spam” (2022) do „liczy się wartość, nie narzędzie” (2023) do „content SEO = ściółka” (2024)
Wniosek: content ewoluował, ale dokąd?
W 2005 roku optymalizacja treści oznaczała: wstaw keyword. W 2015: napisz długi, pokrywający temat tekst. W 2020: dopasuj intent i pokaż ekspertyzę. W 2026: dodaj wartość, której nikt inny nie ma, zbuduj sieć encji, pokaż doświadczenie – i upewnij się, że AI potrafi wyekstrahować Twoją odpowiedź.
Każda kolejna era nie eliminowała poprzedniej – budowała na niej. Keywords nadal mają znaczenie (jako sygnał intentu). Długość nadal koreluje z rankingami. Domain Rating nadal jest używany jako metryka – choć mierzy linki, nie content (bo głębokość wymaga słów). Linki nadal są #2 (choć 66,5% z nich umiera w ciągu dekady) (jak pokazaliśmy w artykule o czynnikach rankingowych). Ale sam content przeszedł od nośnika keywords do dowodu wartości.
Fishkin powiedział to w 2019: najpierw keywords, potem linki, potem content. Dane z 2026 dodają: content, ale nie byle jaki. Content z information gain, z first-party data, z doświadczeniem autora, z encjami powiązanymi w sieć semantyczną, cytowalny przez AI. To nie jest ewolucja liniowa. To spirala: każdy obrót dodaje kolejny wymiar złożoności.
A branża, która w 2005 roku pytała „ile razy wstawić keyword?”, w 2026 pyta „co mogę dodać, czego nie ma nikt inny?”. To ta sama branża. Ale zupełnie inne pytanie.
Najczęściej zadawane pytania
Czy keywords nadal mają znaczenie w SEO w 2026 roku?
Tak, ale jako sygnał intencji użytkownika, nie jako czynnik sam w sobie. W ankiecie Zyppy 2026 Search Intent Match jest czynnikiem #1 (57,1%), ale nie chodzi o obecność keyword w treści – chodzi o dopasowanie treści do tego, czego użytkownik szuka. Google rozumie synonimy, kontekst i encje – nie potrzebuje exact match keyword, żeby zrozumieć temat strony.
Co to jest information gain i dlaczego jest ważny?
Information gain to wartość dodana treści – coś, czego nie daje żaden inny wynik w SERP. W ankiecie Zyppy 2026 Original Research i First-Party Data są na szczycie content quality. Andy Chadwick ujął to tak: kiedy dziesięć stron pokrywa ten sam temat, decyduje to, czy strona dodaje coś nowego. Własne dane, case studies, oryginalne analizy – to information gain.
Kiedy content wyprzedził linki jako najważniejszy czynnik rankingowy?
W ankiecie SparkToro z 2019 roku (1584 respondentów). Po raz pierwszy w historii badań czynników rankingowych (od 2005) trafność i jakość treści (8,52/10) wyprzedziła jakość linków (8,19/10). W ankiecie Zyppy 2026 ten trend się utrzymuje: Relevance #1, Backlinks #2, Content Quality #3.
Co to znaczy 'things not strings’ w kontekście SEO?
Fraza Amita Singhala z Google (maj 2012) opisująca przejście od dopasowywania ciągów znaków (strings) do rozumienia bytów rzeczywistych (things/entities). Knowledge Graph – baza wiedzy Google z 8 miliardami encji – pozwala Google rozumieć, że 'Taj Mahal’ to jednocześnie zabytek, muzyk i restauracja, bez potrzeby keyword match.
Czy treści generowane przez AI szkodzą widoczności w Google?
Nie automatycznie. W 2022 John Mueller nazywał AI content spamem, ale w lutym 2023 Google zmienił stanowisko: 'Google rewards high-quality content, however it is produced.’ Liczy się wartość treści, nie narzędzie. AI content skalowany masowo bez wartości dodanej jest traktowany negatywnie. AI content z human review, oryginalnymi danymi i ekspertyzą – nie.
Jak Bill Slawski wpłynął na rozumienie content SEO?
Bill Slawski (zm. 2022) przez 17 lat na blogu SEO by the Sea analizował patenty Google i pisał o encjach, semantyce i grafie wiedzy – na lata przed tym, zanim branża SEO zwróciła na to uwagę. Sam przyznał, że słowo 'entities’ pojawiało się w 20% jego postów od 2005 roku. Jego analizy patentów wyprzedzały rynkowe trendy o 5-10 lat.