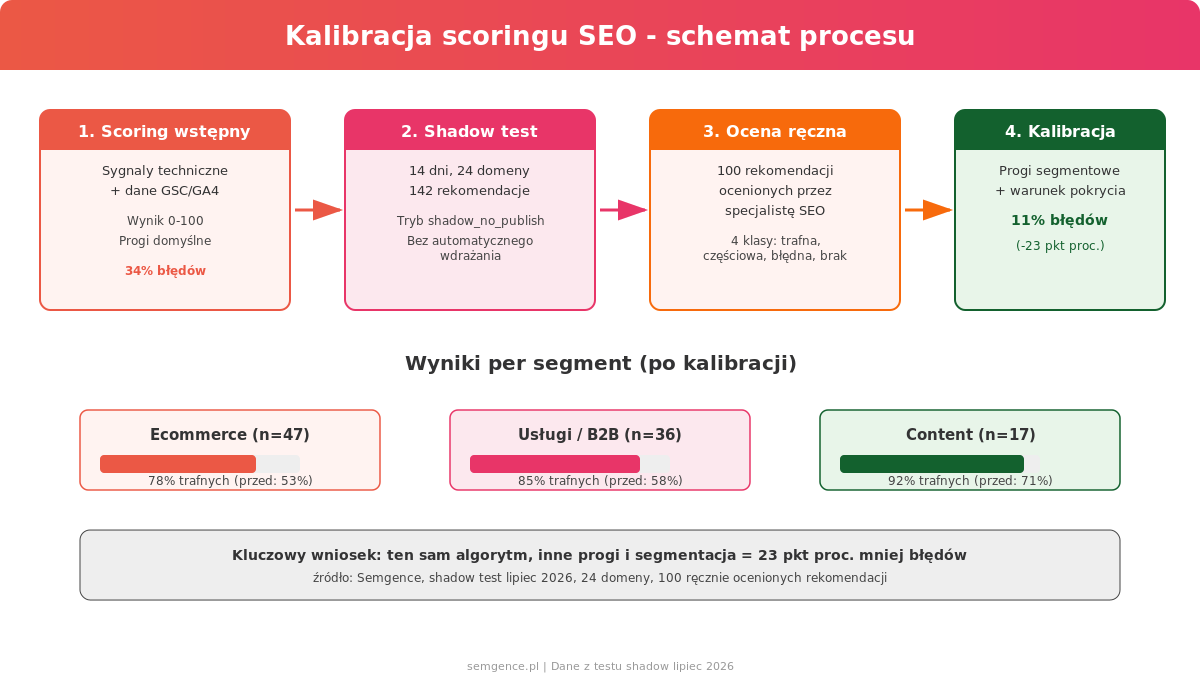
Audyt mówi 78 na 100. Czy to dobrze? Zależy od tego, jak powstał próg, ile domen go testowało i czy ktokolwiek sprawdził, jak często wynik 78 prowadzi do trafnej rekomendacji (porównaj z testem pytań z treści vs GSC). Przez 14 dni uruchamialiśmy shadow scoring na 24 domenach – ecommerce (w tym domeny objęte pozycjonowaniem sklepu internetowego), usługi, content – i ręcznie oceniliśmy 142 rekomendacje (o pełnym workflow weryfikacji piszemy w artykule o human-in-the-loop fact-checkingu). Wynik: bez kalibracji system dawał 34% błędnych lub niepełnych sugestii – co oznacza, że co trzecia rekomendacja dotycząca optymalizacji SEO była nietrafna. Po kalibracji na danych wielodomenowych odsetek spadł do 11%. Różnica nie wynikała z lepszego algorytmu, lecz z dopasowania progów do rzeczywistości.
Parametry badania
| Parametr | Wartość |
|---|---|
| Liczba domen | 24 (kohorta stabilna) |
| Okres testu | 14 kolejnych dni (lipiec 2026) |
| Typy serwisow | ecommerce (8), usługi/B2B (9), content/publisher (7) |
| Liczba rekomendacji | 142 (100 ocenionych ręcznie w pelnym cyklu) |
| Klasy oceny | trafna, częściowo trafna, błędna, brak danych |
| Tryb | shadow_no_publish – żadna rekomendacja nie została wdrożona automatycznie |
| Narzędzia audytowe | retrieval_domain_benchmark, retrieval_benchmark_scorecard, retrieval_global_tuning_gate (GSCGA MCP) |
Czym różni się scoring od kalibracji?
Scoring to przypisanie wartości numerycznej – na przykład 0 do 100 – na podstawie zbioru sygnałów. Kalibracja to coś więcej: sprawdzenie, czy wynik 80 faktycznie oznacza lepszy stan niż wynik 60 i czy próg oddzielający „dobrze” od „zle” działa jednakowo dla sklepu z 500 produktami i bloga z 30 artykułami.
W praktyce większość narzędzi SEO dostarcza scoring bez kalibracji. Progi są ustalone przez twórców na podstawie intuicji, kilku projektów testowych albo ogólnych benchmarków branzy. Problem pojawia się, gdy te progi stosuje się globalnie: wynik 75 dla dużego sklepu z zaawansowaną architekturą może być świetny, a ten sam wynik 75 dla prostego bloga może maskować powazne braki.
Kalibracja wymaga trzech rzeczy: reprezentatywnej próbki domen, ręcznej oceny rekomendacji przez człowieka i porównania oceny ludzkiej z wynikiem systemu. Dopiero wtedy wiadomo, jak często system się myli i w która stronę.
Co patent o przewidywaniu jakości faktycznie opisuje?
Patent US8442984B1 („Website quality signal generation”, Google, 2008/2013) opisuje metodę generowania sygnałów jakości stron internetowych. System wybiera grupe sygnałów – na przykład liczbę postów na blogu, wskaźnik subskrypcji czy częstotliwość aktualizacji (sygnały, które nabierają znaczenia w kontekście entity SEO) – i tworzy wstępny wynik jakości. Następnie stratyfikowana próbka stron (podzielona na grupy niskiej, średniej i wysokiej jakości) trafia do oceny przez ludzkich raterów. Na podstawie ocen raterów i sygnałów system trenuje model uczenia maszynowego (SVM), który następnie przypisuje wyniki jakości stronom nieocenionym przez ludzi.
Kluczowy mechanizm to pętla kalibracyjna: wynik automatyczny jest porównywany z ocena człowieka, a model jest korygowany na podstawie rozbieżności. Patent nie mówi, które sygnały są najważniejsze – mówi, ze sam proces łączenia sygnałów z ocena ludzka jest sednem generowania wiarygodnego wyniku. Warto zauważyć, że ta pętla jest koncepcyjnie zbieżna z ramą E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness) – ocena ludzka w patencie pełni analogiczną rolę do oceny raterów w Quality Rater Guidelines, gdzie E-E-A-T stanowi centralny framework ewaluacji jakości.
Dwa dodatkowe patenty rozszerzają ten koncept na systemy generatywne. Patent EP4713828A1 („Generative digital component creation”, Google, 2023, aplikacja) opisuje system generowania komponentów reklamowych (digital ads) z uwzględnieniem progu zgodności z treścią strony docelowej. Choć patent nie dotyczy bezpośrednio scoringu SEO, ilustruje ten sam wzorzec: automatyczny system generuje treść, a próg jakości decyduje o akceptacji lub odrzuceniu. Patent US20240289395A1 („Method and system for electronic processing of user queries maintaining factual consistency”, Google, 2023, przyznany jako US12204524B1) wprowadza model agregacji ocen wielu raterów: każda odpowiedź LLM jest oceniana przez kilku ludzi, a ich oceny są agregowane w etykietę treningową na podstawie liczby ocen i najniższej oceny. To ten sam wzorzec: ludzka ocena kalibruje automatyczny system, podobnie jak w metodologii consensus score.
| Numer | Tytuł | Właściciel | Status | Data pierwszeństwa | Kluczowy claim | Związek z tematem |
|---|---|---|---|---|---|---|
| US8442984B1 | Website quality signal generation | Google LLC | Granted (aktywny) | 2008-03-31 | Stratyfikowana próbka + raterzy + model SVM kalibrujacy wynik jakości | direct |
| EP4713828A1 | Generative digital component creation | Google LLC | Aplikacja (pending) | 2023-12-29 | Generowanie komponentów reklamowych z progiem zgodności ze źródłem – wzorzec progu jakości | context only |
| US20240289395A1 | Method and system for electronic processing of user queries maintaining factual consistency | Google LLC | Granted (US12204524B1) | 2023-02-28 | Agregacja ocen wielu raterów w etykietę treningową kalibrujaca faktyczność | supporting |
Jak zbudowaliśmy test shadow na wielu domenach?
Test shadow (shadow scoring) polega na uruchomieniu systemu rekomendacji bez automatycznego wdrażania wyników. Każda sugestia jest zapisywana, ale żaden klient nie widzi jej bezpośrednio – dopoki człowiek jej nie zweryfikuje. W naszym przypadku shadow trwal 14 dni na kohorcie 24 domen.
Kohorta została dobrana tak, aby każdy typ serwisu miał wystarczająca reprezentacje: 8 sklepow internetowych (elektronika, moda, dom, sport), 9 serwisow usługowych i B2B (agencje, kancelarie, firmy SaaS, usługi lokalne) oraz 7 serwisow contentowych i publisherskich (blogi branzowe, portale tematyczne). Każda domena miała co najmniej 90 dni danych GSC i aktywna integracje z GA4.
System codziennie generował rekomendacje za pomocą audytu SEO opartego na retrieval_domain_benchmark i retrieval_benchmark_scorecard. Każda rekomendacja otrzymywała wynik od 0 do 100, a progi początkowe były ustawione na: poniżej 40 = krytyczne, 40-70 = do poprawy, powyżej 70 = akceptowalne.
Następnie każda z 142 rekomendacji przeszla ręcznie weryfikacje. Oceniajacy (specjalista SEO z doświadczeniem 5+ lat) przypisał każda rekomendacje do jednej z czterech klas: trafna (rekomendacja poprawna i wdrażalna), częściowo trafna (kierunek poprawny, ale szczegóły wymagają korekty), błędna (rekomendacja niepoprawna lub nieadekwatna do kontekstu domeny), brak danych (system nie miał wystarczających informacji, aby wydac rekomendacje).
Jakie błędy wykryliśmy przed zmianą progów?
Przed kalibracja – z progami ustawionymi „na oko” – system generował 34% błędnych lub niepełnych rekomendacji. Rozkłady błędów różniły się między typami serwisow:
| Typ serwisu | Trafne | Częściowo trafne | Błędne | Brak danych |
|---|---|---|---|---|
| Ecommerce (n=47) | 53% | 19% | 21% | 7% |
| Uslugi/B2B (n=36) | 58% | 17% | 17% | 8% |
| Content/publisher (n=17) | 71% | 12% | 12% | 5% |
| Łącznie (n=100) | 58% | 17% | 18% | 7% |
Najczęstsze błędy w ecommerce dotyczyły rekomendacji opartych na sygnałach istotnych dla blogow (np. długość treści, struktura nagłówków), ale nieadekwatnych dla kart produktowych. System sugerowal wydluzenie opisów produktow do 1500 słów, mimo ze karty produktowe z 300-500 słowami i dobrymi danymi strukturalnymi rankują lepiej w tym segmencie.
W serwisach usługowych problem był odwrotny: system niedoszacowywał znaczenie lokalnąych sygnałów (NAP consistency, Google Business Profile, recenzje) i zawyżał ocenę stron z dobrym contentem, ale słabą widocznościa lokalną.
Klasa „brak danych” była szczególnie istotna. W 7 przypadkach system zwrocil wynik numeryczny (np. 62/100), chociaż dane źródłowe były niekompletne – brak GA4, niepełne dane GSC lub brak danych o crawlowaniu. Wynik 62 wygląda jak informacja, ale de facto jest artefaktem niepełnych danych. To właśnie sytuacja, w której system powinien odpowiedzieć „nie wiem” zamiast generować pozornie precyzyjna liczbe.
Macierz: rekomendacja systemu kontra ocena człowieka
Poniższe zestawienie pokazuje, jak rekomendacje systemu (wiersze) odnosily się do ocen specjalisty (kolumny). Idealny system mialby wartości wyłącznie na przekątnej.
| System / Czlowiek | Trafna | Częściowo trafna | Bledna | Brak danych |
|---|---|---|---|---|
| Krytyczne (wynik <40) | 12 | 3 | 8 | 2 |
| Do poprawy (40-70) | 28 | 11 | 7 | 3 |
| Akceptowalne (>70) | 18 | 3 | 3 | 2 |
Dwa problemy są widoczne natychmiast. Po pierwsze, 8 z 25 rekomendacji oznaczonych jako „krytyczne” było błędnych – system generował fałszywy alarm. Po drugie, 3 rekomendacje oznaczone jako „akceptowalne” były w rzeczywistości błędne – system nie wykryl problemu, który człowiek zidentyfikował. Falszywe alarmy marnują czas zespolu, fałszywe „zielone światło” marnuje szanse na poprawe. W terminologii information retrieval odpowiada to metryce precision@k (jaki odsetek rekomendacji z top-k jest trafny) i NDCG (Normalized Discounted Cumulative Gain), która mierzy, czy trafne rekomendacje pojawiają się wyżej w rankingu niż błędne.
Kiedy wolno stroić scoring globalnie?
Po analizie macierzy błędów zmieniliśmy podejście. Zamiast jednego globalnego progu (np. 70 = OK) wprowadziliśmy progi segmentówe i dodatkowy warunek pokrycia danych.
| Kryterium gate | Wymaganie minimalne |
|---|---|
| Liczba domen w teście | Minimum 20, optymalnie 24+ |
| Okres obserwacji | Minimum 14 dni ciągłych danych |
| Ręczne review | Minimum 100 rekomendacji ocenionych przez specjalistę |
| Segmentacja | Oddzielne progi dla ecommerce, usług/B2B i contentu |
| Pokrycie danych | System musi zgłosić „brak danych” gdy <80% sygnałów jest dostępnych |
| Stabilność | Rekomendacja musi powtórzyć się w co najmniej 3 z 5 kolejnych dni |
| Kontrprzykład | Minimum 1 domena per segment z wynikiem odwrotnym do mediany |
Te kryteria są dostępne jako bramka kalibracyjna w narzędziu retrieval_global_tuning_gate. Narzędzie sprawdza, czy progi zostały przetestowane na wystarczającej próbce, czy segmentacja jest aktywna i czy system prawidłowo raportuje braki danych.
Po kalibracji z nowymi progami odsetek błędnych rekomendacji spadł z 34% do 11%. Główna zmiana nie dotyczyła algorytmu – dotyczyła sposóbu, w jaki interpretujemy jego wyniki. System nie stał się mądrzejszy; dowiedzieliśmy się, kiedy mu ufać, a kiedy nie.
Kiedy system powinien odpowiedzieć „brak danych”?
Jednym z najważniejszych wyników testu shadow było zidentyfikowanie warunków, przy których system nie powinien wydawać rekomendacji:
Brak GA4 lub niepełne dane GSC. Gdy property GA4 nie jest połączona lub dane GSC obejmują mniej niż 30 dni, system nie ma podstaw do oceny zachowania użytkowników po wejściu na stronę. Rekomendacje oparte wyłącznie na crawlingu technicznym mogą być poprawne pod kątem struktury, ale nie uwzględniają tego, czy użytkownicy faktycznie znajdują to, czego szukają.
Domena spoza segmentów referencyjnych. Jeżeli domena nie pasuje do żadnego z trzech segmentów (ecommerce, usługi/B2B, content), progi kalibrowane na tych segmentach nie mają zastosowania. System powinien to zgłosić i zaproponować kalibrację dedykowaną.
Zbyt mała liczba URL-i. Dla domen z mniej niż 20 indeksowanymi URL-ami wiele sygnałów traci stabilność statystyczną. Wynik agregatowy może być zdominowany przez jeden lub dwa URL-e.
Brak danych o konkurencji. Scoring w izolacji – bez kontekstu SERP i bez porównania z konkurentami rankującymi na te same zapytania – generuje wyniki, które wyglądaja dobrze, ale nie mówia nic o szansach na poprawe pozycji.
W naszym teście shadow 7 ze 142 rekomendacji powinno było otrzymać etykietę „brak danych” zamiast wyniku numerycznego. To 4,9% całej próbki. Pozornie niewiele, ale każda z tych 7 rekomendacji mogła prowadzić do błędnej decyzji – na przykład do inwestycji w długie opisy produktow na stronie, która w rzeczywistości potrzebowała poprawy warstwy semantycznej schema.
Stabilność rekomendacji dzień po dniu
Czy rekomendacja wygenerowana w poniedzialek powtarza się we wtorek? Stabilność czasowa jest jednym z najsłabiej testowanych aspektow systemow scoringowych. Narzędzie może dawać różne wyniki tego samego dnia w zależności od momentu pobrania danych GSC, statusu crawlu czy opóźnienia w GA4.
| Miara stabilności | Wartość |
|---|---|
| Rekomendacje stabilne (powtórzone w 4+ z 5 dni) | 68% |
| Rekomendacje częściowo stabilne (2-3 z 5 dni) | 22% |
| Rekomendacje niestabilne (1 z 5 dni lub jednorazowe) | 10% |
10% rekomendacji pojawiało się tylko raz w ciagu 5-dniowego okna. To rekomendacje, które nie powinny trafić do raportu dla klienta – są artefaktem jednorazowej fluktuacji danych, a nie trwalego problemu. Po dodaniu warunku stabilności (minimum 3 z 5 dni) odsetek błędnych rekomendacji w końcowym raporcie spadł dodatkowe 4 punkty procentowe.
Semgence wykorzystuje ten mechanizm w produkcyjnym audycie: rekomendacja musi powtórzyć się w co najmniej trzech kolejnych uruchomieniach, zanim trafi do raportu klienta. To prosta regula, ale eliminuje większość fałszywych alarmow wynikajacych z niestabilności danych źródłowych.
Checklista dla osób budujących własny audyt punktowy
Więcej o wyzwaniach związanych z audytami punktowymi opisujemy w ankiecie o problemach z realizacją audytów SEO. Poniższe pytania powinny miec odpowiedź „tak”, zanim wynik audytu trafi do raportu lub dashboardu:
| Pytanie | Dłączego ma znaczenie |
|---|---|
| Czy progi były testowane na więcej niż 5 domenach? | Próg z jednego projektu nie przenosi się na inne segmenty |
| Czy segmentacja (ecommerce / usługi / content) jest aktywna? | Różne typy serwisow mają różne wzorce sygnałów |
| Czy system raportuje pokrycie danych? | Wynik 72 z 80% sygnałów to inna informacja niż 72 z 40% sygnałów |
| Czy ktos ręcznie sprawdził co najmniej 50 rekomendacji? | Bez benchmarku ludzkiego nie wiadomo, czy system się myli |
| Czy znane są false positive rate i false negative rate (precision i recall)? | Każdy system ma oba rodzaje błędów – pytanie brzmi, ile ich jest. Precision mierzy odsetek trafnych rekomendacji wśród wszystkich wydanych, recall – odsetek wykrytych problemów wśród wszystkich istniejących |
| Czy rekomendacja musi powtórzyć się w kilku uruchomieniach? | Jednorazowe wyniki mogą być artefaktem danych, nie trwalym problemem |
| Czy wynik „brak danych” jest możliwy? | System bez opcji „nie wiem” jest systemem, który zawsze udaje, że wie |
Jeżeli Twoj audyt konczy się jedna liczba, popros także o pokrycie danych, confidence i liste warunków, przy których wynik przestaje być wiarygodny.
Case study: jak kalibracja zmieniła raport dla sklepu z elektroniką
Jeden z projektów w kohorcie – sklep z elektronika uzytkowa, ponad 2000 produktów, 14 kategorii – otrzymał przed kalibracja wynik ogólny 71/100 z etykietą „akceptowalne”. Po kalibracji segmentówej ten sam zestaw danych dal wynik 58/100 z etykietą „do poprawy” w segmencie ecommerce.
Różnica wynikała z trzech czynników. Po pierwsze, ogólny próg 70 nie uwzględniał specyfiki kart produktowych – wystarczająco dobre meta tagi i nagłówki „ciągnęły” wynik w górę, maskujac braki w danych strukturalnych i feedzie. Po drugie, progi dla ecommerce uwzględniały sygnały, które ogólny scoring ignorowal: kompletność feedu produktowego, spójność między karta a schema, oraz obecność recenzji. Po trzecie, kalibracja ujawnila, że 4 z 14 kategorii nie miały żadnych danych GA4 z powodu błędu w implementacji GTM – ogólny scoring nie zgłosił tego jako problemu, scoring skalibrowany oznaczyl te kategorie jako „brak danych”.
Warto podkreślic: żadna z tych różnic nie wymagała zmiany algorytmu. Zmienily się progi, segmentacja i sposób traktowania brakujacych danych. Sam silnik scoringowy pozostał identyczny.
Porównanie między segmentami
Różnice między segmentami są widoczne nie tylko w procentach błędów, ale także w typach błędów. W ecommerce dominuja fałszywe „zielone światła” – system mówi, że jest dobrze, a człowiek widzi braki w schema, feedzie lub spójności cenowej. W serwisach usługowych dominuja fałszywe alarmy – system zgłasza problem z treścia, który w kontekście usługi lokalnej jest nieistotny (np. krótki opis na stronie kontaktu). W contencie błędy są najrzadsze, ale gdy się pojawiają, dotyczą głównie nieaktualności danych – system nie wykrywa, że artykuł z 2024 roku cytuje statystyki z 2022.
Te różnice pokazują, dłączego jeden globalny scoring nie wystarczy. Nie chodzi o to, ze algorytm jest zly. Chodzi o to, że ten sam sygnał może być istotny w jednym kontekście i nieistotny w innym. Kalibracja to narzędzie, które pozwala to rozróżnić.
Zastrzeżenie dotyczące patentów
Patenty przywołane w tym artykule – US8442984B1, EP4713828A1 i US20240289395A1 – opisują problemy techniczne i proponowane sposoby ich rozwiązania. Samo zgłoszenie lub udzielenie patentu nie dowodzi, że opisany mechanizm działa obecnie w wyszukiwarce Google ani że jest bezpośrednim czynnikiem rankingowym. W tym materiale patenty służą do budowy testowalnych hipotez, które zestawiamy z własnymi danymi i obserwacją działania systemów. Patent EP4713828A1 jest przywołany wyłącznie jako ilustracja wzorca progu jakości w systemach generatywnych – nie dotyczy bezpośrednio scoringu SEO.
Patent US8442984B1 jest patentem udzielonym (granted, aktywny do 2030), ale to nie oznacza, że opisany w nim mechanizm SVM jest aktualnie stosowany w niezmienionej formie. Patent EP4713828A1 jest aplikacją (pending). Patent US20240289395A1 został przyznany jako US12204524B1. Ich treść pokazuje kierunek myślenia zespołów inżynieryjnych Google, ale nie stanowi dowodu wdrożenia.
Jakość treści weryfikujemy w audycie treści. Tworzenie treści wspieramy w ramach content marketingu. Indywidualną strategię budujemy w ramach konsultacji SEO.
Ramka metodologiczna. Analiza opiera się na patentach: US8442984B1, US20240289395A1, US12204524B1. Dane z wewnętrznych narzędzi diagnostycznych Semgence oraz publicznie dostępnych API (GSC, GA4). Scoringi są wskaźnikami diagnostycznymi Semgence – nie są wynikami Google ani obietnicą lepszego rankingu. Patenty służą jako kontekst architektury wyszukiwania, nie jako dowód wdrożenia w produkcji. Wyniki z małych prób opisywane są jako obserwacje, nie prawo ogólne.
Czy wynik audytu SEO 78/100 oznacza, że strona jest dobrze zoptymalizowana?
Nie bez kontekstu. Wynik 78 może oznaczac różne rzeczy w zależności od segmentu (ecommerce, usługi, content), pokrycia danych i progów kalibracji. Sklep z wynikiem 78 opartym na 40% dostępnych sygnałów to inna sytuacja niż blog z wynikiem 78 opartym na 95% sygnałów. Zawsze pytaj o pokrycie danych, segmentacje i confidence.
Ile domen potrzeba do kalibracji progów scoringowych?
Minimum 20 domen z co najmniej trzech segmentów (ecommerce, usługi/B2B, content). Przy mniejszej próbce progi będą dostrojone do specyfiki kilku projektów i nie przeniosły się na inne. W naszym teście użyliśmy 24 domen przez 14 dni, co dało 142 rekomendacje do ręcznej oceny.
Co to jest shadow scoring w SEO?
Shadow scoring to tryb pracy systemu rekomendacji, w którym generuje on sugestie bez automatycznego wdrażania. Każda rekomendacja jest zapisywana i oceniana ręcznie przez specjaliste, zanim trafi do raportu. Pozwala to zmierzyc dokładność systemu bez ryzyka wdrożenia błędnych zmian na żywo.