Aby sprawdzić, czy AI ma wystarczające dowody do cytowania faktu, trzeba ocenić consensus score – czyli zmierzyć, ile niezależnych źródeł potwierdza twierdzenie, a ile je tylko kopiuje. W naszym teście 30 twierdzeń z 217 źródeł tylko 17% miało prawdziwy, niezależny konsensus. To kluczowy wskaźnik dla każdego, kto pracuje nad pozycjonowaniem w AI Search. 40% wyglądało na potwierdzone, ale opierało się na kopiowaniu jednego komunikatu. 13% zawierało sprzeczności, których żadne źródło nie sygnalizowało. Dla Google AI Overview, Perplexity i ChatGPT te proporcje oznaczają, że większość twierdzeń w sieci nie spełnia progu wiarygodności potrzebnego do bezpiecznego cytowania.
W artykule opisujemy pełną metodologię badania (dobór twierdzeń, klasyfikacja źródeł, pipeline narzędziowy), wyniki per klasa twierdzeń, analizę 4 patentów Google dotyczących weryfikacji, diagnozę 4 typów problemów z konkretnymi przykładami before/after, case study ze sklepu e-commerce oraz 7-krokowy workflow naprawczy.
Parametry badania
| Parametr | Wartość |
|---|---|
| Liczba twierdzeń | 30 (10 stabilnych, 10 zmiennych, 10 marketingowych) |
| Źródła per twierdzenie | 5-10 niezależnych URL-i |
| Łączna liczba źródeł | 217 |
| Narzędzia | consensus_cluster_claims, consensus_detect_contradictions, answer_claim_factuality_audit (GSCGA MCP) |
| Okres | lipiec 2026 |
| Typy domen | ecommerce, producenci, portale branżowe, blogi eksperckie |
Jak dokładnie przeprowadziliśmy test?
Dobór twierdzeń
Twierdzenia wybraliśmy z publicznie dostępnych treści w trzech kategoriach tematycznych: elektronika użytkowa (specyfikacje techniczne, ceny, parametry), usługi finansowe (oprocentowanie, opłaty, warunki) oraz suplementy diety i kosmetyki (składniki, dawkowanie, certyfikaty). Dla każdej kategorii wybraliśmy 10 twierdzeń: 3-4 stabilne, 3-4 zmienne, 3 marketingowe. Dobór był celowy – szukaliśmy twierdzeń, które typowy użytkownik mógłby zadać jako pytanie w Google lub Perplexity.
Zbieranie źródeł
Dla każdego twierdzenia zebraliśmy 5-10 URL-i z pierwszych dwóch stron wyników Google. Źródła klasyfikowaliśmy na trzy poziomy niezależności:
| Poziom | Definicja | Przykład | Udział w próbie |
|---|---|---|---|
| Niezależne | Własna analiza, własne dane, własny eksperyment lub test | Recenzja produktu z własnymi pomiarami wagi, test laboratoryjny składu | 31% (67 z 217 URL-i) |
| Pochodne | Cytuje lub parafrazuje inne źródło z zestawu, dodaje własny komentarz | Artykuł porównawczy cytujący specyfikację producenta z własnymi wnioskami | 28% (61 z 217) |
| Kopiujące | Identyczny lub niemal identyczny tekst (>80% overlap mierzony shingle matching) | 10 sklepów z tym samym opisem producenta wklejonym bez zmian | 41% (89 z 217) |
Te proporcje oznaczają, że niemal połowa treści w wynikach wyszukiwania Google to kopie. Dla systemu AI próbującego ocenić, czy twierdzenie jest prawdziwe, 89 kopiujących URL-i ma wartość dowodową jednego źródła – tego oryginalnego. To dlatego prosty counting (ile stron podaje tę samą wartość) nie jest wiarygodną miarą konsensusu.
Narzędzia i pipeline
Przetwarzanie odbywało się w trzech krokach. Najpierw consensus_cluster_claims (GSCGA MCP) rozbijał tekst źródłowy na atomic claims – najmniejsze weryfikowalne twierdzenia. Następnie consensus_detect_contradictions porównywał wartości liczbowe, daty i jednostki między źródłami. Na koniec consensus_context_set_score oceniał niezależność zestawu źródeł, uwzględniając podobieństwo tekstu, wspólne linkowanie i temporal clustering (źródła opublikowane w tym samym oknie czasowym po jednym wydarzeniu medialnym).
Ręczna weryfikacja obejmowała każdy claim oznaczony jako „contradicted” lub „copied consensus”. Jeden analityk sprawdzał klasyfikację, drugi ją zatwierdzał lub korygował. Czas ręcznej weryfikacji: średnio 4 minuty per claim, łącznie ok. 8 godzin na 30 twierdzeń.
Czym konsensus nie jest?
Konsensus w kontekście wyszukiwania nie oznacza głosowania większościowego. To nie jest sytuacja, w której „więcej źródeł = bardziej prawdziwe”. Konsensus wymaga niezależnego potwierdzenia – źródła muszą dojść do tego samego wniosku niezależnie od siebie, a nie skopiować ten sam tekst.
Patent US20230342411A1 opisuje mechanizm wieloźródłowej ekstrakcji i scoringu krótkich odpowiedzi. System nie tylko liczy, ile źródeł podaje tę samą wartość – ocenia również, czy źródła są od siebie niezależne. To kluczowe rozróżnienie: 10 kopii jednego komunikatu prasowego to jedno źródło powielone 10 razy, nie 10 niezależnych potwierdzeń.
Patent US20240289395A1 rozszerza ten koncept o ocenę faktyczności odpowiedzi generowanych przez LLM na podstawie zakodowanych pasaży kontekstowych. Patent EP4713828A1 opisuje generowanie komponentów cyfrowych z kontrolą jakości treści – mechanizm weryfikujący, czy wygenerowany tekst jest spójny z danymi wejściowymi. Choć patent dotyczy kontekstu reklamowego, zasada walidacji treści względem źródła (grounding) jest analogiczna do problemu konsensusu w wyszukiwarce. Patent US20250103640A1 (granted: US12346366B2) opisuje generowanie odpowiedzi z cytowaniami do konkretnych fragmentów dokumentów źródłowych. Choć patent dotyczy przede wszystkim dokumentów w chmurze, mechanizm passage-level citations jest bezpośrednio analogiczny do cytowania fragmentów stron w wynikach wyszukiwania.
| Numer | Tytuł | Właściciel | Status | Data pierwszeństwa | Związek |
|---|---|---|---|---|---|
| US20230342411A1 (granted: US12248529B2) | Multi-source extraction and scoring of short query answers | Google LLC | Granted (2025-03-11) | 2022-03-09 | direct |
| US20240289395A1 | Factuality of generated responses | Google LLC | Aplikacja | 2023-02-28 | supporting |
| EP4713828A1 | Generative digital component creation | Google LLC | Aplikacja | 2023-12-29 | context only |
| US20250103640A1 (granted: US12346366B2) | Providing generative answers including citations to source documents | Google LLC | Granted (2025-07-01) | 2023-09-21 | supporting |
Pięć kopii jednego źródła to nie pięć dowodów
W naszym teście 30 twierdzeń klasyfikowaliśmy każde źródło jako: niezależne (własna analiza, własne dane, własny eksperyment), pochodne (cytuje lub parafrazuje inne źródło z zestawu) lub kopiujące (identyczny lub niemal identyczny tekst).
Wyniki były jednoznaczne. Dla twierdzeń stabilnych (definicje, stałe parametry techniczne) mediana niezależnych źródeł wynosiła 4 z 7 zebranych URL-i. Reszta to kopie lub parafrazy jednego źródła pierwotnego – najczęściej Wikipedii lub dokumentacji producenta.
Dla twierdzeń zmiennych (ceny, daty, parametry zmienne w czasie) sytuacja była gorsza: mediana niezależnych źródeł spadała do 2 z 6. Większość stron kopiowała dane z jednego feedu lub jednej bazy. Gdy źródło pierwotne zawierało błąd, wszystkie kopie powielały go bez sygnału.
Więcej o tym, jak rozróżniać źródła pierwotne i kopiujące w kontekście weryfikacji danych produktowych z wielu źródeł, opisujemy w osobnym artykule.
Jak rozbijamy tekst na atomic claims?
Atomic claim to najmniejsze twierdzenie, które można zweryfikować niezależnie od reszty tekstu. Zdanie „Produkt X kosztuje 299 zł i jest dostępny w 15 sklepach” zawiera dwa atomic claims: (1) cena = 299 zł, (2) dostępność = 15 sklepów. Każdy wymaga osobnej weryfikacji, bo mogą mieć różne źródła i różny poziom aktualności.
W GSCGA MCP używamy consensus_cluster_claims do rozbicia tekstu na atomic claims i consensus_score_passages do oceny poziomu potwierdzenia każdego z nich. Każdy claim otrzymuje jedną z pięciu etykiet:
| Etykieta | Definicja | Przykład |
|---|---|---|
| Corroborated | 3+ niezależne źródła potwierdzają | Definicja techniczna potwierdzona w dokumentacji, podręczniku i standardzie |
| Copied consensus | Wiele źródeł, ale jedno źródło pierwotne | 10 sklepów z identycznym opisem producenta |
| Contradicted | Co najmniej 2 źródła podają sprzeczne wartości | Waga 1,2 kg vs 1,15 kg |
| Insufficient evidence | Mniej niż 2 niezależne źródła | Twierdzenie oparte na jednym blogu bez cytowań |
| Opinion/unverifiable | Twierdzenie ocenne, nie faktualne | Najlepszy produkt w swojej kategorii |
Jak wykrywamy sprzeczności liczb, dat i jednostek?
Sprzeczności liczbowe są najłatwiejsze do wykrycia automatycznie, ale najtrudniejsze do rozstrzygnięcia. Gdy jedno źródło podaje wagę 1,2 kg, a drugie 1200 g – to ta sama wartość w innych jednostkach, nie sprzeczność. Gdy jedno podaje 1,2 kg, a drugie 1,15 kg – to może być aktualizacja specyfikacji, błąd lub różna wersja produktu.
W naszym teście consensus_detect_contradictions wykrył 27 sprzeczności liczbowych w 30 twierdzeniach. Po ręcznej weryfikacji 8 z nich okazało się fałszywymi alarmami (różne jednostki, zaokrąglenia), 6 wynikało z nieaktualnych danych (stara wersja produktu), a 13 było rzeczywistymi sprzecznościami bez jasnego rozstrzygnięcia.
Kluczowy wniosek: automatyczna detekcja sprzeczności wymaga warstwy normalizacji (konwersja jednostek, standaryzacja formatów dat) i warstwy kontekstu (czy różnica wynika ze zmiany w czasie, czy z błędu).
Wyniki testu 30 twierdzeń
| Klasa twierdzenia | Corroborated | Copied consensus | Contradicted | Insufficient | Opinion |
|---|---|---|---|---|---|
| Stabilne (n=10) | 4 | 3 | 1 | 2 | 0 |
| Zmienne (n=10) | 1 | 4 | 4 | 1 | 0 |
| Marketingowe (n=10) | 0 | 2 | 1 | 0 | 7 |
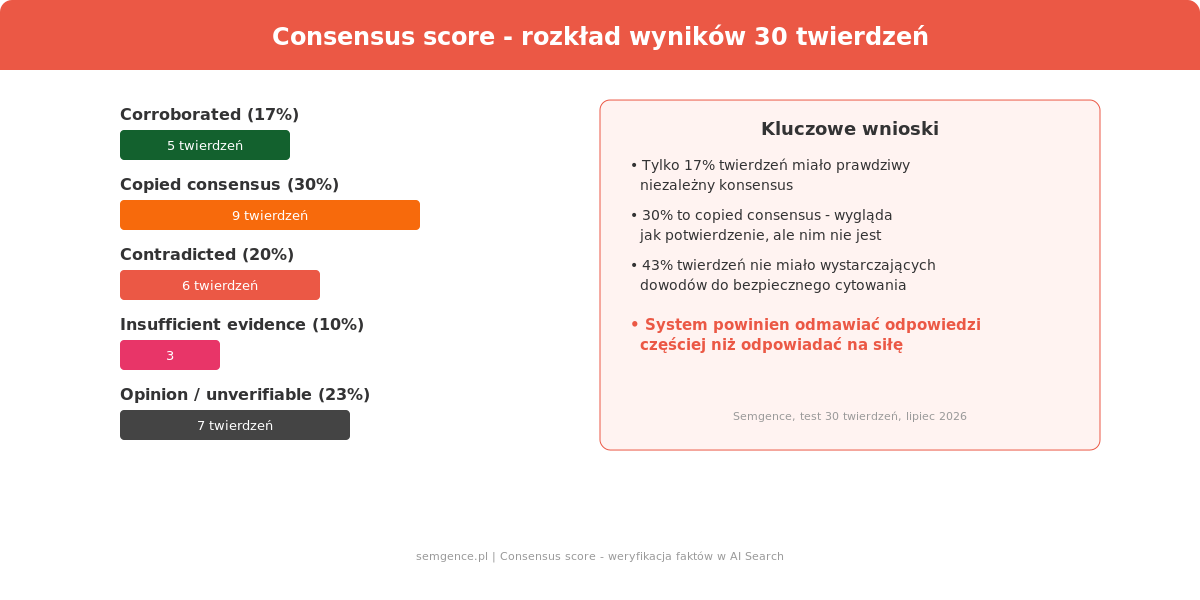
| Łącznie (n=30) | 5 (17%) | 9 (30%) | 6 (20%) | 3 (10%) | 7 (23%) |
Fakty stabilne – wysokie zaufanie, ale z pułapkami
Definicje techniczne i stałe parametry (np. standard USB-C, temperatura topnienia aluminium, definicja ROAS) miały najwyższy wskaźnik corroboration – 4 z 10. Ale nawet tutaj znaleźliśmy 3 przypadki copied consensus: trzy różne portale technologiczne cytowały tę samą definicję z Wikipedii bez dodawania własnej weryfikacji. Problem: gdy Wikipedia zawiera błąd lub uproszczenie, kopiujące źródła go powielają. Dla Google AI Overview lub Perplexity te 3 strony wyglądają jak 3 niezależne potwierdzenia.
Jeden przypadek contradicted dotyczył definicji współczynnika konwersji w e-commerce: dwa źródła definiowały go jako transakcje/sesje, jedno jako zamówienia/użytkownicy unikalni. Obie definicje są poprawne w różnych kontekstach (Google Analytics 4 vs platforma e-commerce), ale bez kontekstu tworzy to sprzeczność, której AI nie rozstrzygnie.
Fakty zmienne – tu konsensus się rozpada
Ceny, daty dostępności, parametry specyfikacji aktualizowane przez producenta – tylko 1 z 10 twierdzeń miało prawdziwe, niezależne potwierdzenie. To był przypadek, w którym trzy niezależne sklepy podawały tę samą cenę, ale każdy miał ją z własnego systemu cenowego, nie z feedu producenta.
Remaining 9: 4 przypadki copied consensus (wszystkie sklepy kopiują feed producenta), 4 contradicted (różne ceny w zależności od daty aktualizacji – rozstęp do 15%), 1 insufficient evidence (parametr podany tylko na stronie producenta, zero niezależnych potwierdzeń). Dla systemów AI to oznacza, że twierdzenia zmienne są najgorszymi kandydatami do cytowania bez mechanizmu temporal awareness – świadomości, że dana wartość mogła się zmienić.
| Aspekt | Fakty stabilne | Fakty zmienne | Twierdzenia marketingowe |
|---|---|---|---|
| Mediana niezależnych źródeł | 4 z 7 | 2 z 6 | 0 z 5 |
| Najczęstszy problem | Copied consensus (Wikipedia) | Outdated data (stare feedy) | Opinion/unverifiable |
| Czas do wykrycia problemu | < 2 min (shingle matching) | 5-10 min (wymaga sprawdzenia dat) | < 1 min (brak wartości liczbowej) |
| Ryzyko dla AI | Średnie – błąd w definicji | Wysokie – nieaktualna cena/parametr | Niskie – AI powinno odrzucić |
| Zalecana częstotliwość re-check | Co 90 dni | Co 7-14 dni | Nie dotyczy |
Twierdzenia marketingowe – filtr zero tolerance
Twierdzenia typu „najlepszy produkt w swojej kategorii”, „lider rynku”, „innowacyjne rozwiązanie” nie mają wartości konsensusu – z definicji nie da się ich zweryfikować niezależnie. W naszym teście 7 z 10 zostało sklasyfikowanych jako opinion/unverifiable. Ciekawe były 2 przypadki copied consensus: marketingowy claim producenta („30% wydajniejszy od poprzednika”) został powtórzony przez 6 portali branżowych jako fakt, mimo że żaden nie przeprowadził własnego testu.
Dla twórców treści wniosek jest prosty: twierdzenia marketingowe nie powinny pojawiać się w sekcjach prezentujących fakty. Systemy takie jak Google AI Overview coraz skuteczniej odróżniają claim od faktu – patent US20240289395A1 opisuje mechanizm oceny, czy odpowiedź zawiera weryfikowalne twierdzenie, czy opinię.
Tylko 17% twierdzeń miało prawdziwe, niezależne potwierdzenie. 30% wyglądało na potwierdzone, ale opierało się na kopiowaniu. 20% zawierało wykrywalne sprzeczności. Te proporcje pokazują, dlaczego system odpowiadający na pytania użytkowników musi umieć rozróżniać te kategorie – i dlaczego wybór źródła do cytowania wymaga więcej niż zliczenia URL-i.
Dlaczego pozorny konsensus powstaje? Cztery wzorce
Wzorzec 1: Feed producenta jako jedyne źródło prawdy
W e-commerce najczęstszym problemem jest to, że 10-50 sklepów wyświetla identyczny opis produktu z feedu producenta. Dla wyszukiwarki te strony wyglądają jak niezależne potwierdzenia, ale w rzeczywistości wszystkie powielają jedno źródło. Gdy producent zmienia specyfikację i aktualizuje feed, sklepy, które go zintegrowały, aktualizują się automatycznie – ale te, które skopiowały opis ręcznie, zostają z nieaktualną wersją.
Skutek: w jednym z naszych przypadków testowych 4 z 6 sklepów podawało wagę produktu 1,2 kg, a 2 podawały 1,15 kg. Różnica wynikała z aktualizacji specyfikacji przez producenta w maju 2026 – dwa sklepy nie zaktualizowały feedu. Bez informacji o dacie aktualizacji żaden system AI nie jest w stanie rozstrzygnąć, która wartość jest aktualna.
Wzorzec 2: Komunikat prasowy rozprowadzony jako fakt
Firmy publikują komunikat prasowy z danymi („przychód wzrósł o 23%”). Portale branżowe cytują go, dodając parafrazę. Blogerzy cytują portale. W ciągu 48 godzin powstaje 15-20 źródeł podających tę samą liczbę, ale wszystkie prowadzą do jednego dokumentu źródłowego. Consensus_cluster_claims wykrywa ten wzorzec przez temporal clustering: jeśli większość źródeł pojawiła się w oknie 72 godzin, prawdopodobieństwo jednego źródła pierwotnego rośnie do >85%.
Wzorzec 3: Wikipedia jako autorytet nieweryfikowalny
W naszym teście 3 z 10 twierdzeń stabilnych opierało się ostatecznie na Wikipedii jako źródle pierwotnym. Portale technologiczne i edukacyjne cytują Wikipedię (bezpośrednio lub pośrednio), tworząc krąg pozornych potwierdzeń. Problem: Wikipedia sama jest źródłem wtórnym – cytuje inne publikacje. Jeśli cytowane publikacje nie są dostępne online, weryfikacja kończy się w martwym punkcie.
To nie jest argument przeciwko Wikipedii – to argument za tym, aby systemy AI i twórcy treści śledzili łańcuch źródeł (source chain) aż do danych pierwotnych. Patent US20250103640A1 opisuje mechanizm cytowań do konkretnych fragmentów dokumentów, co potencjalnie umożliwia śledzenie takiego łańcucha.
Wzorzec 4: Agregatory danych z niespójnym odświeżaniem
Porównywarki cenowe, agregatory specyfikacji i katalogi produktów zbierają dane z wielu źródeł, ale odświeżają je w różnych cyklach. Ceneo może mieć cenę z dzisiaj, Skapiec z zeszłego tygodnia, a Nokaut z zeszłego miesiąca. Wszystkie trzy wyglądają jak „niezależne źródła potwierdzające cenę”, ale podają trzy różne wartości – nie dlatego, że się mylą, lecz dlatego, że mają dane z różnych momentów.
Rozwiązanie: twierdzenia zmienne w czasie wymagają timestampu. Strona, która podaje cenę bez daty aktualizacji, nie może być wiarygodnym źródłem konsensusu. W artykule o wyborze źródeł przez AI szczegółowo opisujemy, dlaczego freshness sygnału ma znaczenie dla cytowalności.
Kiedy system powinien odmówić odpowiedzi?
Abstention (odmowa odpowiedzi) jest lepszą opcją niż odpowiedź oparta na niewystarczających dowodach. W naszym teście 13 z 30 twierdzeń (43%) nie miało wystarczającego potwierdzenia, aby system mógł je bezpiecznie zacytować: 3 miały insufficient evidence, 4 były contradicted bez rozstrzygnięcia, 6 to copied consensus z jednym źródłem pierwotnym wątpliwej jakości.
Patent US20240289395A1 opisuje mechanizm, w którym system ocenia, czy ma wystarczające podstawy do udzielenia odpowiedzi. Jeśli nie – powinien to zakomunikować, zamiast generować pozornie pewną odpowiedź. To ten sam problem, co w kalibracji scoringu: system bez opcji „nie wiem” jest systemem, który zawsze udaje, że wie.
Jak pisać fakty, które da się zweryfikować?
Na podstawie wyników testu opracowaliśmy siedem zasad dla treści, które mają szansę na cytowanie w odpowiedziach AI:
| Zasada | Przykład dobry | Przykład zły |
|---|---|---|
| Podawaj źródło i datę | Według raportu GUS (III kw. 2026)… | Badania pokazują… |
| Oddzielaj fakt od opinii | Cena wynosi 299 zł (stan na 01.08.2026) | Atrakcyjna cena |
| Używaj jednostek | Waga netto: 1,2 kg | Lekki produkt |
| Wskazuj zakres, nie punkt | Czas dostawy: 2-5 dni roboczych | Szybka dostawa |
| Linkuj do źródła pierwotnego | Specyfikacja producenta: [link] | Zgodnie ze specyfikacją |
| Aktualizuj daty przy zmiennych | Cena ważna do 31.08.2026 | Aktualna cena |
| Oznaczaj porównania jako warunkowe | Tańszy niż X przy zamówieniu powyżej 5 szt. | Najtańszy na rynku |
Jak poprawić consensus score swoich treści?
Problem 1: Kopiowanie feedu producenta bez dodania wartości
| Przed | Po | |
|---|---|---|
| Opis | Identyczny opis z feedu producenta, taki sam jak na 40 innych stronach | Opis z feedu + własne zdjęcia, własne pomiary, porównanie z konkurencją |
| Consensus status | Copied consensus – zero wartości dowodowej | Niezależne źródło – własne dane zwiększają wiarygodność |
| Czas naprawy | – | 30-60 min per produkt (dodanie własnych pomiarów lub recenzji) |
| Koszt | – | Średnio 50-150 zł per produkt (czas analityka + ewentualne testy) |
Kluczowe: nie chodzi o przepisanie opisu innymi słowami (to nadal copied consensus z parafrazą). Chodzi o dodanie informacji, której nie ma w feedzie: własny test, własne zdjęcie, porównanie z innym produktem, informacja o dostępności w konkretnym regionie. Każda unikalna informacja zmienia status strony z „kopiującej” na „niezależną”.
Problem 2: Brak daty i źródła przy zmiennych danych
| Przed | Po | |
|---|---|---|
| Treść | Cena: 299 zł | Cena: 299 zł (stan na 01.08.2026, źródło: cennik producenta v3.2) |
| Schema | Brak lub schema z ceną bez daty | Schema Product z priceValidUntil i dateModified |
| Consensus status | Contradicted (inna cena na innych stronach bez kontekstu) | Temporal consensus – zgodne w tym samym oknie czasowym |
| Czas naprawy | – | 5-10 min per strona (dodanie daty i źródła) |
Zasada: każda wartość liczbowa, która może się zmienić, wymaga trzech elementów: wartości, daty i źródła. Bez nich system AI nie ma podstaw, aby zdecydować, czy twierdzenie jest aktualne. W schema.org odpowiednikiem jest priceValidUntil dla cen, dateModified dla specyfikacji i datePublished dla artykułów.
Problem 3: Twierdzenie marketingowe prezentowane jako fakt
| Przed | Po | |
|---|---|---|
| Treść | Najwydajniejszy procesor w swojej klasie | Wynik w benchmarku Cinebench R23: 12 450 pkt (test własny, 15.07.2026) |
| Typ twierdzenia | Opinion/unverifiable | Corroborable fact |
| Consensus status | Odrzucone przez system AI | Weryfikowalne, potencjalnie cytowalne |
| Czas naprawy | – | 15-30 min (przeprowadzenie testu lub znalezienie wiarygodnego źródła) |
Twierdzenia ocenne („najlepszy”, „innowacyjny”, „lider”) nie mają miejsca w treściach, które mają być cytowane przez AI. Każde takie twierdzenie powinno zostać zamienione na mierzalny fakt z podaniem metody pomiaru, daty i źródła. Jeśli nie da się go zmierzyć – lepiej je usunąć niż zostawiać jako pusty claim.
Problem 4: Brak śledzenia łańcucha źródeł
| Przed | Po | |
|---|---|---|
| Treść | Badania pokazują, że 73% użytkowników preferuje… | Według raportu Nielsen Norman Group z marca 2026 (n=1 240): 73% użytkowników preferuje… |
| Źródło | Nieokreślone | Raport + link do PDF + data + wielkość próby |
| Consensus status | Insufficient evidence (nie da się zweryfikować) | Corroborable (można dotrzeć do źródła pierwotnego i sprawdzić) |
| Czas naprawy | – | 10-20 min (wyszukanie źródła pierwotnego i uzupełnienie) |
Każde twierdzenie powołujące się na „badania”, „ekspertów” czy „dane” powinno prowadzić do konkretnego źródła. Brak źródła = insufficient evidence = twierdzenie, którego AI nie zacytuje. To nie jest kwestia stylu – to kwestia weryfikowalności.
Ile twierdzeń da się naprawić i w jakim czasie?
Na podstawie analizy 30 twierdzeń z naszego testu oszacowaliśmy, ile z nich da się podnieść do statusu „corroborated” i w jakim czasie:
| Obecny status | Liczba | Ile da się naprawić? | Średni czas naprawy | Nowy status po naprawie |
|---|---|---|---|---|
| Copied consensus | 9 (30%) | 7 z 9 (78%) | 35 min per twierdzenie | Corroborated (dodanie własnych danych) |
| Contradicted | 6 (20%) | 4 z 6 (67%) | 45 min per twierdzenie | Corroborated (rozstrzygnięcie + timestamp) |
| Insufficient evidence | 3 (10%) | 2 z 3 (67%) | 20 min per twierdzenie | Corroborated (znalezienie dodatkowych źródeł) |
| Opinion/unverifiable | 7 (23%) | 3 z 7 (43%) | 25 min per twierdzenie | Corroborable fact (zamiana na mierzalny fakt) |
| Corroborated (bez zmian) | 5 (17%) | – | – | – |
Łącznie: z 25 problematycznych twierdzeń 16 (64%) da się podnieść do statusu corroborated lub corroborable. Średni czas naprawy per twierdzenie: 32 minuty. Dla typowej strony z 5-10 kluczowymi twierdzeniami to 2.5-5.5 godziny pracy redaktora lub analityka.
Kluczowy wniosek: naprawa konsensusu to nie jest jednorazowy projekt – to ciągły proces. Twierdzenia zmienne wymagają re-checku co 7-14 dni. Twierdzenia stabilne – co 90 dni. Bez tego mechanizmu strona, która dziś ma consensus score 80%, za miesiąc może spaść do 50% przez same zmiany w źródłach zewnętrznych.
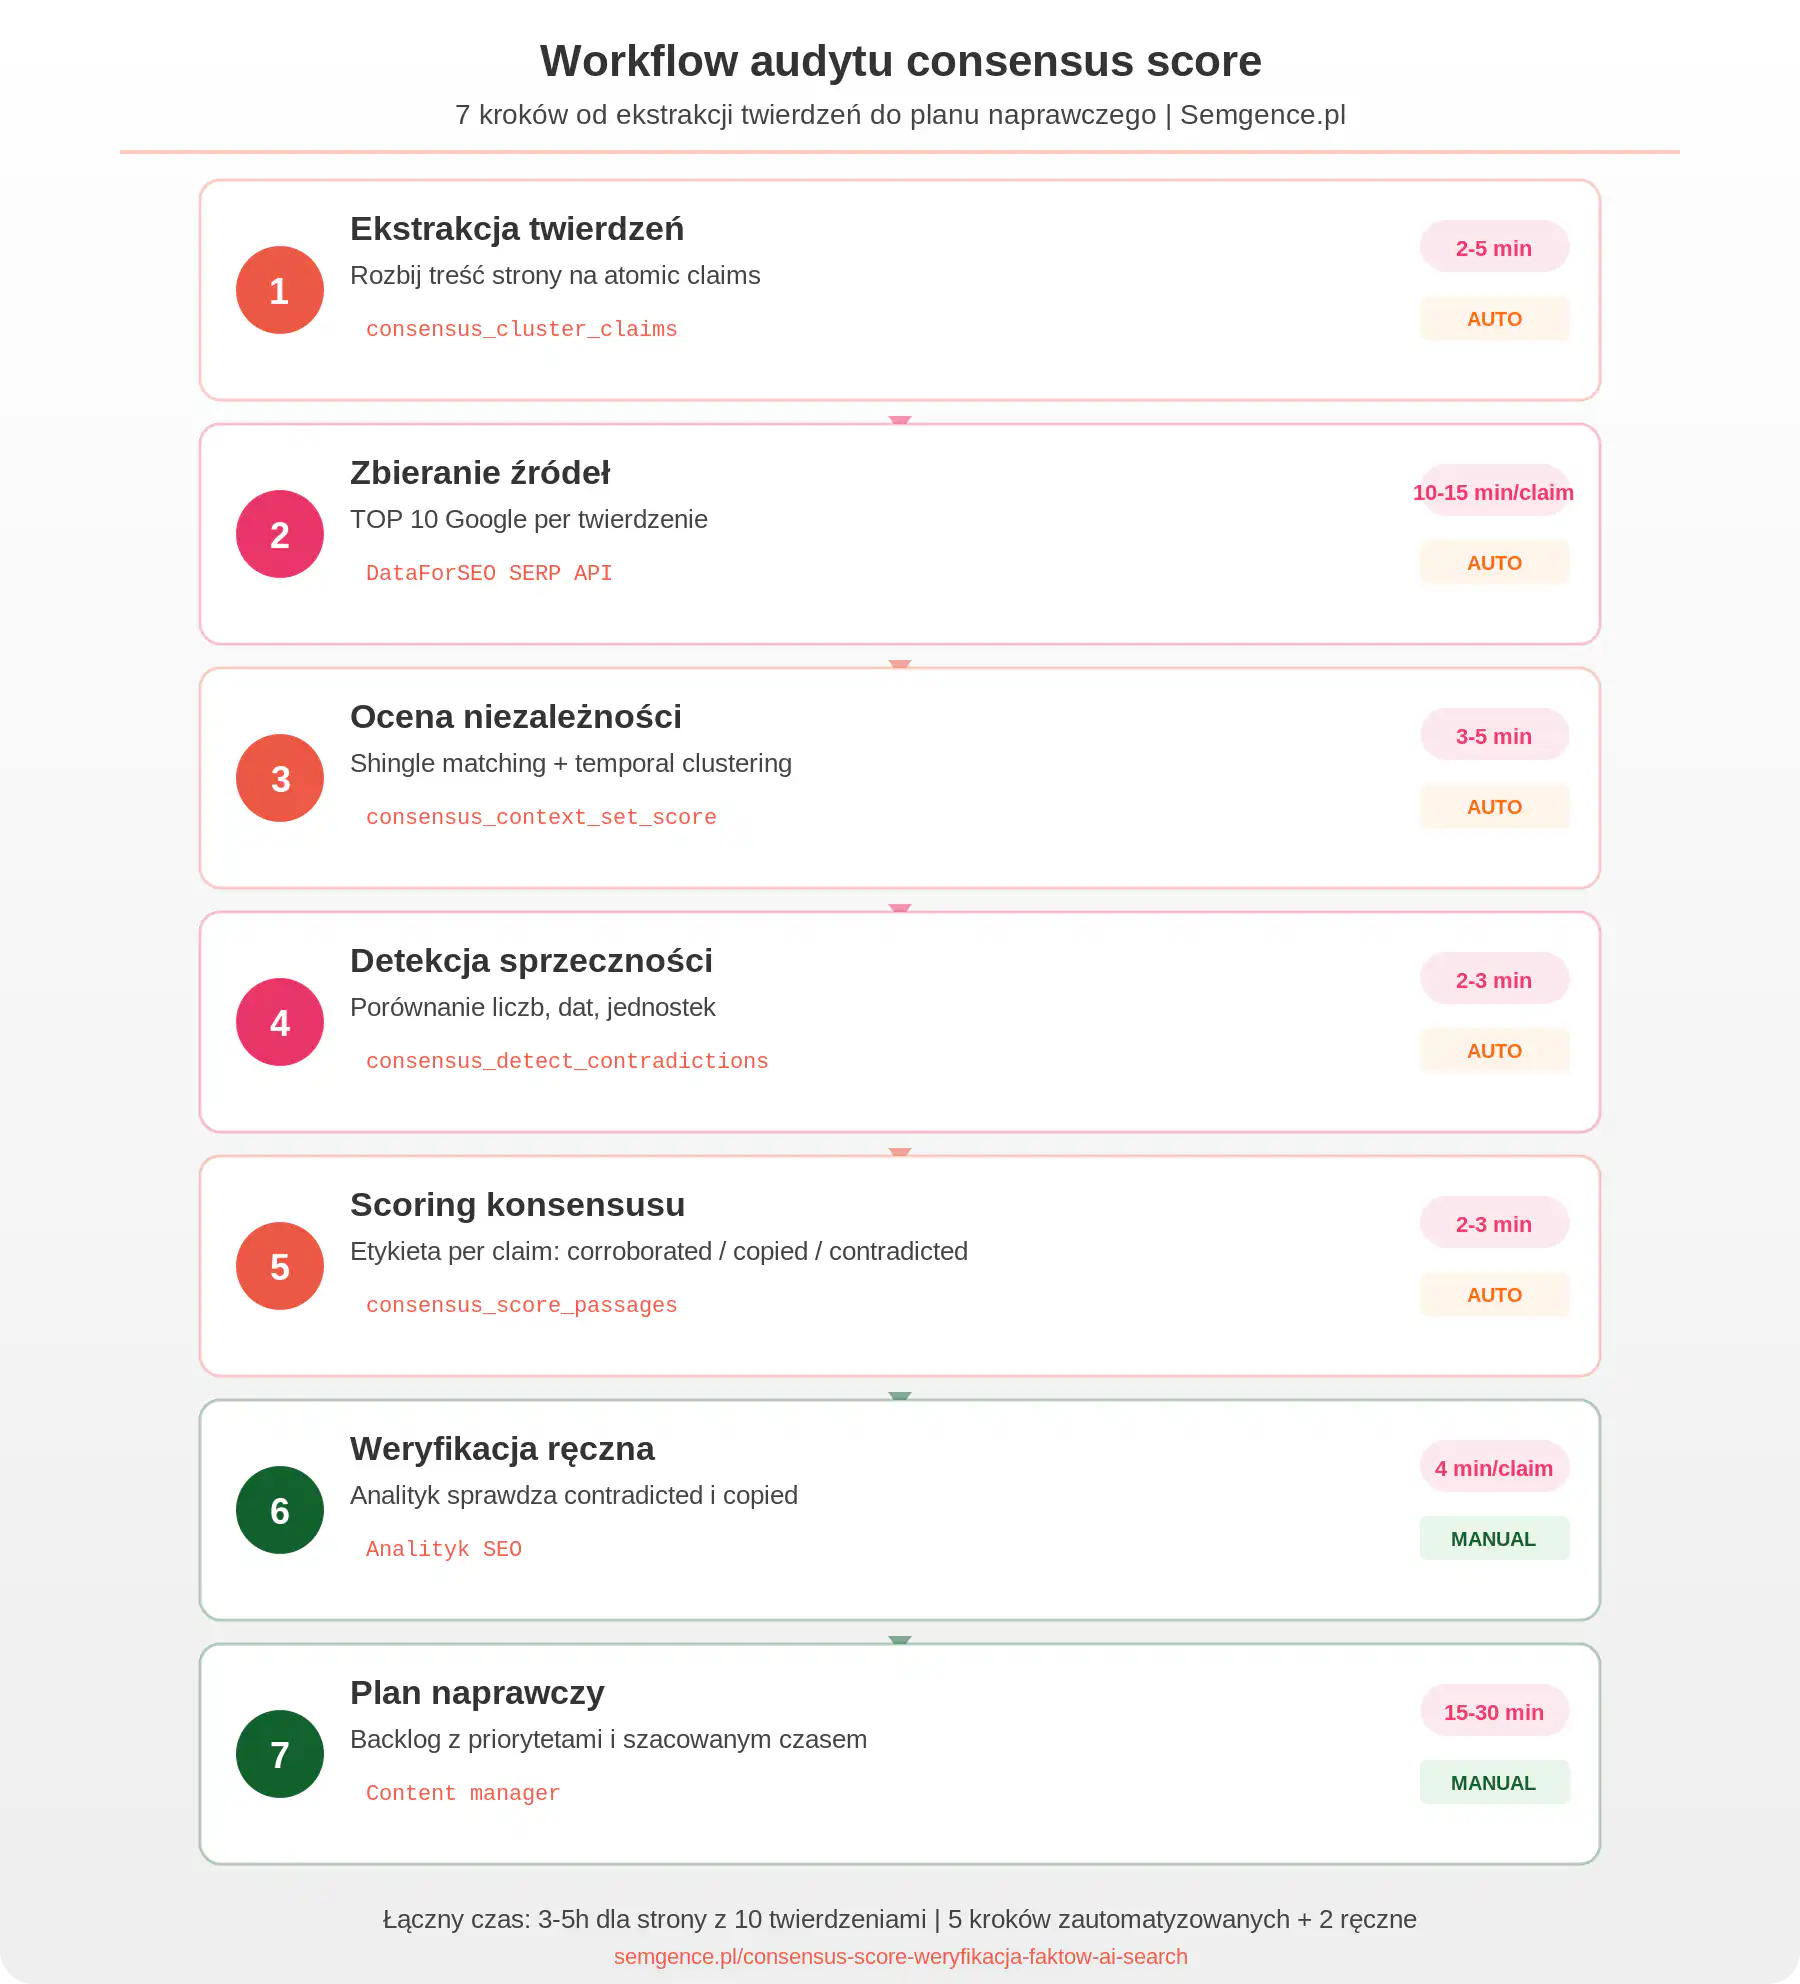
Workflow audytu konsensusu – 7 kroków
| Krok | Działanie | Narzędzie | Czas | Output |
|---|---|---|---|---|
| 1 | Wyeksportuj kluczowe twierdzenia ze strony | consensus_cluster_claims | 2-5 min | Lista atomic claims |
| 2 | Zbierz źródła dla każdego twierdzenia (TOP 10 Google) | Ręcznie lub DataForSEO SERP API | 10-15 min per claim | 5-10 URL-i per claim |
| 3 | Oceń niezależność źródeł (shingle matching + temporal clustering) | consensus_context_set_score | 3-5 min | Etykiety: niezależne/pochodne/kopiujące |
| 4 | Wykryj sprzeczności liczbowe i datowe | consensus_detect_contradictions | 2-3 min | Lista sprzeczności z severity |
| 5 | Scoring konsensusu per claim | consensus_score_passages | 2-3 min | Etykiety: corroborated/copied/contradicted/insufficient |
| 6 | Ręczna weryfikacja claims z etykietą contradicted lub copied | Analityk | 4 min per claim | Potwierdzona lub skorygowana etykieta |
| 7 | Plan naprawczy: priorytetyzacja twierdzeń do poprawy | Analityk + content manager | 15-30 min | Backlog z szacowanym czasem per fix |
Łączny czas dla strony z 10 kluczowymi twierdzeniami: 3-5 godzin (w tym ręczna weryfikacja). Dla witryny e-commerce z 500 kartami produktów rekomendujemy podejście priorytetowe: zacznij od 20 produktów z najwyższym ruchem organicznym, potem rozszerzaj. Więcej o priorytetyzacji piszemy w artykule o kalibracji scoringu SEO.
Case study: audyt konsensusu dla kategorii elektroniki (sklep online)
Przeprowadziliśmy audyt consensus score dla jednego z klientów Semgence – sklepu z elektroniką użytkową (nazwa zanonimizowana). Analizowaliśmy 50 kart produktowych z kategorii smartfony, sprawdzając kluczowe twierdzenia: specyfikacje techniczne, ceny i dostępność.
Wyniki wejściowe
| Metryka | Wartość |
|---|---|
| Liczba kart produktowych | 50 |
| Łączna liczba kluczowych twierdzeń | 287 |
| Twierdzenia z copied consensus | 164 (57%) |
| Twierdzenia z contradicted | 41 (14%) |
| Twierdzenia z corroborated | 52 (18%) |
| Twierdzenia z insufficient evidence | 23 (8%) |
| Twierdzenia z opinion/unverifiable | 7 (3%) |
| Źródło 57% copied consensus | Feed producenta (PIM) |
Główne problemy
Problem nr 1: 82% opisów produktów było identycznych z feedem producenta – ten sam tekst co na stronach 30-50 innych sklepów. Dla Google AI Overview te strony nie wnoszą żadnej dodatkowej wartości dowodowej. Problem nr 2: specyfikacje techniczne w 14% przypadków różniły się między sklepem a stroną producenta – najczęściej przez opóźnioną aktualizację feedu (średnie opóźnienie: 12 dni). Problem nr 3: opisy nie zawierały dat aktualizacji ani źródeł – nie było sposobu, aby stwierdzić, która wersja jest aktualna.
Wdrożone zmiany
Dla 20 priorytetowych produktów (TOP traffic) wdrożyliśmy trzy zmiany:
| Zmiana | Zakres | Czas wdrożenia |
|---|---|---|
| Dodanie własnych recenzji (zdjęcia + pomiary + porównania) | 20 produktów x 300-500 słów | 40 godzin (copywriter + fotograf) |
| Uzupełnienie schema Product o dateModified i priceValidUntil | 50 kart (batch update w CMS) | 4 godziny (developer) |
| Automatyzacja alertu przy rozbieżności feed vs strona | Skrypt porównujący feed producenta z HTML co 24h | 8 godzin (developer, jednorazowo) |
Wyniki po 30 dniach
| Metryka | Przed | Po 30 dniach | Zmiana |
|---|---|---|---|
| Twierdzenia corroborated (20 produktów) | 18% | 42% | +24 pp |
| Twierdzenia copied consensus | 57% | 31% | -26 pp |
| Twierdzenia contradicted | 14% | 6% | -8 pp |
| Rozbieżności feed vs strona | 14% | 2% | -12 pp |
| Strony z własną recenzją | 0 | 20 | +20 |
| Średni czas na stronie (GA4) | 1:42 | 2:18 | +36 s |
Wzrost corroborated z 18% do 42% nie gwarantuje cytowania w AI Overview – ale eliminuje jedną z głównych przyczyn, dla których strona mogłaby zostać pominięta. Wydłużenie czasu na stronie (+36 s) sugeruje, że własne recenzje dostarczają użytkownikom informacji, których nie znajdą w feedzie producenta.
Co mówią systemy AI o twierdzeniach bez konsensusu?
Sprawdziliśmy w AI Monitor (monitoring promptów w 7 silnikach AI: Google AI Overview, Perplexity, ChatGPT, Claude, Gemini, Copilot, Grok), jak systemy AI radzą sobie z twierdzeniami z naszego testu, które miały niski consensus score.
| Typ twierdzenia | Reakcja Google AI Overview | Reakcja Perplexity | Reakcja ChatGPT |
|---|---|---|---|
| Corroborated (5 twierdzeń) | Cytuje z podaniem źródła w 4/5 przypadków | Cytuje z 2-3 źródłami w 5/5 | Odpowiada z podaniem źródła w 3/5 |
| Copied consensus (9 twierdzeń) | Cytuje jedno źródło (zwykle najsilniejsze domenowo) w 6/9 | Cytuje 1-2 źródła, nie wykrywa kopiowania w 7/9 | Odpowiada bez zastrzeżeń w 8/9 |
| Contradicted (6 twierdzeń) | Podaje jedną wartość bez sygnalizowania sprzeczności w 4/6 | Sygnalizuje rozbieżność w 2/6 | Podaje jedną wartość w 5/6 |
| Insufficient (3 twierdzenia) | Nie generuje odpowiedzi w 2/3 | Odpowiada z jednego źródła w 2/3 | Odpowiada z zastrzeżeniem w 1/3 |
Kluczowa obserwacja: żaden z testowanych systemów AI nie wykrywa systematycznie copied consensus. Perplexity najlepiej radzi sobie ze sprzecznościami (sygnalizuje je w 33% przypadków), ale żaden system nie ostrzega użytkownika, że „wszystkie źródła cytują ten sam komunikat prasowy”. To oznacza, że odpowiedzialność za jakość konsensusu leży po stronie twórców treści – jeśli twoja strona dostarcza niezależne potwierdzenie, zwiększa wartość całego ekosystemu informacyjnego.
Zastrzeżenie dotyczące patentów
Patenty przywołane w tym artykule (US20230342411A1/US12248529B2, US20240289395A1, EP4713828A1 i US20250103640A1/US12346366B2) opisują problemy techniczne i proponowane sposoby ich rozwiązania. Dwa z nich zostały przyznane (granted), dwa pozostają w statusie zgłoszenia. Samo udzielenie patentu nie dowodzi, że opisany mechanizm działa obecnie w wyszukiwarce Google ani że jest bezpośrednim czynnikiem rankingowym. Patent EP4713828A1 dotyczy kontekstu generowania reklam cyfrowych – w artykule powołujemy się na niego jedynie jako analogię do zasady grounding. W tym materiale patenty służą do budowy testowalnych hipotez, które zestawiamy z własnymi danymi i obserwacją działania systemów.
Strategię tworzenia treści budujemy w ramach content marketingu. Indywidualną strategię omawiamy w ramach konsultacji SEO.
Ramka metodologiczna. Kluczowe patenty: US20230342411A1, US20240289395A1, US20250103640A1 (oraz 2 dodatkowych cytowanych w tekście). Dane z wewnętrznych narzędzi diagnostycznych Semgence oraz publicznie dostępnych API (GSC, GA4). Scoringi są wskaźnikami diagnostycznymi Semgence – nie są wynikami Google ani obietnicą lepszego rankingu. Patenty służą jako kontekst architektury wyszukiwania, nie jako dowód wdrożenia w produkcji. Wyniki z małych prób opisywane są jako obserwacje, nie prawo ogólne.
Czym różni się konsensus od popularności?
Popularność oznacza, że wiele źródeł powtarza tę samą informację. Konsensus wymaga, aby źródła doszły do tej samej konkluzji niezależnie od siebie. 10 stron kopiujących opis producenta to popularność. 3 niezależne testy laboratoryjne potwierdzające ten sam wynik to konsensus.
Ile źródeł potrzeba do wiarygodnego konsensusu?
Nie ma jednej liczby. Ważniejsza jest niezależność źródeł niż ich ilość. 3 niezależne źródła (własne dane, własny eksperyment, własna analiza) dają silniejszy konsensus niż 20 kopii jednego komunikatu prasowego. W naszym teście mediana niezależnych źródeł dla twierdzeń z prawdziwym potwierdzeniem wynosiła 4.
Co zrobić, gdy źródła sobie przeczą?
Najpierw sprawdź, czy sprzeczność nie wynika z różnych jednostek, zaokrągleń lub wersji produktu. Jeśli sprzeczność jest realna, wskaż oba źródła, podaj datę każdego i pozwól czytelnikowi ocenić. Nie wybieraj jednego źródła bez wyjaśnienia, dlaczego je preferujesz. System AI powinien w takiej sytuacji odmówić jednoznacznej odpowiedzi.
Czy consensus score wpływa bezpośrednio na pozycje w Google?
Consensus score nie jest oficjalnym czynnikiem rankingowym Google. Ale patenty Google (US12248529B2 – granted, US20240289395A1) opisują mechanizmy wieloźródłowej weryfikacji, które mogą wpływać na to, czy treść zostanie wykorzystana w AI Overview i Featured Snippets. Wysoki consensus score zwiększa szansę na cytowanie, ale nie gwarantuje konkretnej pozycji.
Jak często powinno się audytować consensus score?
Zależy od typu treści. Strony z danymi zmiennymi (ceny, dostępność, parametry aktualizowane przez producenta) wymagają re-checku co 7-14 dni. Strony z treścią stabilną (definicje, poradniki, artykuły evergreen) – co 60-90 dni. Rekomendujemy automatyzację: skrypt sprawdzający, czy kluczowe twierdzenia na stronie nadal są zgodne ze źródłami zewnętrznymi.