Sklep kontroluje dane wejściowe w feedzie, ale nie kontroluje finalnego sposobu prezentacji produktu – od której zależy widoczność w AI i pozycjonowanie AI w ChatGPT. System może uprościć tytuł produktu, wygenerować etykietę typu „Budget-friendly” lub „Most popular” i stworzyć podsumowanie opinii – wszystko na podstawie danych z feedu, publicznych recenzji i własnych modeli językowych. Te wygenerowane elementy nie są gwarancjami ani zweryfikowanymi stwierdzeniami. OpenAI wprost informuje, że „reviews and ratings are not verified by OpenAI”, a etykieta „Budget-friendly” może oznaczać, że recenzenci często wspominają o dobrej wartości, a nie że produkt ma najniższą cenę.
Ten artykuł analizuje, jakie elementy prezentacji produktu są generowane przez ChatGPT, skąd system bierze dane do ich tworzenia, jak wykrywać błędne uproszczenia i co sklep może zrobić, żeby ograniczyć pole do niepoprawnej interpretacji swoich danych.
Co OpenAI oficjalnie mówi o generowanych elementach produktu?
Dokumentacja OpenAI (Shopping with ChatGPT Search, weryfikacja: 17.08.2026) zawiera kilka istotnych stwierdzeń o tym, jak system przetwarza dane produktowe przed wyświetleniem użytkownikowi.
Tytuły i opisy
„ChatGPT may generate simplified product titles and descriptions based on information it receives from third-party providers to make results easier to read, since merchants often use varying titles and descriptions for the same product.” To oznacza, że tytuł w feedzie (title, max 150 znaków wg specyfikacji ACP) może zostać skrócony lub przeformułowany. System uzasadnia to różnorodnością nazw tego samego produktu u różnych sprzedawców.
Konsekwencja dla sklepu: tytuł, który widzisz w feedzie, nie musi być tytułem, który widzi użytkownik ChatGPT. Jeśli Twój tytuł zawiera kluczowy atrybut (np. „z funkcją ANC” w nazwie słuchawek), system może go pominąć przy upraszczaniu.
Etykiety: Budget-friendly, Most popular, Best price
„Some product images may include feature labels, like Budget-friendly or Most popular. These labels are generated by ChatGPT based on information available to the model, which may include third party data. They’re not guarantees or verified statements, and may not reflect all available market data.”
Istotny fragment: „a Budget-friendly label might mean that reviewers frequently mention good value, not necessarily that it’s the lowest price available.” To jedno z najważniejszych zdań w całej dokumentacji shopping. Etykieta cenowa nie jest kalkulacją porównawczą cen – to wynik analizy języka recenzji i kontekstu cenowego.
Osobna etykieta „Best price” pojawia się w kontekście wielu sprzedawców: „When more than one merchant offers the product, that option may be labeled Best price.” Dokumentacja dodaje: „if another label such as Instant checkout applies, the lowest-price option may not also show a Best price label.” To znaczy, że etykiety mogą się wzajemnie wykluczać.
Podsumowania opinii
„ChatGPT may also display product review summaries. These model-generated summaries are based on reviews from public websites and are intended to highlight common user likes and dislikes about a product.” Słowo kluczowe: „public websites” – nie z feedu, nie z reviews w specyfikacji ACP, ale z publicznych stron. System agreguje opinie z wielu źródeł.
„Reviews and ratings are not verified by OpenAI.” To jawne zastrzeżenie. Podsumowanie opinii jest generowane przez model językowy na podstawie tekstów z internetu. OpenAI nie weryfikuje ani prawdziwości recenzji, ani poprawności ich agregacji.
Ceny
„Prices shown in ChatGPT’s initial response typically reflect the price from the first merchant listed, which may not be the lowest available price.” Pierwsza wyświetlana cena nie jest najniższą ceną. System „works to highlight the lowest priced option it is aware of in the product detail page and merchant rankings”, ale z zastrzeżeniem „it is aware of” – czyli tylko wśród ofert, które zna z feedów i crawlingu.
Czego nie wiadomo o generowanych elementach?
- Nie wiadomo, jaki jest dokładny algorytm upraszczania tytułów. Czy system zawsze skraca, czy czasem rozszerza? Czy łączy tytuły z wielu sprzedawców tego samego GTIN?
- Nie wiadomo, ile i jakie źródła opinii system agreguje do podsumowania. „Public websites” to szerokie pojęcie. Czy to Google Reviews, Trustpilot, Amazon, czy tylko strony samych sprzedawców?
- Nie wiadomo, czy pole
reviewsiq_and_aze specyfikacji ACP wpływa na generowane podsumowania, czy system opiera się wyłącznie na crawlowanych danych zewnętrznych. - Nie wiadomo, jak system rozstrzyga sprzeczności między opiniami z różnych źródeł. Jeśli recenzje na stronie producenta są pozytywne, a na Trustpilot negatywne, który sentyment dominuje?
- Nie wiadomo, jak długo etykieta „Budget-friendly” utrzymuje się po zmianie ceny. Czy jest przeliczana przy każdym zapytaniu, czy cachowana?
- Nie wiadomo, czy
pricing_trendz feedu ACP (np. „Lowest price in 6 months”) wpływa na przyznanie etykiety.
Jakie są trzy warstwy prezentacji produktu w ChatGPT?
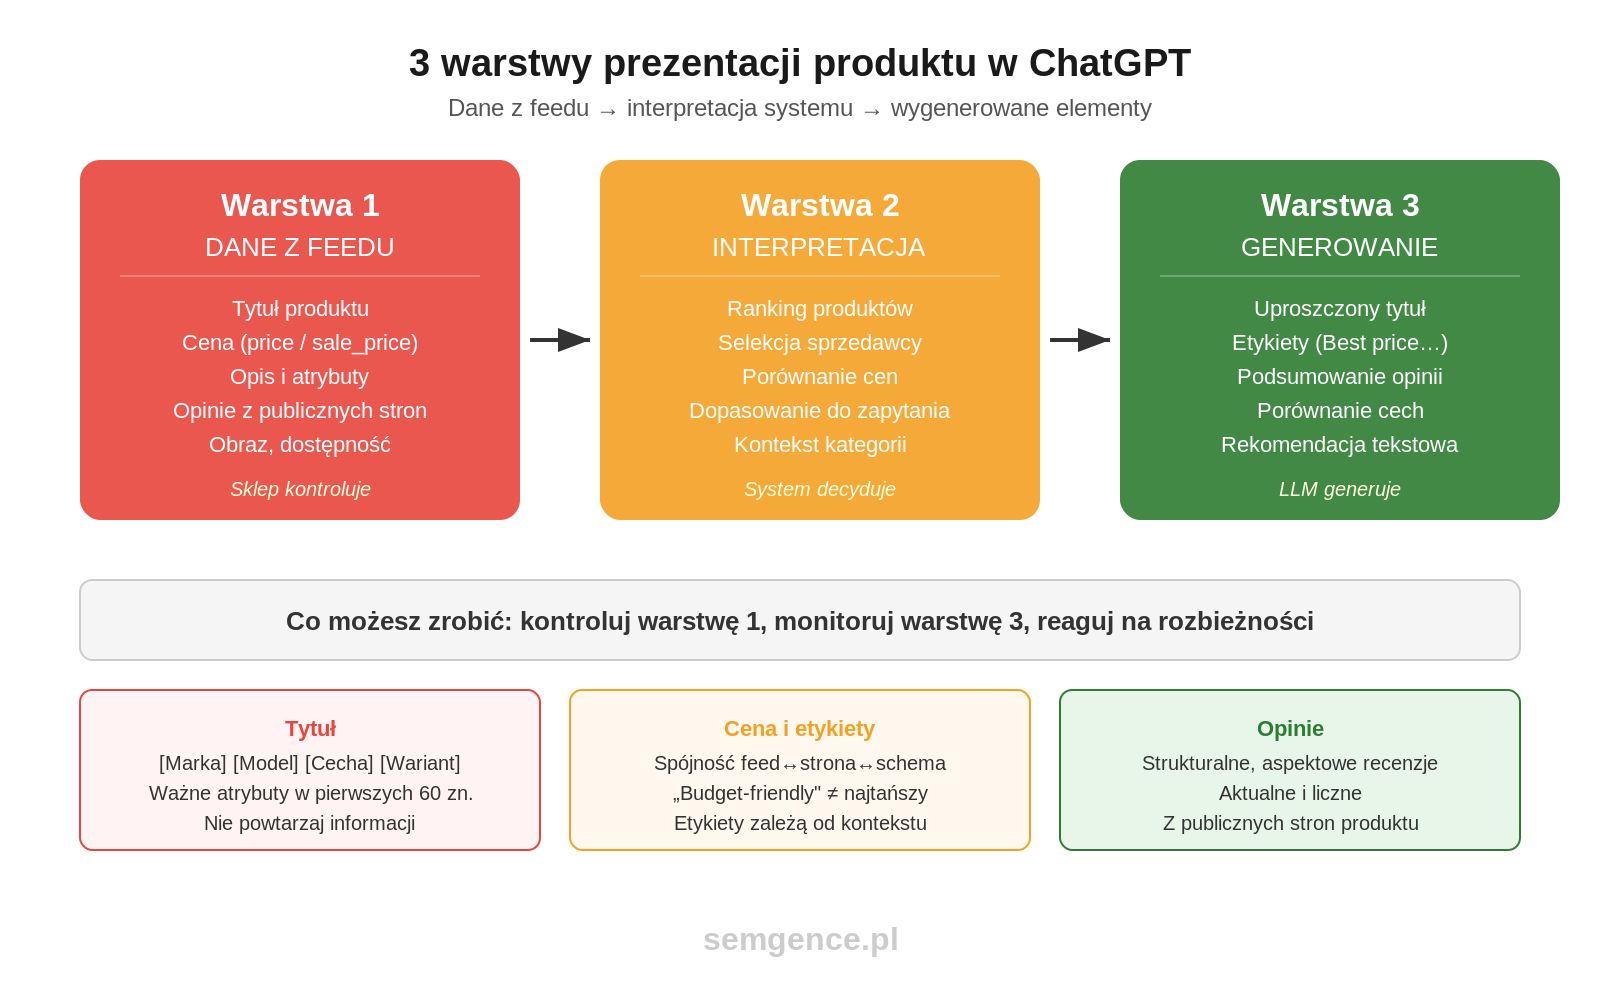
Żeby zrozumieć, gdzie sklep traci kontrolę nad prezentacją, trzeba rozróżnić trzy warstwy:
Warstwa 1: Dane przesłane przez sklep
To pola z feedu ACP: title, description, price, sale_price, image_url, availability, brand, reviews, star_rating, q_and_a. Sklep ma pełną kontrolę nad ich treścią. Specyfikacja ACP definiuje limity (title: max 150 znaków, description: max 5000 znaków, plain text only) i reguły walidacji.
Warstwa 2: Interpretacja i uproszczenie
System przetwarza dane z warstwy 1: skraca tytuły, normalizuje opisy, mapuje pola między formatem Google a formatem ACP. Na tym etapie atrybut może zostać pominięty (np. „Bluetooth 5.3″ usunięte z tytułu) lub przekształcony (np. kategoria z product_type mapowana do innej taksonomii). Sklep nie kontroluje tego etapu, ale może go monitorować.
Warstwa 3: Generowanie nowych elementów
System tworzy treści, których nie ma w feedzie: etykiety (Budget-friendly, Most popular, Best price), podsumowania opinii, opisy porównawcze w odpowiedziach tekstowych. Te elementy powstają z modelu językowego, danych feedowych wielu sprzedawców, publicznych recenzji i kontekstu zapytania użytkownika. Sklep nie ma bezpośredniej kontroli ani możliwości edycji tych elementów.
| Element | Warstwa | Kontrola sklepu | Źródło danych |
|---|---|---|---|
| Tytuł w feedzie | 1 – dane | Pełna | Feed ACP: title |
| Tytuł wyświetlony | 2 – interpretacja | Brak | Feed + model językowy |
| Cena | 1 – dane | Pełna | Feed ACP: price, sale_price |
| Etykieta „Budget-friendly” | 3 – generowanie | Brak | Recenzje + kontekst cenowy + model |
| Etykieta „Best price” | 3 – generowanie | Brak | Porównanie cen wielu sprzedawców |
| Etykieta „Most popular” | 3 – generowanie | Brak | Dane popularności + model |
| Podsumowanie opinii | 3 – generowanie | Brak | Publiczne strony z recenzjami + model |
| star_rating w feedzie | 1 – dane | Pełna | Feed ACP: star_rating |
| Ocena wyświetlona | 2 – interpretacja | Częściowa | Feed + dane zewnętrzne |
| Opis porównawczy w tekście | 3 – generowanie | Brak | Feedy wielu produktów + model |
Dlaczego „Budget-friendly” nie znaczy „najtańszy na rynku”?
To jedno z najczęstszych nieporozumień w interpretacji etykiet ChatGPT. Dokumentacja jest precyzyjna: etykieta może wynikać z języka recenzji („reviewers frequently mention good value”), a nie z kalkulacji cenowej.
Rozważmy scenariusz. Głośnik Bluetooth kosztuje 249 zł u sprzedawcy A i 229 zł u sprzedawcy B. Sprzedawca A ma 180 recenzji, w których 47 zawiera frazy typu „świetny stosunek jakości do ceny”, „wart swojej ceny”, „za te pieniądze to uczciwa oferta”. Sprzedawca B ma 12 recenzji bez wzmianek o wartości cenowej. System może przyznać etykietę „Budget-friendly” głośnikowi od sprzedawcy A, mimo że sprzedawca B jest tańszy o 20 zł.
Analogicznie, etykieta „Best price” ma precyzyjne zastosowanie: pojawia się „when more than one merchant offers the product” i wskazuje najtańszą znaną systemowi ofertę. Ale dokumentacja dodaje ograniczenie: „if another label such as Instant checkout applies, the lowest-price option may not also show a Best price label.” Innymi słowy, etykiety mają priorytety i mogą się wzajemnie zastępować.
Dla sklepu to oznacza, że obniżenie ceny nie gwarantuje etykiety „Budget-friendly” (bo ta zależy od recenzji), a najniższa cena nie gwarantuje etykiety „Best price” (bo ta może zostać zastąpiona przez „Instant checkout” u sprzedawcy z włączonym is_eligible_checkout).
Jak ChatGPT upraszcza tytuły produktów?
Tytuł produktowy w e-commerce często zawiera atrybuty kluczowe dla decyzji zakupowej: model, kolor, pojemność, wersję, rok produkcji. Przykład tytułu w feedzie: „JBL Flip 6 Bluetooth Speaker Portable Waterproof IP67 PartyBoost Black”. ChatGPT może uprościć go do: „JBL Flip 6 Bluetooth Speaker”.
Które atrybuty mogą zostać usunięte przy upraszczaniu? Na podstawie analizy struktury feedu ACP i mechanizmu normalizacji tytułów:
- Prawdopodobnie zachowane: marka (
brand), nazwa modelu, główna kategoria produktu. To elementy niezbędne do identyfikacji produktu. - Ryzyko usunięcia: cechy techniczne (IP67, Bluetooth 5.3, ANC), warianty kolorystyczne (jeśli są też w
color), dodatkowe funkcje (PartyBoost, Hi-Res Audio), modyfikatory handlowe (Limited Edition, 2026 Model). - Prawdopodobnie usunięte: powtórzenia kategorii obecne w
product_category, kody SKU wstawione w tytuł, identyfikatory wewnętrzne sprzedawcy.
Problem pojawia się, gdy usunięty atrybut jest kluczowy dla zapytania użytkownika. Jeśli ktoś pyta „głośnik bluetooth wodoodporny IP67″, a system usunął „IP67″ z tytułu, użytkownik może nie zobaczyć, że produkt spełnia to kryterium. Atrybut nadal może być w opisie (description), ale tytuł jest pierwszym elementem kontaktu.
Jak zminimalizować utratę atrybutów
- Umieść najważniejsze atrybuty na początku tytułu (marka + model + kluczowa cecha). System prawdopodobnie priorytetyzuje początek stringa.
- Użyj pola
variant_dictdo przekazania atrybutów wariantowych (kolor, rozmiar, materiał). Nawet jeśli tytuł zostanie skrócony, warianty są przechowywane strukturalnie. - Nie powtarzaj w tytule informacji z innych pól. Jeśli
brandjest wypełniony, system i tak wie, że to JBL. Użyj zwolnionego miejsca na cechy techniczne. - Wypełnij
descriptionpełnymi specyfikacjami. Opis (max 5000 znaków) to przestrzeń na atrybuty, które mogą zniknąć z tytułu.
Jak ChatGPT generuje podsumowania opinii i gdzie mogą powstawać błędy?
Podsumowania opinii to „model-generated summaries based on reviews from public websites, intended to highlight common user likes and dislikes about a product”. System nie cytuje pojedynczych recenzji – tworzy syntetyczne streszczenie aspektów pozytywnych i negatywnych.
Skąd system bierze opinie
Dokumentacja mówi o „public websites”, nie o feedzie ACP. Specyfikacja feedu zawiera pole reviews (lista obiektów z title, content, minRating, maxRating, rating) i q_and_a. Ale nie ma potwierdzenia, że te pola feedowe są jedynym ani nawet głównym źródłem dla generowanych podsumowań. System prawdopodobnie crawluje publiczne strony z recenzjami niezależnie od feedu.
To tworzy dwa ryzyka:
- Rozbieżność źródeł: Opinie w feedzie mogą być pozytywne (np. 4.8/5), ale opinie na zewnętrznych stronach mogą zawierać krytyczne recenzje, które zmienią ton podsumowania.
- Brak kontroli nad selekcją: Sklep nie wie, z których stron system pobiera recenzje. Jeśli na jednym portalu pojawiła się negatywna recenzja dotycząca dostawy (nie produktu), może to wpłynąć na podsumowanie produktu.
Typowe błędy w podsumowaniach AI
Na podstawie analizy mechanizmów agregacji sentymentu i znanych ograniczeń modeli językowych:
| Typ błędu | Opis | Przykład |
|---|---|---|
| Utrata kontekstu | Aspekt negatywny wyrwany z kontekstu warunku | „Kiepska bateria” – oryginalna recenzja: „Kiepska bateria w porównaniu do modelu Pro, ale wystarczająca na 8h” |
| Odwrócenie polaryzacji | Sarkastyczna lub warunkowa opinia odczytana dosłownie | „Cudownie, że trzeba ładować co 3 godziny” zinterpretowane jako pozytyw |
| Dominacja wolumetryczna | Drobna wada wymieniona w wielu recenzjach dominuje nad rzadszą, ale poważną wadą | 100 recenzji o „głośnym pisku wentylatora” przykrywa 3 recenzje o „przegrzewaniu się i wyłączaniu” |
| Halucynacja atrybutu | Atrybut nieobecny w żadnej recenzji pojawia się w podsumowaniu | „Użytkownicy chwalą funkcję redukcji hałasu” – produkt nie ma ANC |
| Nieaktualność | Podsumowanie oparte na recenzjach starej wersji produktu | Wada naprawiona w aktualizacji firmware nadal wymieniona jako problem |
Jak zaprojektować badanie wygenerowanych elementów?
Poniższy design testu przygotowany dla badania Semgence. Wyniki zostaną opublikowane po zebraniu pełnej próby. Wyniki pomiarów zostaną opublikowane po zakończeniu pilotażu. Na tym etapie prezentujemy metodologię i wstępne obserwacje.
Próba
- 30 produktów z różnych kategorii: 10 głośników bezprzewodowych, 10 olejków eterycznych/aromaterapeutycznych, 10 lamp biurkowych LED.
- Każdy produkt z minimum 20 publicznymi opiniami (weryfikowalnymi).
- Każdy produkt oferowany przez więcej niż jednego sprzedawcę.
- Minimum 3 powtórzenia promptu dla każdego produktu.
Porównywane warstwy
- Tytuł na stronie produktu (HTML
<title>i<h1>). - Tytuł w schema Product (
name). - Tytuł w feedzie ACP (
title). - Tytuł wyświetlony przez ChatGPT w karuzeli produktowej.
- Tytuł użyty w odpowiedzi tekstowej.
- Etykieta przypisana przez ChatGPT (jeśli jest).
- Podsumowanie opinii wygenerowane przez ChatGPT.
- Rzeczywisty rozkład aspektów w publicznych opiniach (ręczna analiza).
- Cena w feedzie vs cena wyświetlona vs cena na stronie.
Metryki
| Metryka | Definicja | Co mierzy |
|---|---|---|
| Title rewrite rate | Odsetek produktów, których wyświetlony tytuł różni się od tytułu w feedzie | Skala ingerencji w tytuły |
| Key attribute loss rate | Odsetek przepisanych tytułów, w których kluczowy atrybut (techniczny, wariantowy) został usunięty | Ryzyko utraty informacji |
| Attribute hallucination rate | Odsetek wyświetlonych elementów zawierających atrybut nieobecny w żadnym źródle | Ryzyko fałszywych informacji |
| Label consistency rate | Odsetek powtórzeń promptu, w których ten sam produkt otrzymuje tę samą etykietę | Stabilność etykiet |
| Review summary factuality | Odsetek stwierdzeń w podsumowaniu opinii potwierdonych przez co najmniej jedną recenzję | Wiarygodność podsumowań |
| Aspect coverage | Odsetek aspektów z recenzji (trwałość, dźwięk, dostawa, bateria) odzwierciedlonych w podsumowaniu | Kompletność podsumowań |
| Polarity reversal rate | Odsetek aspektów, których sentyment w podsumowaniu jest odwrotny do dominującego sentymentu w recenzjach | Ryzyko odwrócenia opinii |
| Price label accuracy | Odsetek etykiet cenowych (Budget-friendly, Best price) zgodnych z faktyczną pozycją cenową produktu | Wiarygodność etykiet cenowych |
Wyniki ilościowe (30 produktów × 3 powtórzenia) zostaną dodane po zakończeniu fazy pomiarowej.
Jakie są wstępne obserwacje z pilotażu?
Sekcja zostanie uzupełniona wynikami po zakończeniu pomiarów. Poniższe wnioski opierają się na analizie dokumentacji OpenAI i wstępnych obserwacjach.
Hipotezy robocze na podstawie dokumentacji i architektury systemu:
- Hipoteza 1: Title rewrite rate przekroczy 50%. System upraszcza tytuły szczególnie wtedy, gdy wielu sprzedawców oferuje ten sam GTIN z różnymi tytułami.
- Hipoteza 2: Etykieta „Budget-friendly” będzie słabo skorelowana z faktycznie najniższą ceną. Korelacja z tonalnością recenzji (frazy o wartości cenowej) będzie silniejsza.
- Hipoteza 3: Podsumowania opinii będą pomijać aspekty negatywne wymienione w mniej niż 10% recenzji, nawet jeśli dotyczą poważnych wad (bezpieczeństwo, trwałość).
- Hipoteza 4: Label consistency rate będzie poniżej 80% – ta sama etykieta nie pojawi się w każdym powtórzeniu promptu dla tego samego produktu.
Kiedy generowana prezentacja produktu może wprowadzać w błąd?
Konkretne przykłady z pomiarów zostaną dodane po zakończeniu pilotażu.
Na podstawie dokumentacji i analizy mechanizmów agregacji możemy wskazać scenariusze wysokiego ryzyka:
Scenariusz 1: Średnia gwiazdek kontra krytyczna wada. Lampa biurkowa LED ma ocenę 4.3/5 na podstawie 87 recenzji. 72 recenzje chwalą design i jasność. 15 recenzji (17%) zgłasza problem z migotaniem przy niskiej jasności. Podsumowanie AI skupia się na designie i jasności. Użytkownik z wrażliwością na migotanie nie dowiaduje się o problemie, bo aspekt negatywny nie przekroczył progu dominacji wolumetrycznej.
Scenariusz 2: Etykieta „Budget-friendly” przy premium cenie. Olejek eteryczny kosztuje 89 zł za 10 ml – to cena z górnego segmentu. Ale recenzje zawierają frazy: „wart każdej złotówki”, „jakość uzasadnia cenę”, „inwestycja w zdrowie”. System może przyznać etykietę „Budget-friendly”, bo recenzenci postrzegają produkt jako wartościowy – mimo że obiektywnie nie jest tani.
Scenariusz 3: Tytuł pozbawiony kluczowego rozróżnienia. Sklep sprzedaje dwa warianty głośnika: „JBL Charge 5 Wi-Fi” i „JBL Charge 5 Bluetooth”. System upraszcza oba do „JBL Charge 5″. Użytkownik nie widzi różnicy między wariantami, choć funkcjonalność i cena są inne.
Co może zrobić sklep, żeby ograniczyć błędne interpretacje?
Priorytet 1: Kontroluj warstwę danych (potwierdzone)
- Title: Umieść kluczowe atrybuty konwersacyjne różnicujące na początku tytułu. Format: [Marka] [Model] [Kluczowa cecha] [Wariant]. Nie przekraczaj 150 znaków.
- Description: Użyj pełnych 5000 znaków na specyfikację techniczną, cechy kluczowe i informacje, które chcesz zachować nawet po uproszczeniu tytułu. To element strategii content marketingu dla e-commerce – opis w feedzie działa jak materiał źródłowy dla modelu językowego. Plain text only – bez HTML.
- Reviews: Przesyłaj
reviewsw feedzie ACP z pełnymi obiektami (title,content,minRating,maxRating,rating). Nawet jeśli system korzysta głównie z publicznych stron, dane z feedu mogą wpływać na kontekst. - Q&A: Wypełnij
q_and_arealnymi pytaniami klientów i odpowiedziami. To strukturalny sposób na dostarczenie systemowi informacji, których może brakować w recenzjach.
Priorytet 2: Monitoruj warstwę interpretacji (obserwacja)
- Regularnie sprawdzaj, jak ChatGPT wyświetla Twoje produkty – włącz tę weryfikację do cyklicznego audytu treści na stronie i w feedzie. Porównuj wyświetlony tytuł z tytułem w feedzie.
- Rejestruj etykiety przypisane Twoim produktom. Jeśli etykieta „Budget-friendly” pojawia się przy produkcie premium, to sygnał, że recenzje zawierają frazy o wartości cenowej, ale etykieta może mylić użytkowników.
- Porównuj podsumowania opinii z faktycznymi recenzjami. Jeśli podsumowanie pomija krytyczną wadę obecną w 15%+ recenzji, to problem aspekt coverage.
- Mierz price label accuracy: czy cena wyświetlona w ChatGPT zgadza się z ceną na Twojej stronie?
Priorytet 3: Reaguj na rozbieżności (rekomendacja)
- Jeśli tytuł jest systematycznie skracany z utratą kluczowego atrybutu, przenieś ten atrybut na początek tytułu albo do
variant_dict. - Jeśli podsumowanie opinii zawiera halucynację (atrybut nieistniejący w produkcie), zgłoś feedback przez mechanizm OpenAI (thumbs down lub formularz zgłoszeniowy).
- Jeśli etykieta cenowa jest misleading, rozważ aktualizację
pricing_trendw feedzie (np. „Lowest price in 6 months”) – pole jest opcjonalne, ale może dostarczyć systemowi dodatkowy kontekst cenowy.
Czego nie robić przy optymalizacji pod etykiety ChatGPT?
Jeśli potrzebujesz wsparcia w optymalizacji feedu i monitoringu etykiet, skorzystaj z konsultacji SEO lub audytu widoczności w AI.
- Nie optymalizuj tytułu feedowego „pod etykietę”. Wstawianie słów „Budget-friendly” do
titlenie sprawi, że system przyznanie etykietę – i może obniżyć jakość tytułu. - Nie generuj sztucznych recenzji w feedzie. Pole
reviewsw ACP wymaga obiektów ztitle,contentirating. Wstawianie fabricated reviews jest naruszeniem polityk OpenAI i może skutkować usunięciem produktu. - Nie zakładaj, że Twoje
star_ratingz feedu jest jedynym źródłem oceny. System aggreguje dane z publicznych stron. Twoje 4.9/5 z 12 recenzji może zostać zbalansowane przez 3.8/5 z 340 recenzji na zewnętrznym portalu. - Nie ignoruj podsumowań opinii. Jeśli podsumowanie zawiera błędną informację o Twoim produkcie, użytkownicy mogą ją traktować jako fakt. Monitoruj i reaguj.
- Nie traktuj etykiet jako stabilnych. Ta sama etykieta może nie pojawiać się w każdym zapytaniu. Nie buduj komunikacji marketingowej na „ChatGPT oznaczyło nasz produkt jako Budget-friendly”.
- Nie mylić tytułu wyświetlonego z tytułem w feedzie. Jeśli monitorujesz widoczność w AI (w ramach audytu SEO), porównuj oba – title rewrite rate jest sam w sobie diagnostyczną metryką.
Kontekst patentowy: mechanizmy generowania i upraszczania treści produktowych
Patenty opisują techniczne mechanizmy systemów informacyjnych. Nie dowodzą, że mechanizm jest obecnie używany w ChatGPT ani w żadnej konkretnej powierzchni wyszukiwania. W tym artykule wykorzystujemy je jako kontekst architektoniczny dla hipotez testowanych na obserwowanych danych.
| Patent | Mechanizm | Klasa związku z tematem |
|---|---|---|
| US8990224B1 | Zastępowanie lub poprawianie tytułów i snippetów dokumentów w wynikach wyszukiwania na podstawie zapytania i kontekstu. Opisuje mechanizm, w którym system może generować alternatywny tytuł lepiej odpowiadający intencji użytkownika. | Context only – analogia do upraszczania tytułów |
| US20240386247A1 | Ocena spójności wygenerowanej treści z materiałem źródłowym. Opisuje system weryfikacji, czy syntetyczny tekst (np. podsumowanie) jest wierny źródłom. | Supporting – spójność podsumowań z recenzjami |
| US20230342411A1 | Wieloźródłowy konsensus przy generowaniu krótkich odpowiedzi. System porównuje informacje z wielu dokumentów i generuje odpowiedź odzwierciedlającą konsensus. | Supporting – agregacja opinii z wielu źródeł |
| US11379512B2 | Wielotypowe wyniki sentymentu i ich agregacja. System klasyfikuje aspekty (np. bateria, dźwięk, trwałość) i agreguje sentyment per aspekt z wielu recenzji. | Context only – architektura agregacji sentymentu |
Czym różni się przepisywanie tytułów w ChatGPT od Google?
Google od lat przepisuje tytuły stron w wynikach wyszukiwania. W Merchant Center Google automatycznie ulepsza dane produktowe: poprawia ceny, dostępność i stan na podstawie structured data ze strony docelowej. W Merchant API finalny Product różni się od przesłanego ProductInput właśnie dlatego, że system przetwarza i normalizuje dane.
Różnica: Google przepisuje tytuły na podstawie algorytmów i structured data ze strony. ChatGPT przepisuje tytuły na podstawie modelu językowego i danych od wielu sprzedawców tego samego GTIN. Google generuje snippety z treści strony. ChatGPT generuje podsumowania opinii z publicznych stron z recenzjami. Skala ingerencji jest podobna, ale mechanizm i źródła się różnią.
Wspólny wniosek: ani w Google, ani w ChatGPT sklep nie ma gwarancji, że przesłany tytuł będzie wyświetlony dosłownie. Strategia „kontroluj dane wejściowe i monitoruj dane wyjściowe” jest fundamentem pozycjonowania sklepu internetowego – niezależnie od platformy.
Metodologia i źródła
Artykuł opiera się na analizie publicznej dokumentacji OpenAI, specyfikacji feedu Agentic Commerce Protocol i porównaniu z mechanizmami Google Merchant Center.
- Shopping with ChatGPT Search (weryfikacja: 17.08.2026).
- OpenAI Commerce – Products Feed Reference (weryfikacja: 17.08.2026).
- OpenAI Commerce – Best Practices (weryfikacja: 17.08.2026).
- OpenAI Commerce Policies.
- US8990224B1 – Replacing and/or enhancing titles and snippets.
- US20240386247A1 – Content generation faithfulness.
- US20230342411A1 – Multi-source consensus.
- US11379512B2 – Multi-type sentiment results.
Ograniczenia: Artykuł analizuje dokumentację i architekturę systemu. Algorytm generowania etykiet, upraszczania tytułów i agregacji opinii nie jest publiczny. Hipotezy robocze wymagają weryfikacji empirycznej. Badanie kontrolowane jest w fazie przygotowania.
Artykuł dotyczy organicznej prezentacji produktów w ChatGPT (shopping search). Mechanizmy reklamowe (ChatGPT Ads) i selekcja sprzedawcy dla tego samego GTIN są opisane w osobnych artykułach.
Etykiety i tytuły w ChatGPT – pytania z perspektywy sprzedawcy
Czy mogę kontrolować, jaki tytuł ChatGPT wyświetli dla mojego produktu?
Nie bezpośrednio. ChatGPT może uprościć lub przepisać tytuł z feedu. Możesz natomiast wpłynąć na to, co system ma do dyspozycji: umieść najważniejsze atrybuty różnicujące na początku tytułu w formacie [Marka] [Model] [Cecha] [Wariant].
Czy etykieta „Budget-friendly” oznacza, że mój produkt jest tani?
Nie. Etykieta „Budget-friendly” jest generowana przez model językowy i oznacza, że produkt został oceniony jako korzystny cenowo w kontekście danego zapytania. To porównanie względne, nie absolutne.
Czy mogę wpłynąć na podsumowanie opinii?
Pośrednio tak. ChatGPT generuje podsumowania na podstawie opinii z publicznych stron. Zadbaj o to, żeby opinie na Twojej stronie były strukturalne (aspektowe), aktualne i liczne.
Jak zgłosić błędne podsumowanie opinii?
OpenAI nie udostępnia dedykowanego mechanizmu zgłaszania błędnych podsumowań produktowych. Możesz zgłosić problem przez ogólny formularz feedback w ChatGPT.