Google od września 2026 serwuje narzędziom SEO fałszywe wyniki wyszukiwania — tzw. poisoned SERPs. W szczytowym momencie nawet 27% stron wyników zawierało podmienione pozycje organiczne. Efekt: SEMSTORM zamyka się 31 grudnia po 13 latach, Semrush rezygnuje z monitoringu Copilota, a Ahrefs publicznie przyznaje, że 5-20% danych w branży jest zatrutych. Jednocześnie narzędzia takie jak Senuto, DataForSEO czy AWR wdrożyły systemy detekcji i kontynuują działalność. Poniżej — mechanizmy, oś czasu, reakcje dostawców i praktyczne wnioski dla osób zarządzających widocznością w wyszukiwarkach.
Jakie trzy mechanizmy anty-scrapingowe wdrożyło Google?
Google nie wyłączyło dostępu do danych z dnia na dzień. Zbudowało wielowarstwowy system obrony, który stopniowo podnosił koszty automatycznego pobierania wyników — aż do momentu, w którym część firm nie była w stanie go udźwignąć finansowo.
Usunięcie parametru num=100
We wrześniu 2025 Google wyłączyło parametr num=100, który pozwalał pobrać sto wyników jednym zapytaniem. Od tego momentu każde zapytanie zwraca standardowe 10 pozycji. Dla narzędzi monitorujących tysiące fraz oznaczało to dziesięciokrotny wzrost liczby zapytań — a co za tym idzie, kosztów infrastruktury i proxy.
Przekierowania /goto
2 lipca 2026 Brodie Clark pierwszy zauważył nowy format linków w wynikach Google. 26 sierpnia 2026 Google oficjalnie potwierdziło wdrożenie przekierowań /goto — system, w którym każdy link w wynikach wyszukiwania prowadzi najpierw przez domenę google.com/goto, a dopiero stamtąd przekierowuje na docelową stronę. Token w adresie jest zaszyfrowany w Protocol Buffers i nie da się go zdekodować bez wykonania dodatkowego żądania HTTP.
W praktyce oznacza to, że pobranie pełnych adresów URL z jednej strony wyników wymaga od 10 do kilkudziesięciu dodatkowych requestów (w zależności od liczby SERP features — reklam, filmów, AI Overview). Jak podaje Parallel.ai, każde dodatkowe zapytanie to kolejna szansa na wykrycie i zablokowanie bota. Growtika przetestował 493 linki i potwierdził, że 100% z nich — organiczne, wideo, AI Overview, People Also Ask i reklamy — ukrywało docelowy adres.
Poisoned SERPs — zatruwanie wyników
Najpoważniejszy mechanizm pojawił się we wrześniu 2026. Google zaczęło serwować automatycznym narzędziom kompletne strony wyników, w których pozycje organiczne zostały podmienione na niezwiązane z zapytaniem — tzw. poisoned SERPs. W odróżnieniu od blokady (status 403 lub CAPTCHA), zatrute wyniki wyglądają normalnie i przechodzą standardowe walidacje: kod statusu 200, struktura HTML poprawna, odpowiednia liczba wyników.
Jak opisuje analiza Nozzle opublikowana na Search Engine Journal, normalne wyniki zachowują 88,5% tych samych domen przy powtórzeniu zapytania. Zatrute — tylko 20,7%. W zatrutych wynikach rzadziej pojawiają się AI Overviews (34,9% vs 54,2% w normalnych) i sekcje „Ludzie też pytają” (52,7% vs 87,2%), natomiast częściej trafiają się wyniki z Facebooka, Instagrama, LinkedIna i Reddita.
Jak przebiegał kryzys — oś czasu od pierwszych blokad do zamknięcia SEMSTORM?
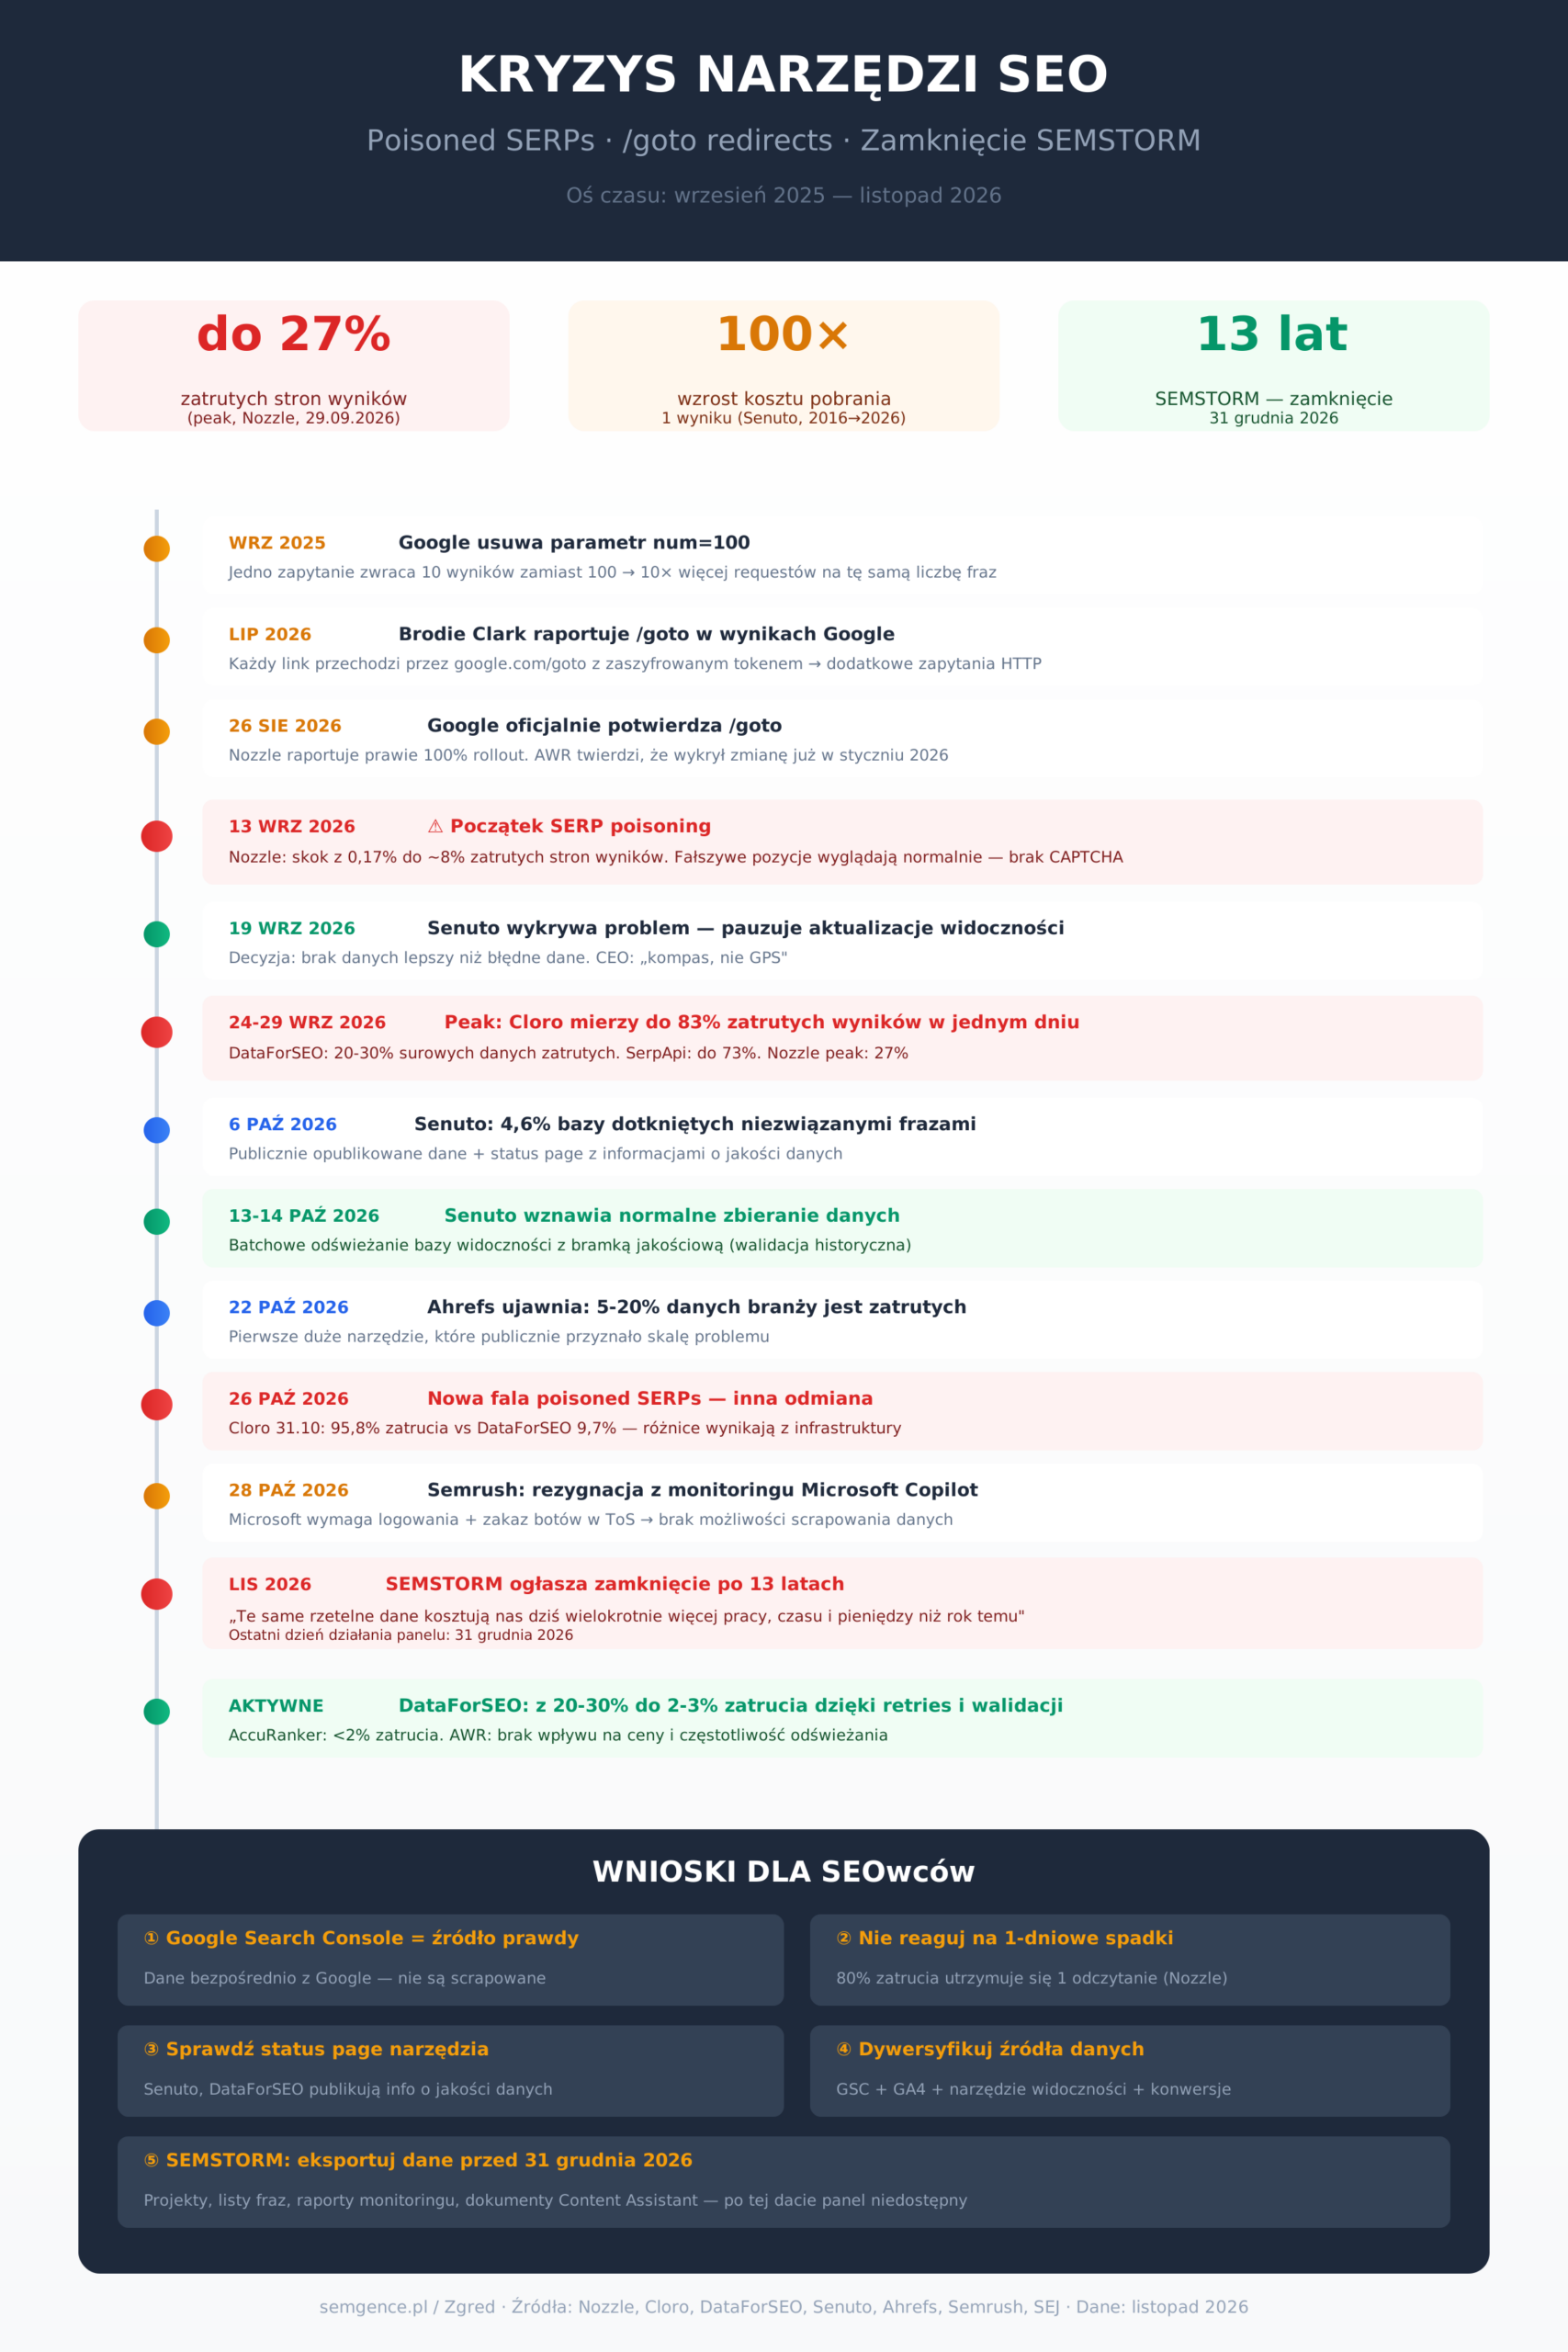
| Data | Wydarzenie |
|---|---|
| Wrzesień 2025 | Google usuwa parametr num=100 — 10× więcej zapytań na tę samą liczbę fraz |
| 2 lipca 2026 | Brodie Clark raportuje nowy format linków /goto w SERP |
| 26 sierpnia 2026 | Google oficjalnie potwierdza wdrożenie przekierowań /goto |
| 13 września 2026 | Nozzle rejestruje skok „zatrutych” stron wyników z 0,17% do ok. 8% |
| 19 września 2026 | Senuto wykrywa niezwiązane frazy w swoich danych — pauzuje aktualizacje widoczności |
| 20 września 2026 | Nozzle identyfikuje peak na poziomie 25% (potem szczyt 27% 29 września) |
| 24-29 września 2026 | Cloro mierzy 26,5% zatrutych wyników; SerpApi raportuje 73,2% |
| 26 września 2026 | DataForSEO zaczyna rejestrować problem — 20-30% wyników surowych |
| 30 września – 12 października 2026 | Cloro raportuje 71,5% zatrutych wyników (single days do 83%) |
| 6 października 2026 | Senuto potwierdza: 4,6% bazy dotkniętych niezwiązanymi frazami |
| 8 października 2026 | Lily Ray (Amsive): „rank trackery są w tym momencie zbyt zawodne”. Dr. Pete Meyers przekazuje MozCast |
| 10 października 2026 | Google zaczyna serwować mniej zatrutych wyników — chwilowy spadek |
| 13-14 października 2026 | Senuto wznawia normalne zbieranie danych; batchowe odświeżanie bazy |
| 22 października 2026 | Ahrefs publicznie ujawnia: 5-20% danych branży jest zatrutych |
| 26 października 2026 | Nowa fala poisoned SERPs — inna odmiana na page 1 |
| 28 października 2026 | Semrush informuje klientów o rezygnacji z monitoringu Copilota |
| Listopad 2026 | SEMSTORM ogłasza zamknięcie — ostatni dzień działania: 31 grudnia 2026 |
| 9 listopada 2026 | Semrush oficjalnie wyłącza tracking Microsoft Copilot |
Dlaczego SEMSTORM zamyka się po 13 latach działalności?
SEMSTORM, polskie narzędzie SEO działające od 2013 roku, ogłosiło zamknięcie z dniem 31 grudnia 2026. Panel będzie dostępny do 23:59 tego dnia — potem użytkownicy stracą dostęp do projektów, raportów i danych.
W komunikacie do użytkowników firma napisała: „Pisząc wprost: te same rzetelne dane kosztują nas dziś wielokrotnie więcej pracy, czasu i pieniędzy niż rok temu”. Rozważali kontynuację, ale musieliby albo „dawać dane z lukami, albo mocno podnieść ceny” — żaden z tych wariantów nie był do zaakceptowania.
SEMSTORM wymienia cztery fale ograniczeń ze strony Google, które narastały w ciągu ostatniego roku: dodatkowe zabezpieczenia anty-botowe, usunięcie parametru num=100, ukrycie adresów za przekierowaniami /goto oraz narzucenie nawet dwuminutowych opóźnień po pobraniu kilku linków z jednej strony wyników. Każda z tych zmian osobno byłaby do przejścia — ich kumulacja okazała się nie do udźwignięcia dla firmy tej skali.
Jak analizuje blog OkazWoka: „Google nie musi wyłączać narzędzi SEO. Wystarczy, że uczyni je wystarczająco drogim”. Auto-odnawianie subskrypcji zostało wyłączone w listopadzie — użytkownicy powinni jak najszybciej wyeksportować dane, raporty i listy fraz.
Ile błędnych wyników dziennie wykrywa SEOmonitor?
SEOmonitor odnotował błędne wyniki między 9 a 13 października — po tym jak od 8 października wcześniejsze wskaźniki jakości przestały łapać nowy typ zatrutych SERP-ów. Firma przefiltrowała dane za te dni, wdrożyła walidację opartą na porównaniu z historią frazy i szacuje, że ~8% dziennych wyników Google jest niekompletnych lub błędnych i wymaga re-pobrania. Wskaźnik flag rate AccuRanker dla desktop wyniósł 30,2% 25 września i spadł do 0,58% 17 października — dzięki systemowi „sandwich check”, który re-fetchuje stronę w nowej sesji przeglądarki, gdy na SERP-ie pojawia się mniej niż połowa zwykle widocznych domen.
Co ujawnił Ahrefs o skali zatrucia danych SEO?
22 października 2026 Ahrefs jako pierwsze z dużych narzędzi publicznie przyznało, że 5–20% wyników serwowanych dostawcom danych SEO jest zatrutych — w zależności od vendora i metody pomiaru. Firma dodała filtry odrzucające anomalne wyniki i uruchomiła czyszczenie danych historycznych. To ważny moment, bo Ahrefs jest jednym z trzech największych globalnych narzędzi SEO (obok Semrush i Moz) i jego otwartość pomogła branży zrozumieć skalę problemu.
Zanim Ahrefs zabrał głos, wielu SEOwców traktowało dziwne wahania pozycji we wrześniu jako efekt September Spam Update (wdrażany 24 września – 8 października). Ujawnienie Ahrefs pokazało, że część tych wahań nie miała nic wspólnego z algorytmem — były artefaktem zatrutych danych.
Dlaczego Semrush rezygnuje z monitoringu Microsoft Copilot?
Semrush — przejęty przez Adobe za 1,9 mld USD w kwietniu 2026 — poinformował 28 października klientów Enterprise AIO (AI Optimization), że od 9 listopada wyłącza tracking Microsoft Copilot. Powód: „Recent changes to Microsoft Copilot’s access requirements prevent AI visibility platforms” — nowe wymagania Microsoftu dotyczące obowiązkowego logowania, wprowadzone regulaminem z 18 sierpnia 2026, uniemożliwiają automatyczne zbieranie danych.
29 sierpnia Krishna Madhavan z Microsoftu potwierdził, że wszyscy użytkownicy Copilot będą musieli się logować. W Terms of Use jawnie zakazano dostępu botom i scraperom. Dla Semrush oznaczało to brak technicznej możliwości dalszego zbierania danych o tym, jakie marki i strony pojawiają się w odpowiedziach Copilota.
Klienci mogą zwrócić przydział promptów Copilot do ogólnej puli (i przekierować na ChatGPT lub Gemini) albo zachować historyczne dane — ale prompty nadal liczą się do limitu. Monitoring ChatGPT, Gemini i pozostałych silników AI nie zmienił się — choć dane AI Monitor pokazują, że widoczność w silnikach AI staje się osobnym KPI obok tradycyjnych pozycji. Jako alternatywne źródło danych o Copilot Semrush wskazuje Bing Webmaster Tools (panel AI Performance) oraz Microsoft Clarity (raport Citations) — oba jednak pokazują cytowania własnej strony, nie monitoring konkurencji.
Jak Senuto przetrwało kryzys zatrutych danych?
Senuto, największe polskie narzędzie do analizy widoczności, przeszło przez kryzys z otwartą komunikacją i jako jedno z niewielu narzędzi publicznie opisało cały przebieg zdarzenia. W szczegółowej analizie „Narzędzia SEO: kompas, nie GPS” Damian Sałkowski, CEO Senuto, opisał mechanizm, skalę i wnioski z perspektywy firmy, która zbiera dane SERP od dekady.
19 września 2026 narzędzie zaczęło zwracać frazy niezwiązane z monitorowanymi domenami. 21 września Senuto zapauzowało aktualizacje Analizy Widoczności — jak podkreśla Sałkowski: „Świadomie wybraliśmy brak nowych danych zamiast danych błędnych”. Kluczowa obserwacja: „Google nie odmawia odpowiedzi — zwraca kompletną, poprawnie wyglądającą stronę wyników, tylko że wyniki są fałszywe”. Dlatego mechanizm jest tak niebezpieczny — zatrute dane przechodzą standardowe walidacje i trafiają do raportów klientów.
Jak wyglądają zatrute wyniki w praktyce? Senuto pokazuje przykład frazy „skrzynki plastikowe na owoce 20 kg” — zamiast OLX i producentów opakowań, Google zwróciło narzędziu rozkład jazdy tramwaju nr 20 we Wrocławiu (wroclaw.pl), stycznik modułowy ST25-20 (fif.com.pl), „Grupę 20″ z Facebooka, obiektyw Sigma 20-200mm z YouTube i robota sprzątającego Roborock Saros 20. Jedynym wspólnym mianownikiem była liczba „20″ — algorytm zatruwający wyniki dopasowywał domeny po fragmentach zapytania, nie po intencji.
Wewnętrzne badanie Senuto wykazało, że 12-13% zbiorów TOP10 zawierało co najmniej jeden fałszywy wynik, a 8-9% miało trzy lub więcej. W teście powtarzalności (86 fraz pobranych 5-krotnie) żadna fraza nie była trwale zatruta — gdy jeden dostawca otrzymywał fałszywy wynik, ten sam query u innego dostawcy zwracał poprawne dane w 88% przypadków. Pierwsze ponowne pobranie naprawiało 86% przypadków z trzema lub więcej fałszywymi wynikami; piąte — 94%. To potwierdza, że zatrucie jest losowe, nie systemowe — ale nawet losowe błędy w 12% danych oznaczają realne ryzyko dla decyzji biznesowych.
6 października Senuto potwierdziło, że 4,6% bazy danych zostało dotkniętych niezwiązanymi frazami. Firma wdrożyła bramkę jakościową opartą na LLM (model sprawdza adekwatność wyników do frazy), re-fetching podejrzanych zapytań i usunięcie zatrutych fraz z Analizy Widoczności. Między 13 a 14 października monitoring zbierał dane normalnie, a baza była odświeżana partiami.
Senuto wdrożyło pięciostopniowy plan transparentności: (1) publiczny status zbierania danych na status.senuto.com z godzinowym odświeżaniem, (2) codzienny audyt jakości — zestaw testów sprawdzających zgodność z niezależnym pomiarem kontrolnym, stabilność pozycji i kompletność Monitoringu, z dwoma ocenami 0-100, (3) dostęp do surowych danych SERP w aplikacji, (4) program edukacyjny o pomiarze widoczności w erze AI, (5) przebudowana Analiza Widoczności z walidacją każdego odczytu przed wyświetleniem, metrykami porównywalnymi z Google Search Console i deduplikowaną bazą fraz. Na 2 listopada kroki 1 i 2 są aktywne. Klienci planów Lite i Basic otrzymali miesiąc darmowego dostępu do MCP; klienci Advanced i Prime — dodatkowe limity w Analizie Widoczności.
Co istotne — Senuto zbierało w 2016 roku ok. 1,8 miliona wyników na godzinę przy koszcie około 500 PLN miesięcznie. Dziś, po kolejnych ograniczeniach Google, jest to 120-200 tysięcy wyników na godzinę, a każdy pojedynczy wynik kosztuje ponad 100 razy więcej niż dekadę temu. Mimo to firma kontynuuje działalność — różnica w stosunku do SEMSTORM to prawdopodobnie skala i możliwość amortyzacji rosnących kosztów infrastruktury. Jak podsumowuje Sałkowski: publiczne dane marketingowe to „kompas, nie GPS” — pokazują kierunek, nie zawsze dokładną pozycję, a „narzędzia SEO znalazły się na proxy wojnie Google z dostawcami rozwiązań AI”.
Jak DataForSEO, Cloro i AccuRanker wykrywają zatrucie wyników?
DataForSEO, jeden z największych dostawców surowych danych SERP, od 26 września rejestruje 20-30% zatrutych wyników w surowych danych. Po wdrożeniu systemu retries i walidacji historycznej (porównanie z typowymi domenami dla danej frazy) udało się obniżyć poziom zatrucia do 2-3% — ale jak przyznaje CTO Oleksandr Nabatchikov, żadne z testowanych podejść nie jest w pełni niezawodne. Zbyt rygorystyczna walidacja odrzuca prawdziwe zmiany w rankingach; zbyt luźna przepuszcza zatrute wyniki.
Cloro, niezależna firma analityczna, przeprowadziła najbardziej szczegółowy pomiar: na stałym zestawie fraz monitorowanym od 1 września 2026 zarejestrowano skok z 2,9% (1-14 września) do 71,5% (30 września – 12 października), z rekordowym dniem 83%. Po interwencji Google 26 października wskaźnik spadł do 11,1% — ale już 31 października Cloro zanotowało ponowny wzrost do 95,8%. Co istotne, Cloro porównało wielu dostawców: tego samego dnia SerpApi miał 12% zatrucia, DataForSEO 9,7%, Oxylabs 96,8%. Różnice wynikają z metod detekcji i infrastruktury proxy.
AccuRanker podawał w połowie października mniej niż 2% zatrutych wyników. AWR (Advanced Web Ranking) twierdzi, że wykrył zmianę /goto już 19 stycznia 2026 — na siedem miesięcy przed oficjalnym potwierdzeniem Google — i zaadaptował swój system, nie podnosząc cen ani nie zmieniając częstotliwości odświeżania.
Co orzekł sąd w sprawie Google vs SerpApi i co to oznacza dla branży?
Równolegle do działań technicznych Google prowadzi również batalię prawną. 19 grudnia 2025 złożyło pozew przeciwko SerpApi (teksańska firma sprzedająca API do scrapowania wyników Google) na podstawie DMCA Section 1201 — tego samego przepisu, który chronił zaszyfrowane DVD przed piractwem. Google argumentowało, że SearchGuard „kontroluje dostęp do dzieła chronionego prawem autorskim” i że SerpApi to obchodzi.
20 lipca 2026 sędzia Yvonne Gonzalez Rogers (U.S. District Court, N.D. California, Case No. 25-cv-10826-YGR) oddaliła oba roszczenia DMCA. Kluczowy fragment wyroku: „SearchGuard nie może być uznany za system skutecznie kontrolujący dostęp do dzieła chronionego prawem autorskim”. Problem Google: wyniki wyszukiwania to mieszanka treści chronionych i niechronionych, a Google nie jest właścicielem praw do większości wyświetlanych stron. CEO SerpApi Julien Khaleghy skomentował: „to wygrana nie tylko dla SerpApi, ale dla wszystkich, którzy polegają na otwartym internecie”. Warto dodać kontekst: około 40% przychodów SerpApi pochodzi od firm AI — w tym od OpenAI — co tłumaczy, dlaczego Google traktuje scraping wyników jako zagrożenie strategiczne, nie tylko naruszenie regulaminu. Google złożyło poprawiony pozew 10 sierpnia 2026, tym razem zawężony do Knowledge Paneli i oparty na warunkach licencyjnych. Osobny pozew Reddita przeciwko SerpApi (też powołujący się na SearchGuard) jest w toku.
Dla branży SEO to ważny kontekst: Google równolegle blokuje scraping technicznie (poisoned SERPs, /goto, rate limiting) i próbuje go zakazać prawnie. Nawet jeśli pozew przeciwko SerpApi nie powiedzie się, efekt mrożący dla mniejszych graczy jest już widoczny.
Co oznacza wygaszenie Custom Search API i nowe Web Search Service API?
We wrześniu 2026 Google opublikowało — a potem szybko usunęło — dokumentację „Web Search Service API”. To płatne API partnerskie umożliwiające programistyczny dostęp do pełnych wyników wyszukiwania, dostępne tylko wybranym partnerom (prawdopodobnie Apple, duzi wydawcy). Dokumentacja pojawiła się ~22 sierpnia i została usunięta „hard 404, bez przekierowania, bez notatki” około 20 września. Manas Panda, który pierwszy ją zauważył, opisał to jako „nie zdeprekowane — skasowane”.
Równolegle Google wygasza Custom Search JSON API z deadline’em 1 stycznia 2027. To API — choć ograniczone do custom search engine, nie pełnych wyników — było jedyną oficjalną drogą do programistycznego dostępu do wyników Google. Po jego wygaszeniu rynek dzieli się na dwie klasy: partnerów z dostępem do Web Search Service API na warunkach indywidualnych umów i resztę branży zdaną na scraping lub dane first-party z Google Search Console.
Co powinni teraz zrobić SEOwcy i właściciele firm?
Kryzys narzędzi SEO nie oznacza, że pozycjonowanie stron przestało działać — oznacza, że zmienia się sposób, w jaki mierzymy jego efekty. Kilka praktycznych wniosków:
Google Search Console pozostaje źródłem prawdy. Dane o kliknięciach, wyświetleniach, CTR i średniej pozycji pochodzą bezpośrednio z Google — nie są scrapowane. Jeśli narzędzie pokazuje spadek pozycji, a GSC tego nie potwierdza, problem jest po stronie narzędzia, nie strony.
Nie reaguj na jednodniowe spadki. Badanie Nozzle pokazuje, że 80% zatrutych wyników utrzymuje się tylko przez jedno odczytanie. Jeśli fraza „spada” na jeden dzień i wraca — to z dużym prawdopodobieństwem artefakt, nie zmiana algorytmu.
Sprawdź status dostawcy. Przed podejmowaniem decyzji na podstawie danych widoczności (zmiana strategii, eskalacja do klienta) sprawdź status page narzędzia. Senuto uruchomiło dedykowaną stronę, DataForSEO publikuje analizy na blogu, a większość dostawców informuje o znanych problemach z danymi.
Dywersyfikuj źródła danych. Jedno narzędzie to za mało. Konfrontuj dane z monitoringu pozycji z Google Search Console, Google Analytics 4 i danymi o konwersjach. W erze zatrutych wyników narzędzie widoczności to kompas (jak mówi Senuto), nie GPS.
Przygotuj się na wzrost kosztów narzędzi. Jeśli pozyskanie danych SERP kosztuje dostawców 100× więcej niż dekadę temu, te koszty w końcu przełożą się na ceny subskrypcji. Narzędzia, które przetrwały (Senuto, Ahrefs, Semrush, AccuRanker), prawdopodobnie podniosą ceny lub ograniczą limity zapytań.
Migracja z SEMSTORM — ostatni termin: 31 grudnia. Użytkownicy SEMSTORM powinni do końca roku wyeksportować dane: projekty, listy fraz, raporty monitoringu i dokumenty z Content Assistant. Po tej dacie panel będzie niedostępny. Naturalnymi alternatywami na polskim rynku są Senuto (analiza widoczności) i Surfer SEO (optymalizacja treści). Niezależnie od narzędzia, audyt SEO strony powinien uwzględniać weryfikację źródeł danych o pozycjach.
Czym są poisoned SERPs i jak je odróżnić od prawdziwych zmian w rankingach?
Poisoned SERPs to fałszywe strony wyników wyszukiwania, które Google serwuje automatycznym narzędziom zamiast prawdziwych wyników. Wyglądają normalnie — mają kod statusu 200, poprawną strukturę HTML i standardową liczbę pozycji — ale ponad połowa domen jest podmieniona na niezwiązane z zapytaniem. Odróżnisz je od prawdziwych zmian sprawdzając Google Search Console: jeśli GSC nadal pokazuje wyświetlenia i kliknięcia na daną frazę, a narzędzie raportuje spadek, to z dużym prawdopodobieństwem artefakt zatrucia. Badanie Nozzle pokazuje, że 80% takich anomalii utrzymuje się tylko przez jedno odczytanie.
Czy SEMSTORM naprawdę się zamyka i co zrobić z danymi?
Tak. SEMSTORM potwierdził zamknięcie z dniem 31 grudnia 2026. Panel będzie dostępny do 23:59 tego dnia — potem nie będzie możliwości zalogowania się ani pobrania danych. Auto-odnawianie subskrypcji zostało wyłączone w listopadzie. Użytkownicy powinni jak najszybciej wyeksportować projekty, listy fraz, raporty monitoringu i dokumenty z Content Assistant. Osoby z przedpłaconą subskrypcją wykraczającą poza 31 grudnia mogą skontaktować się z firmą w sprawie proporcjonalnego zwrotu.
Które narzędzia SEO przetrwały kryzys i jak sobie radzą?
Senuto zapauzowało aktualizacje 21 września i wznowiło normalne zbieranie danych 13-14 października, wdrażając bramkę jakościową opartą na walidacji historycznej. DataForSEO obniżyło poziom zatrucia z 20-30% do 2-3% dzięki retries i porównaniu z typowymi domenami. AccuRanker raportuje poniżej 2% zatrutych wyników. AWR twierdzi, że wykrył /goto już w styczniu 2026 i zaadaptował system bez zmian cenowych. Ahrefs i Semrush kontynuują działalność, choć Semrush zrezygnował z monitoringu Microsoft Copilot od 9 listopada 2026.
Dlaczego Semrush zrezygnował z monitoringu Microsoft Copilot?
Microsoft od 18 sierpnia 2026 wymaga od użytkowników Copilot zalogowania się kontem Microsoft, a w warunkach użytkowania jawnie zakazuje dostępu botom i scraperom. Semrush nie był w stanie spełnić tych wymagań technicznych dla swojego systemu monitoringu AI visibility. Tracking ChatGPT, Gemini i pozostałych silników AI nie zmienił się. Alternatywne źródła danych o Copilot to Bing Webmaster Tools (panel AI Performance) i Microsoft Clarity (raport Citations), ale oba pokazują tylko cytowania własnej strony.
Czy Google może prawnie zakazać scrapowania wyników wyszukiwania?
Na razie nie. 20 lipca 2026 sędzia Yvonne Gonzalez Rogers (N.D. California) oddaliła roszczenia DMCA Google, stwierdzając że SearchGuard nie kontroluje dostępu do dzieła chronionego prawem autorskim. Google złożyło poprawiony pozew 10 sierpnia, zawężony do Knowledge Paneli — sprawa jest w toku. Niezależnie od wyniku, techniczne mechanizmy obrony (poisoned SERPs, /goto, rate limiting) skutecznie podnoszą koszty scrapowania i działają niezależnie od rozstrzygnięć prawnych.
Co powinien zrobić SEOwiec, który widzi dziwne spadki pozycji?
Krok 1: sprawdź Google Search Console — jeśli GSC pokazuje stabilne wyświetlenia i kliknięcia, spadek w narzędziu to prawdopodobnie artefakt. Krok 2: sprawdź status page dostawcy narzędzia (np. status.senuto.com). Krok 3: poczekaj 48 godzin — 80% zatrutych wyników utrzymuje się tylko jedno odczytanie. Krok 4: porównaj z danymi z GA4 (czy ruch organiczny faktycznie spadł). Dopiero po potwierdzeniu z wielu źródeł podejmuj decyzje strategiczne.
Co zrobiło Senuto po wykryciu zatrutych danych i czym jest plan „kompas, nie GPS”?
Senuto 21 września 2026 zapauzowało aktualizacje Analizy Widoczności — jako jedno z niewielu narzędzi wybrało brak danych zamiast błędnych. Wdrożyło bramkę jakościową opartą na LLM, re-fetching podejrzanych zapytań i pięciostopniowy plan transparentności: publiczny status zbierania danych, codzienny audyt jakości, dostęp do surowych SERP, program edukacyjny i przebudowaną Analizę Widoczności z walidacją krzyżową z GSC. Klienci otrzymali rekompensaty. CEO Damian Sałkowski określa dane widoczności jako „kompas, nie GPS” — pokazują kierunek, nie dokładną pozycję.