Klastry tematyczne (topical clusters) to jeden z fundamentów nowoczesnego SEO, którego znaczenie rośnie z każdą aktualizacją algorytmu. Google nie ocenia już pojedynczych podstron w oderwaniu od reszty serwisu – analizuje grupy tematycznie powiązanych treści i na tej podstawie przyznaje autorytet tematyczny (topical authority). Kiedy strona usługowa trafia do niewłaściwego klastra, traci widoczność na kluczowe frazy – nawet jeśli jej treść jest dobra.
W tym case study pokazujemy krok po kroku, jak zdiagnozowaliśmy i naprawiliśmy strukturę klastrów tematycznych na serwisie z ponad 30 stronami usługowymi, kilkudziesięcioma wpisami blogowymi i prawie 500 zaindeksowanymi podstronami. Opisujemy metodologię analizy (HDBSCAN + UMAP), metryki, które mierzymy (CCV, odległość od centroidu, kohezja klastra), oraz 5 strumieni naprawczych. Na końcu — twarde dane porównawcze z dwóch runów algorytmu, pokazujące, że strony wróciły do właściwych klastrów, a sygnały tematyczne dla Google stały się jednoznaczne.
Czym są klastry tematyczne i dlaczego mają znaczenie?
Klastry tematyczne to grupy podstron, które Google traktuje jako tematycznie spójne. Algorytm analizuje treść, linkowanie wewnętrzne i terminologię na podstronach, a następnie przyporządkowuje je do grup tematycznych. Im bardziej spójna jest grupa, tym silniejszy sygnał topical authority — i tym lepsze pozycje w wynikach wyszukiwania.
Żeby to zrozumieć, warto pomyśleć o klastrach jak o „prześwietleniu” serwisu z lotu ptaka. Zamiast analizować pojedyncze frazy kluczowe (jak robią to tradycyjne narzędzia SEO), analiza klastrów bada relacje między podstronami. Które strony Google grupuje razem? Dlaczego? Jak silna jest ich wzajemna przynależność?
Problem pojawia się, gdy strony usługowe mieszają się tematycznie. Jeśli strona o content marketingu zawiera za dużo terminologii SEO, Google może zaklasyfikować ją do klastra o pozycjonowaniu zamiast do klastra contentowego. Taka strona „kradnie” sobie nawzajem autorytet z innymi stronami w niewłaściwej grupie — i traci widoczność na frazy, na które powinna rankować.
W literaturze SEO mówi się o „wyciekach sygnałów tematycznych” (topical signal leaks). To sytuacja, w której strona A wysyła do algorytmu sygnały przynależności do klastra B, zamiast do klastra A, osłabiając oba klastry jednocześnie.
Dlaczego HDBSCAN + UMAP, a nie K-Means?
Większość narzędzi SEO, które oferują „analizę klastrów”, używa pod spodem algorytmu K-Means. To metoda klasteryzacji, która wymaga z góry określonej liczby klastrów (parametr k) i dzieli dane na k równych grup. Problem polega na tym, że K-Means zakłada, iż klastry są kuliste i mają zbliżoną wielkość — a serwisy tak nie wyglądają.
Na realnym serwisie jeden klaster (np. SEO) może mieć 40 podstron, a inny (np. reklamy w ChatGPT) — tylko 5. K-Means rozłoży je „na siłę” w klastry o zbliżonej liczności, łącząc tematy, które nie powinny być razem, albo rozbijając spójne grupy.
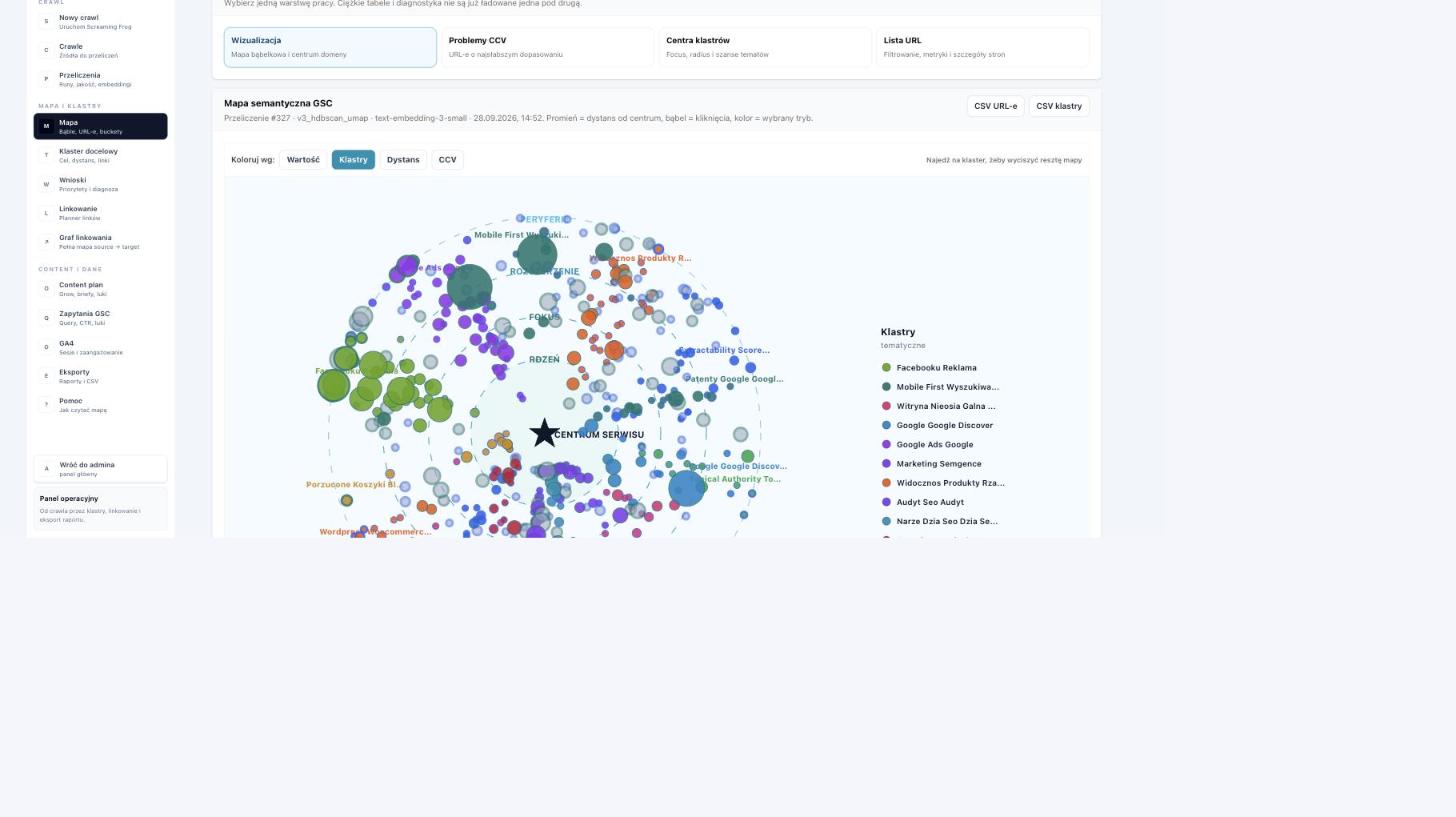
Do analizy klastrów stosujemy HDBSCAN (Hierarchical Density-Based Spatial Clustering of Applications with Noise) w połączeniu z UMAP (Uniform Manifold Approximation and Projection). To podejście ma fundamentalne przewagi nad K-Means:
HDBSCAN — klasteryzacja gęstościowa działa inaczej niż K-Means. Zamiast dzielić dane na z góry określoną liczbę grup, szuka obszarów o wysokiej gęstości (skupisk podstron, które są tematycznie blisko siebie) i oddziela je od obszarów o niskiej gęstości. Algorytm sam odkrywa liczbę klastrów na podstawie struktury danych, a klastry mogą mieć dowolną wielkość i kształt — tak jak na realnym serwisie. Co istotne, strony, które nie pasują do żadnego klastra, zostają oznaczone jako „szum” (noise), zamiast zostać na siłę przypisane do niewłaściwej grupy. To zasadnicza różnica w stosunku do K-Means, który zawsze przypisuje każdy punkt do jakiejś grupy — nawet jeśli to przypisanie jest mylące. Dodatkowo HDBSCAN buduje hierarchię klastrów, dzięki czemu widać relacje nadrzędne i podrzędne między tematami.
UMAP — redukcja wymiarowości to krok, który poprzedza właściwą klasteryzację. Każda podstrona jest reprezentowana jako wektor w przestrzeni wielowymiarowej (setki wymiarów odpowiadają terminologii, encjom, strukturze nagłówków i linkowaniu). UMAP redukuje tę przestrzeń do 2-5 wymiarów, zachowując przy tym lokalne relacje topologiczne — czyli to, które strony są „blisko siebie” tematycznie.
Dlaczego to ważne? Bo HDBSCAN pracuje na gęstości, a gęstość w przestrzeni wielowymiarowej jest matematycznie problematyczna (zjawisko tzw. „klątwy wymiarowości”). UMAP rozwiązuje ten problem, przekształcając dane do przestrzeni, w której gęstościowa klasteryzacja działa optymalnie.
Efekt? Algorytm „widzi” serwis mniej więcej tak, jak widzi go Google — jako grupy tematycznie powiązanych treści o zróżnicowanej wielkości i kształcie, z wyraźnymi granicami między klastrami i ze stronami, które nie pasują do żadnej grupy.
Content Context Vector (CCV) — jak mierzymy spójność treści?
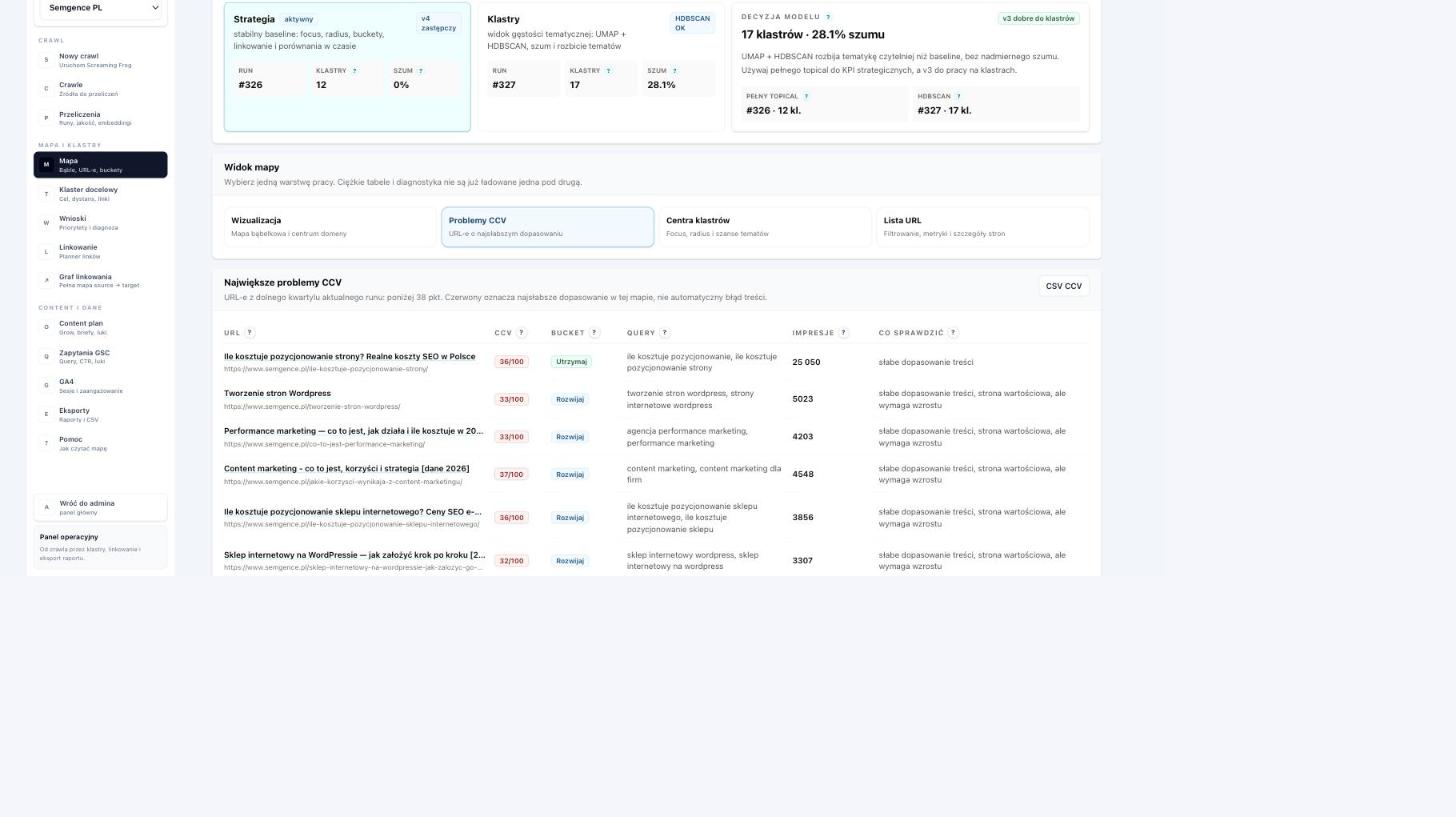
Samo przypisanie strony do klastra to dopiero początek. Kluczowe pytanie brzmi: jak silna jest przynależność danej strony do jej klastra? Odpowiada na to metryka, którą nazywamy Content Context Vector (CCV) — złożony wskaźnik spójności treści strony z klastrem, wyrażony w skali 0-100.
CCV to nie pojedynczy pomiar. To kompozyt kilku sub-skorów, z których każdy bada inny aspekt dopasowania strony do klastra. Sub-skor title_h1 mierzy zgodność tytułu strony z nagłówkiem H1 — niski wynik oznacza, że title tag i treść strony wysyłają różne sygnały. title_query i h1_query badają odpowiednio, jak dobrze tytuł i nagłówek H1 odpowiadają na frazy docelowe; rozbieżność między nimi to sygnał niespójności. text_query sprawdza pokrycie fraz docelowych w treści strony — niski wynik oznacza, że strona ma frazy w tytule, ale nie w body. Najważniejszy z sub-skorów to text_cluster, który mierzy, jak silnie terminologia strony pokrywa się z terminologią jej klastra — bezpośrednio wskazuje, czy strona jest „wciągana” do właściwego czy niewłaściwego klastra. Wreszcie hybrid_content to wynik hybrydowy łączący sygnały z treści, nagłówków i meta tagów, dający najbardziej całościowy obraz.
CCV na poziomie 70-100 oznacza silne dopasowanie strony do klastra. Wynik 40-70 to strefa ryzyka — strona jest w klastrze, ale sygnały są niejednoznaczne. Poniżej 40 — strona prawdopodobnie trafiła do niewłaściwego klastra lub jest na granicy dwóch klastrów.
Oprócz CCV analizujemy metryki na poziomie klastra. Odległość od centroidu pokazuje, jak blisko jest strona do „centrum” swojego klastra — im niższa wartość, tym silniejszy sygnał przynależności. Kohezja klastra (cohesion) mierzy, jak blisko siebie są wszystkie strony w grupie — niska kohezja oznacza klaster „rozmyty”, który może się rozpaść przy kolejnej aktualizacji algorytmu. Każda strona otrzymuje też klasyfikację roli: Core (fundament klastra, najbliżej centroidu), Focus (wzmocnienie, wspiera Core), Expansion (rozszerzenie tematyki) lub Outlier (na granicy klastra lub poza nim). Do tego dochodzi bucket — klasyfikacja biznesowa: Keep (mocna strona w dobrym klastrze), Grow (potencjał do wzmocnienia), Relocate (wymaga przeniesienia do innego klastra) lub Prune (do rozważenia usunięcia lub połączenia).
Jaki problem wykryliśmy?
Analiza klastrów na serwisie z ponad 30 stronami usługowymi ujawniła systemowy problem: kilkanaście kluczowych stron usługowych trafiło do niewłaściwych grup tematycznych. To nie były przypadkowe odchylenia — to był wzorzec.
Konkretne przypadki
Strona o content marketingu (CCV 49/100) — zamiast w klastrze contentowym, lądowała w klastrze „Marketing ogólny”. Analiza CCV wykazała, że sub-skor hybrid_content wynosił zaledwie 39.9/100, a w treści dominowały ogólne terminy marketingowe zamiast precyzyjnej terminologii contentowej. Strona używała słowa „SEO” w title tagu, co ciągnęło ją w kierunku klastra pozycjonerskiego.
Strona o pozycjonowaniu stron WWW (CCV 39/100) — zamiast w klastrze SEO, trafiała do klastra „Marketing i analityka”, a w późniejszych runach — do szumu (noise). Sub-skor text_cluster wynosił 0/100 — treść strony nie zawierała wystarczającej gęstości fraz bezpośrednio związanych z pozycjonowaniem stron WWW. To klasyczny przykład strony, która mówi „o pozycjonowaniu” zamiast „pozycjonowaniem”.
Strona o reklamach w ChatGPT (CCV 44/100 po optymalizacji) — lądowała w klastrze produktowym zamiast w klastrze Google Ads / PPC. Brak wystarczających sygnałów terminologicznych wiążących ją z reklamą płatną. Dodatkowo — w sekcji FAQ znajdowało się pytanie o audyt konta Google Ads, które wysyłało mylący sygnał tematyczny.
Strona o prowadzeniu bloga firmowego (CCV 45/100) — zamiast w klastrze Content Marketing, trafiała do klastra „Marketing i analityka”. Sub-skor hybrid_content 37.1/100. Treść strony nie miała wystarczającej gęstości fraz contentowych („strategia contentowa”, „plan contentowy”, „content marketing”).
Strony z cennikami — cennik pozycjonowania stron i cennik SEO e-commerce trafiały do jednego klastra, mimo że obsługują zupełnie inne segmenty klientów (B2B usługowe vs sklepy internetowe). Cennik stron WWW lądował w klastrze „Pozycjonowanie Sklepu” z flagą outlier=true.
6 stron contentowych — rozrzuconych po 3 różnych klastrach, bez dedykowanego klastra „Content”. Strona o usługach copywriterskich nie miała ani jednego linku wewnętrznego z body innych podstron — algorytm nie miał żadnego sygnału linkowania, który mógłby ją przypisać do grupy.
Strona o pozycjonowaniu lokalnym — trafiła do klastra „Google LinkedIn” (sic!) zamiast do klastra pozycjonerskiego. Terminologia była przestarzała (wielokrotne użycie „Google Moja Firma” zamiast aktualnej nazwy „Profil Firmy w Google”).
Wspólny wzorzec
Analiza ujawniła trzy główne przyczyny błędnej klasteryzacji. Pierwsza to mieszanie terminologii — strony usługowe używały fraz z obcych klastrów, przez co Google otrzymywał niejednoznaczne sygnały. Strona o content marketingu pełna terminów SEO to klasyczny przykład: algorytm nie wie, czy przypisać ją do klastra contentowego, czy pozycjonerskiego. Druga przyczyna to brak sygnałów linkowania wewnętrznego. Strony, które powinny tworzyć jedną grupę tematyczną, po prostu do siebie nie linkowały. Bez tych sygnałów algorytm nie miał podstaw, by je zgrupować — nawet jeśli tematycznie były blisko. Trzecia przyczyna to historyczne artefakty: przestarzała terminologia (np. „Google Moja Firma” zamiast „Profil Firmy w Google”), pytania FAQ z obcych tematów czy meta opisy z nieaktualnymi latami, które zaburzały kontekst semantyczny strony.
Jak przebiegała diagnostyka?
Diagnoza opierała się na pełnym przebiegu algorytmu HDBSCAN + UMAP na danych z crawla serwisu (blisko 500 zaindeksowanych URL-i). Automatyczny crawler przeszedł cały serwis, zbierając treść, nagłówki, meta tagi, linkowanie wewnętrzne i terminologię każdej podstrony. Następnie każda podstrona została zamieniona na wektor numeryczny (embedding) uwzględniający tytuł, H1, treść, frazy kluczowe z nagłówków i terminologię — proces zwany wektoryzacją.
Na tak przygotowanych danych UMAP przeprowadził redukcję wymiarowości — z setek wymiarów do 2-5, przy zachowaniu lokalnych relacji topologicznych. Dzięki temu wektory zostały przekształcone do przestrzeni, w której algorytm gęstościowy działa optymalnie. Kolejny krok to właściwa klasteryzacja: HDBSCAN zidentyfikował 16 klastrów tematycznych na serwisie (w późniejszym runie — 18). Dla każdej strony obliczony został Content Context Vector z 6 sub-skorami. Na końcu — strony z niskim CCV, flagą outlier lub przypisaniem do niewłaściwego klastra trafiły na listę do naprawy.
Kluczowe metryki bazowe (run #310, 23 września):
| Metryka | Wartość bazowa |
|---|---|
| Liczba klastrów | 16 |
| Zaindeksowane strony | 475 |
| Średnia jakość klastrów | 35.5 |
| Core+Focus click share | 49.6% |
| Promień stron usługowych | 0.957 |
| Frazy dopasowane | 150 |
| Frazy niedopasowane | 31 |
Jakie działania naprawcze podjęliśmy?
Optymalizacja objęła 5 równoległych strumieni pracy. Każdy z nich adresował inny aspekt problemu z klastrami. Łącznie zmodyfikowano ponad 90 podstron.
1. Dywersyfikacja semantyczna treści
Główna przyczyna błędnej klasteryzacji to mieszanie terminologii. Strona o content marketingu, która wielokrotnie używa słowa „pozycjonowanie”, wysyła Google mieszany sygnał. Dlatego na każdej z problematycznych stron usługowych przeprowadziliśmy precyzyjną wymianę terminologii.
Na stronie o prowadzeniu bloga firmowego zwiększyliśmy gęstość fraz „content marketing”, „strategia contentowa” i „plan contentowy”, jednocześnie usuwając powtórzenia „pozycjonowanie” i „SEO”, które nie były kluczowe dla tematu strony. Usunęliśmy też zbędne wstawki brandingowe, które nie wnosiły wartości semantycznej.
Na stronie o pozycjonowaniu stron WWW — sub-skor text_cluster wynosił 0/100, co oznaczało, że treść strony nie zawierała wystarczająco dużo fraz bezpośrednio związanych z pozycjonowaniem. Wzmocniliśmy gęstość: „audyt SEO” (z 2 do 6 wystąpień), „audyt techniczny” (z 1 do 4), „pozycjonowanie stron WWW” (z 1 do 6). Zmieniliśmy też H1 — z ogólnego „Pozycjonowanie stron internetowych oparte na audycie, danych i celach biznesowych” na bardziej precyzyjne „Pozycjonowanie stron WWW – audyt SEO, optymalizacja i strategia linkbuildingu”.
Na stronie o reklamach w ChatGPT — usunęliśmy FAQ z pytaniem o audyt konta Google Ads (sygnał z klastra SEO/audytowego) i zastąpiliśmy go pytaniami stricte o reklamy ChatGPT. Wzmocniliśmy terminologię PPC: „Google Ads” (14 wystąpień), „kampanie reklamowe” (7), „PPC” (5), „reklama PPC” (3), „budżet reklamowy” (3), „kampanie płatne” (4).
Na cennikach — cennik pozycjonowania stron otrzymał sekcję „Dla kogo” skoncentrowaną na firmach B2B i usługowych, tabelę porównawczą „strona vs sklep” oraz 3 FAQ (wielojęzyczne, skuteczność, WordPress). Cennik SEO e-commerce — sekcję „Dla jakich sklepów” o platformach e-commerce, sekcję feed/schema produktowych oraz 4 FAQ (duży asortyment, sezonowość, feed Shopping, duplikacja wariantów). Dzięki temu oba cenniki budują autorytet we właściwych klastrach.
Na stronie o pozycjonowaniu lokalnym — zaktualizowaliśmy przestarzałą terminologię: 11 wystąpień „Google Moja Firma” zostało zamienionych na aktualne „Profil Firmy w Google”. Zmieniliśmy nagłówek H2 na „Profil Firmy w Google – korzyści dla biznesu lokalnego”.
2. Strategia linkowania wewnętrznego page-to-page
Linkowanie wewnętrzne to jeden z najsilniejszych sygnałów klastrowych. Google analizuje, które strony do siebie linkują, i na tej podstawie buduje grupy tematyczne. Algorytm traktuje link jako głos — strona A linkuje do strony B, bo uważa ją za tematycznie powiązaną.
Na każdym klastrze stworzyliśmy siatkę cross-linków między stronami usługowymi w formie stylizowanych kart nawigacyjnych. Każda strona otrzymała sekcję ze kartami „Inne usługi” (contentowe / SEO / reklamowe / e-commerce — w zależności od klastra) z linkami do wszystkich pozostałych stron z tego samego klastra.
Kluczowa zasada: linki tylko wewnątrz klastra, nigdy między klastrami. Strona o content marketingu linkuje do stron o copywritingu, audycie treści, prowadzeniu bloga — ale nie do stron o pozycjonowaniu czy Google Ads. Takie linkowanie wzmacnia sygnał przynależności do grupy.
Struktura cross-linków objęła 6 klastrów:
| Klaster | Strony | Cross-linki |
|---|---|---|
| Content | 6 stron | 5 kart na stronę |
| SEO | 6 stron | 5 kart na stronę |
| PPC | 4 strony | 3 karty na stronę |
| E-commerce | 5 stron | 4 karty na stronę |
| AI | 2 strony | 2 karty na stronę |
| Platformy e-commerce | 7 stron | 6 kart na stronę |
Osobnym krokiem było naprawienie strony o usługach copywriterskich, która nie miała ani jednego linku wewnętrznego z body innych podstron. Po dodaniu cross-linków na wszystkich 6 stronach contentowych, ta strona otrzymała 5 nowych linków kontekstowych.
3. Wzbogacenie treści o sekcje FAQ
Sekcje FAQ z prawidłowym schematem FAQPage pełnią podwójną rolę w kontekście klasteryzacji. Z jednej strony wzbogacają treść o dodatkową terminologię klastrową — pytania i odpowiedzi naturalnie wprowadzają frazy long-tail związane z tematem strony, wzmacniając sygnał przynależności do klastra. Z drugiej strony generują rich snippets w SERP — pytania z FAQ mogą pojawić się bezpośrednio w wynikach wyszukiwania, zwiększając CTR i dodatkową widoczność.
Na stronach, które nie miały FAQ, stworzyliśmy sekcje z 3-6 pytaniami. Na stronach, które miały FAQ, ale z pytaniami z obcych klastrów (jak wspomniane pytanie o Google Ads na stronie AI), podmieniliśmy pytania na tematycznie właściwe.
Przykład: na stronie o audycie widoczności w AI usunęliśmy pytanie „Mam małe konto z 1-2 kampaniami — czy audyt się opłaca?” (terminologia Google Ads) i zastąpiliśmy je pytaniem „Czy audyt AI visibility ma sens dla małej strony firmowej?” (terminologia AI).
4. Odświeżenie treści blogowych
Blog to zaplecze tematyczne dla stron usługowych. Jeśli wpisy blogowe mają niski CCV (Content Context Vector), osłabiają cały klaster — bo algorytm uwzględnia je przy obliczaniu kohezji grupy.
Odświeżyliśmy 12 wpisów blogowych o najniższych wynikach CCV (zakres 32-38/100). Na każdym wpisie zaktualizowaliśmy meta tagi (title i description) z aktualnym rokiem, dodaliśmy bezpośrednie odpowiedzi na pytania z nagłówków H2 w formacie „question-first answer” — od razu odpowiedź na pytanie z nagłówka, zanim rozwinięcie tematu. Wzbogaciliśmy treści o encje branżowe (Core Web Vitals, Domain Authority, Schema.org, E-E-A-T i inne), rozbudowaliśmy lub stworzyliśmy od zera sekcje FAQ (4-6 pytań per post) oraz dodaliśmy linki wewnętrzne z wpisów do stron usługowych (blog → page). Łącznie wykonaliśmy ponad 130 indywidualnych zmian w treści na 12 wpisach blogowych.
5. Macierz linkowania blog-to-blog dla klastra AI
Osobnym wyzwaniem był klaster AI — strony o pozycjonowaniu w AI i audycie widoczności w AI nie miały dedykowanego klastra. Blogi o tematyce AI (ponad 50 wpisów) były rozproszone i słabo ze sobą powiązane. Wskaźnik same_cluster (procent stron z tego samego tematu, które trafiają do jednego klastra) wynosił zaledwie 17.1%.
Stworzyliśmy macierz linkowania: 55 wpisów blogowych podzielonych na 6 grup tematycznych:
| Grupa | Temat | Liczba wpisów |
|---|---|---|
| A | AI Visibility & Monitoring | 7 |
| B | AI Search & Retrieval | 12 |
| C | AI Commerce & E-commerce | 21 |
| D | AI Technical | 4 |
| E | AI Content Quality | 5 |
| F | AI Trends & Strategy | 4 |
Każdy wpis otrzymał 2-3 linki do wpisów z pokrewnych grup. Łącznie dodaliśmy około 117 nowych linków wewnętrznych blog-to-blog. Cel: podniesienie same_cluster z 17% do ponad 50%, co powinno umożliwić HDBSCAN wyodrębnienie dedykowanego klastra AI.
Wyniki: porównanie run #310 vs #327
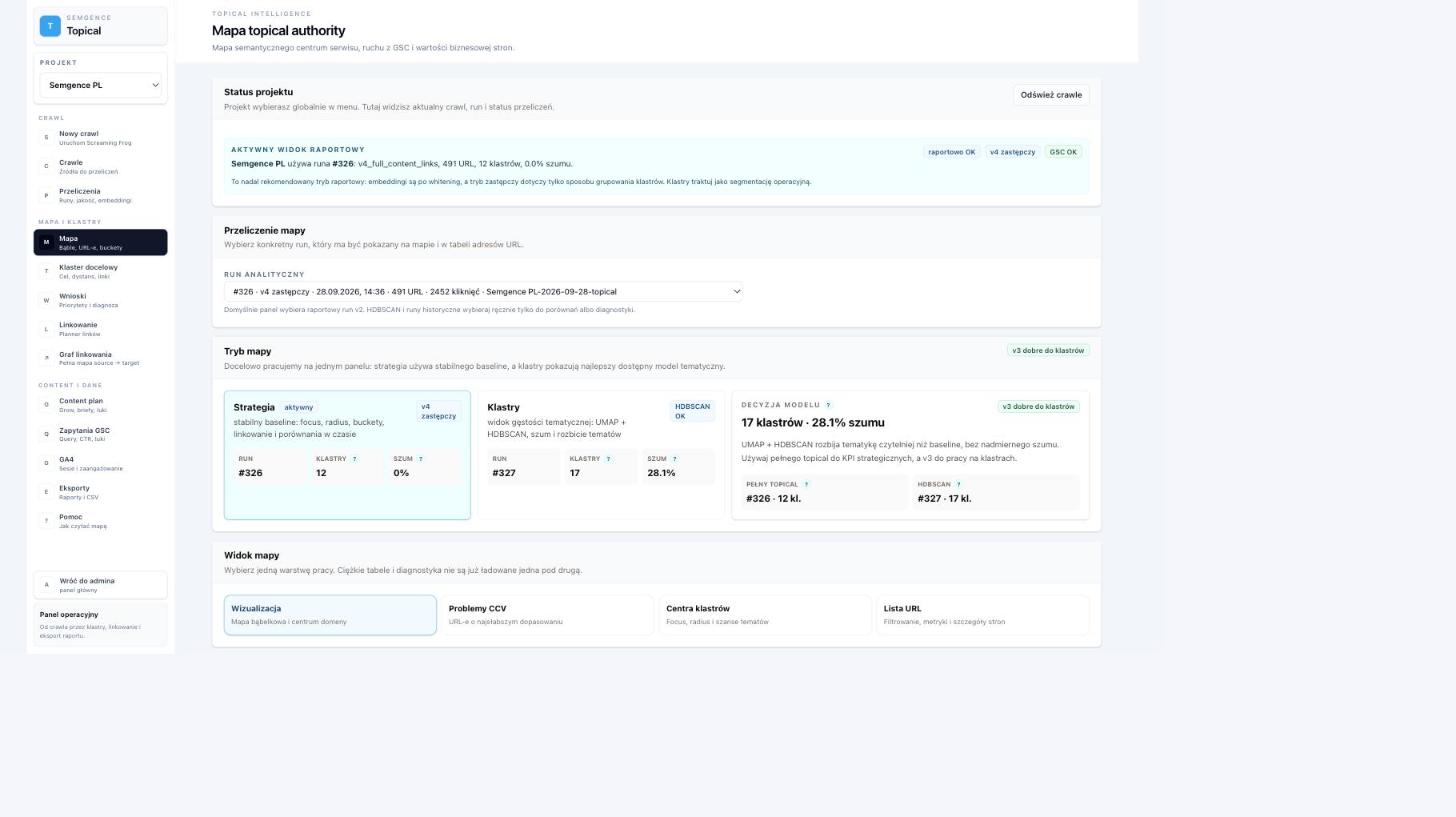
Porównanie dwóch runów algorytmu — bazowego (#310 z 23 września) i aktualnego (#327 z 28 września) — pokazuje wyraźne, mierzalne przesunięcia.
Metryki zagregowane
| Metryka | Run #310 (przed) | Run #327 (po) | Zmiana |
|---|---|---|---|
| Liczba klastrów | 16 | 18 | +2 nowe klastry |
| Zaindeksowane strony | 475 | 491 | +16 stron |
| Średnia jakość klastrów | 35.5 | 36.3 | +0.8 |
| Core+Focus click share | 49.6% | 58.4% | +8.8 pp |
| Promień stron usługowych | 0.957 | 0.947 | −0.010 (lepiej) |
| Promień stron business-value | 0.958 | 0.947 | −0.011 (lepiej) |
| Frazy dopasowane | 150 | 169 | +19 |
| Frazy niedopasowane | 31 | 27 | −4 |
Co oznaczają te liczby?
Core+Focus click share +8.8 punktów procentowych — to kluczowa metryka. Oznacza, że strony w roli Core (fundament klastra) i Focus (wzmocnienie klastra) odpowiadają teraz za 58.4% kliknięć z wyników wyszukiwania, zamiast 49.6%. Przesunięcie blisko 9 punktów procentowych w 5 dni to wyraźny sygnał, że strony przesunęły się bliżej centrów swoich klastrów.
Promień stron usługowych −0.010 — niższy promień oznacza, że strony usługowe (money pages) są bliżej centroidów swoich klastrów. Innymi słowy — sygnały tematyczne stały się bardziej jednoznaczne.
+19 fraz dopasowanych, −4 frazy niedopasowane — algorytm znalazł 19 nowych fraz kluczowych, które poprawnie przypisał do stron, i poprawił 4 wcześniejsze błędy przypisania.
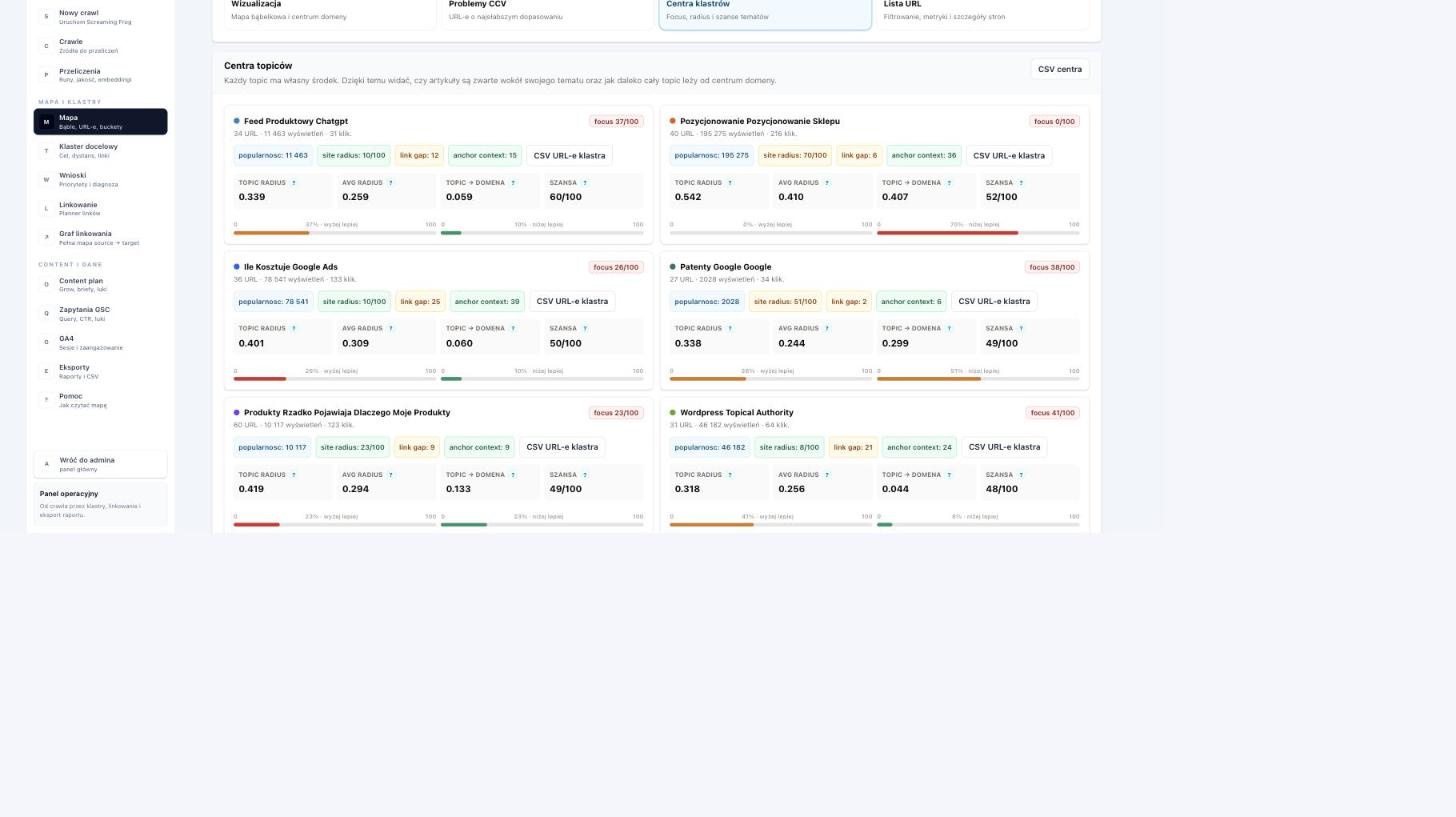
+2 nowe klastry — to jeden z najważniejszych efektów. HDBSCAN sam odkrył dwa nowe klastry, których wcześniej nie wyodrębniał:
Nowe klastry
[2] „Content Content Marketing” — 25 stron, jakość 29.2, szansa (opportunity) 57.2, kohezja 0.560. To klaster, którego wcześniej brakowało — strony contentowe były rozproszone po 3 różnych klastrach. Po dodaniu cross-linków page-to-page i wzmocnieniu terminologii, HDBSCAN wyodrębnił je jako spójną grupę.
[16] „Extractability Score Accuracy” — 21 stron skupionych wokół tematyki AI. To wczesna forma klastra AI, który powinien dalej się krystalizować po przeindeksowaniu macierzy blog-to-blog.
Przesunięcia poszczególnych stron
| Strona | Klaster PRZED | Klaster PO | Status |
|---|---|---|---|
| Prowadzenie bloga firmowego | Marketing i analityka | Content Marketing | ✅ Naprawione |
| Reklamy w ChatGPT | Klaster produktowy | Google Ads | ✅ Naprawione |
| Pozycjonowanie stron WWW | Marketing i analityka | Pozycjonowanie | ✅ Naprawione |
| Pozycjonowanie lokalne | Google LinkedIn | Pozycjonowanie | ✅ Naprawione |
| Strony contentowe (6 szt.) | 3 różne klastry | Content Marketing | ✅ Formują klaster |
| Cenniki | Jeden wspólny klaster | Osobne klastry | ✅ Rozdzielone |
Strony wymagające dalszej pracy
Nie wszystkie strony osiągnęły docelowy klaster w pierwszym cyklu. Dwie strony wymagają dodatkowej iteracji:
Strona o content marketingu — pomimo wzrostu CCV z ~35 do 49/100, wciąż trafia do klastra „Marketing” zamiast do dedykowanego klastra Content. Wynik hybrid_content (39.9) wskazuje, że terminologia contentowa wymaga dalszego wzmocnienia.
Strona o pozycjonowaniu stron WWW — CCV wzrosło do 39/100, ale strona nadal jest w szumie (noise). Sub-skor text_cluster na poziomie 0/100 sugeruje, że treść strony wymaga jeszcze bardziej precyzyjnej terminologii pozycjonerskiej.
To normalne zachowanie algorytmu gęstościowego. HDBSCAN wymaga, żeby strona znajdowała się w obszarze o dostatecznie wysokiej gęstości, żeby zostać przypisana do klastra. Strony na granicy potrzebują silniejszych sygnałów — zarówno z treści, jak i z linkowania — żeby „przejść próg gęstości”.
Pełne efekty — kiedy i jak mierzyć?
Optymalizacja klastrów tematycznych to proces iteracyjny, a nie jednorazowa operacja. Oto dlaczego:
Google potrzebuje czasu na re-crawl i re-indeksację. Nawet z IndexNow (który przyspiesza wykrywanie zmian), pełna re-indeksacja serwisu z 500 podstronami zajmuje 2-4 tygodnie.
Algorytm re-evaluacji jest wieloetapowy. Google najpierw przeindeksuje zmienione strony, potem ponownie obliczy sygnały tematyczne, a na końcu — zaktualizuje pozycje. Cały cykl trwa 4-8 tygodni.
Analiza klastrów powinna być powtarzana. Zalecamy analizę po każdej większej zmianie na serwisie — dodaniu nowych stron usługowych, przebudowie bloga, migracji — oraz regularny monitoring raz w miesiącu.
Drugie i trzecie iteracje przynoszą skokowe efekty. Pierwsza iteracja naprawia najpoważniejsze problemy (błędne klastry). Druga — doprecyzowuje strony, które są „na granicy”. Trzecia — optymalizuje kohezję klastrów i wzmacnia strony Core.
W opisywanym case study zmiany zostały zgłoszone do wyszukiwarek przez IndexNow. Pierwsze efekty w postaci przesunięć klastrowych (mierzone naszym algorytmem) pojawiły się w ciągu 5 dni. Efekty na ruch organiczny (mierzone w Google Search Console) — oczekujemy w ciągu 4-8 tygodni.
Co to oznacza dla Twojego serwisu?
Jeśli prowadzisz serwis z wieloma stronami usługowymi i blogiem, prawdopodobnie masz podobny problem — po prostu o nim nie wiesz. Tradycyjne narzędzia SEO analizują frazy kluczowe i pozycje, ale nie pokazują, jak Google grupuje Twoje podstrony tematycznie.
Typowe symptomy problemów z klastrami to sytuacje, w których strony usługowe nie rankują na oczywiste frazy mimo dobrej treści, dwie strony konkurują o te same frazy (kanibalizacja), widoczność nagle spada po dodaniu nowych podstron, blog „nie pomaga” stronom usługowym mimo regularnego publikowania, albo strony z cennikami lub wariantami usług mieszają się tematycznie. Każdy z tych objawów może wskazywać na „wycieki sygnałów tematycznych” — strony, które osłabiają się nawzajem zamiast wspierać.
Diagnoza klastrów tematycznych pozwala znaleźć te wycieki i naprawić je precyzyjnymi zmianami w treści i linkowaniu — bez pisania wszystkiego od nowa. Jeśli chcesz sprawdzić, jak wyglądają klastry tematyczne na Twoim serwisie — skontaktuj się z nami. Analiza klastrów to jeden z elementów naszego podejścia do strategii contentowej i pozycjonowania stron.
FAQ
Ile czasu zajmuje optymalizacja klastrów tematycznych?
Zależy od skali serwisu. W opisanym case study cały proces – od diagnozy przez wdrożenie zmian na ponad 90 podstronach – zajął około tygodnia intensywnej pracy. Mniejsze serwisy z 10-15 stronami usługowymi można zoptymalizować w 2-3 dni.
Czy muszę przepisywać treści od zera?
Nie. W większości przypadków wystarczą precyzyjne zmiany terminologii (wzmocnienie fraz z właściwego klastra, usunięcie fraz z obcych klastrów), dodanie brakujących sekcji (np. FAQ ze schematem FAQPage) i korekta linkowania wewnętrznego. W naszym case study żadna strona nie wymagała przepisania od zera – zmiany polegały na edycji istniejącej treści.
Czym HDBSCAN różni się od analizy słów kluczowych?
Tradycyjna analiza skupia się na pojedynczych frazach – czy strona X rankuje na frazę Y? HDBSCAN analizuje relacje między stronami i grupuje je w klastry na podstawie podobieństwa semantycznego. To pozwala wykryć problemy, które są niewidoczne na poziomie pojedynczych fraz – np. stronę, która rankuje na właściwe frazy, ale jest przypisana do niewłaściwego klastra i traci autorytet tematyczny.
Jak sprawdzić, czy mój serwis ma problem z klastrami?
Symptomy to: strony usługowe, które nie rankują na oczywiste frazy mimo dobrej treści; kanibalizacja – dwie strony konkurują o te same frazy; nagły spadek widoczności po dodaniu nowych podstron. Precyzyjna diagnoza wymaga analizy algorytmicznej z wykorzystaniem HDBSCAN lub podobnego podejścia klasteryzacyjnego – tradycyjne narzędzia SEO tego nie oferują.
Czy optymalizacja klastrów dotyczy też sklepów internetowych?
Tak, i to w szczególny sposób. Sklepy internetowe mają typowo setki lub tysiące stron produktowych i kategorii, które łatwo się mieszają tematycznie. Prawidłowa struktura klastrów jest kluczowa dla widoczności kategorii produktowych.
Jak często trzeba analizować klastry tematyczne?
Rekomendujemy analizę po każdej większej zmianie na serwisie – dodaniu nowych stron usługowych, przebudowie bloga, migracji – oraz regularny monitoring raz na miesiąc lub kwartał.
Czy linkowanie między klastrami jest szkodliwe?
Nie jest szkodliwe w sensie kary, ale osłabia sygnały klastrowe. Zasada jest prosta: strony usługowe linkują do stron z tego samego klastra (page-to-page). Blog może linkować do dowolnej strony usługowej (blog-to-page) – to nie zaburza klasteryzacji, bo algorytm traktuje blog jako zaplecze autorytetu.
Czy HDBSCAN to standard branżowy w SEO?
HDBSCAN + UMAP to podejście, które zyskuje na popularności w zaawansowanym SEO technicznym, ale nie jest jeszcze standardem branżowym. Większość narzędzi SEO wciąż opiera się na K-Means lub prostszych metodach klasteryzacji. Przewaga HDBSCAN polega na tym, że nie wymaga z góry określonej liczby klastrów, obsługuje klastry o różnej wielkości i identyfikuje szum – czyli strony, które nie pasują do żadnego klastra.